
JVM Compressed OOPs
Compressed OOPs란 무엇인가?
OOPs(Ordinary Object Pointers)는 JVM 내부에서 힙 객체의 참조 주소를 가리키는 포인터를 뜻합니다.
자바 코드에서 new Object()로 생성된 객체의 메모리 주소를 가리키는 내부 포인터입니다.
Compressed OOPs는 이름에서 알 수 있듯 "압축된 포인터"로 이해할 수 있는데요.
32비트 시스템과 64비트 시스템을 중심으로 이에 대해 알아봅시다.
32비트 vs 64비트
32비트 시스템
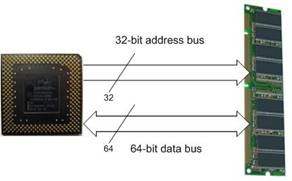
- 32비트 주소 버스와 64비트 데이터 버스를 가지는 Pentium -
32비트 CPU는 주소 버스(Address Bus) 폭이 32비트입니다. (레지스터 폭과 주소 버스 폭이 다른 CPU 아키텍처도 존재하나 예외로 생각하겠습니다.) 즉, 한 번에 32개의 비트를 사용해 메모리의 주소를 지정할 수 있습니다.
2^32 = 4,294,967,296 byte = 4GB
이 말은 CPU가 직접 접근할 수 있는 물리적 메모리 주소가 4GB 범위라는 뜻이고 이 주소를 전부 커버하기 위해서는 주소 버스 폭과 동일하게 4바이트(32비트) 포인터(OOPs)가 필요합니다.
32비트 시스템에서 주소는 다음과 같이 표현됩니다:
0x7FFF_FFFF (최대 표현 가능한 메모리: 4GB)
8바이트 자료형인 double 을 메모리상에 저장한다고 가정해봅시다.
0x7FFF_FFF8
0x7FFF_FFF9
0x7FFF_FFFA
0x7FFF_FFFB
...
...
0x7FFF_FFFE
0x7FFF_FFFF
각 주소 포인터는 1바이트씩을 나타내므로, 위와 같이 8개의 주소 공간을 차지하게 될 것입니다.
64비트 시스템
64비트 CPU는 주소 버스(Address Bus) 폭이 64비트입니다.
즉, 한 번에 64개의 비트를 사용해 메모리의 주소를 지정할 수 있습니다.
2^64 = 16,777,216 TB (약 16 ExaByte)
이론적으로는 16EB의 메모리 공간에 접근할 수 있지만, 실제 하드웨어나 운영체제는 이 전체 공간을 전부 활용하지 않습니다.
예를 들어, 대부분의 x86-64 아키텍처는 **48비트 논리 주소(256TB)**까지만 사용합니다.
이제 중요한 차이점이 생깁니다.
64비트 주소를 표현하려면 포인터(즉, OOPs)의 크기가 주소 버스 폭과 동일하게 8바이트(64비트)가 되어야 합니다.
그 결과:
- 객체 참조 필드, 배열 요소, 객체 헤더 등 포인터를 포함하는 모든 데이터 구조의 크기가 증가합니다.
- 동일한 데이터를 저장하더라도 32비트 JVM보다 메모리를 약 30~40% 더 많이 사용하게 됩니다.
- 이는 CPU 캐시 효율(CPU Cache Locality)에도 부정적인 영향을 줍니다.
이런 비효율을 해결하기 위해 등장한 기술이 바로 Compressed OOPs입니다.
64비트 JVM이지만, 객체 참조 포인터를 32비트로 “압축(Compress)”하여 메모리 공간을 절약하고,
64비트 주소 공간의 장점(4GB 이상의 힙 메모리 지원)은 그대로 유지합니다.
64비트 시스템에서는 주소가 다음과 같이 표현됩니다:
0x0000_7FFF_FFFF_FFFF (최대 표현 가능한 메모리: 16EB)
이번에도 동일하게 8 byte짜리 double 자료형 하나를 저장한다고 가정해봅시다.
0x0000_7FFF_FFFF_FFF8
0x0000_7FFF_FFFF_FFF9
0x0000_7FFF_FFFF_FFFA
0x0000_7FFF_FFFF_FFFB
...
...
0x0000_7FFF_FFFF_FFFE
0x0000_7FFF_FFFF_FFFF
마찬가지로 각 주소 포인터는 1바이트씩을 나타내므로, 위와 같이 8개의 주소 공간을 차지하게 될 것입니다.
64bit JVM에서 Compressed OOPs의 동작 원리
JVM은 자체적으로 힙 영역, 스택 영역, 메서드 영역 등의 런타임 데이터 영역을 정의하고 있습니다. 실제 메모리 상에서는 JVM 프로세스 자체가 OS로부터 메모리를 할당받아 사용하지만, 내부적으로는 그 메모리 영역을 JVM 스펙에 따라 구분하여 사용합니다.
이때, JVM(HotSpot 기준)은 힙 메모리에 객체를 저장할 때 8바이트 경계에 맞춰 정렬(Object Alignment)합니다. 이 작업은 32비트와 64비트 모두에서 동일하게 일어나며, 8바이트 정렬을 적용하는 주된 이유는 CPU 캐시 라인 효율 최적화와 Compressed OOPs 활성화를 위한 전제 조건 때문입니다. 이 정렬 크기는 -XX:ObjectAlignmentInBytes 옵션으로 변경할 수 있지만(8~256), 기본값인 8바이트가 대부분의 워크로드에서 가장 균형 잡힌 선택입니다.
예시를 하나 들어보겠습니다.
힙 메모리가 낮은 주소에서 높은 주소 순서로 할당된다는 사실을 인지해주시기 바랍니다.
int 필드와 double 필드를 가진 객체 하나를 힙에 저장한다고 해봅시다.
0x0000_0000_7FFF_0000이 이 객체의 시작 주소라고 가정해보죠. 객체 헤더(보통 12바이트) 이후에 int 필드가 저장됩니다:
0x0000_0000_7FFF_000C0x0000_0000_7FFF_000D0x0000_0000_7FFF_000E0x0000_0000_7FFF_000F
그럼, 이어서 double 필드를 저장해볼까요?
double은 8바이트를 차지하기 때문에, JVM은 double 필드를 8의 배수 주소(8-byte aligned address)에 배치합니다.
0x0000_0000_7FFF_0010은 8의 배수이므로 바로 이어서 저장됩니다:
0x0000_0000_7FFF_00100x0000_0000_7FFF_00110x0000_0000_7FFF_00120x0000_0000_7FFF_00130x0000_0000_7FFF_00140x0000_0000_7FFF_00150x0000_0000_7FFF_00160x0000_0000_7FFF_0017
이 객체의 실제 데이터는 0x0000_0000_7FFF_0018에서 끝나지만, 객체 전체 크기가 8의 배수(24바이트)이므로 추가 패딩은 필요 없습니다. 만약 객체 크기가 8의 배수가 아니라면, 다음 8바이트 경계까지 **패딩(Padding)**이 추가됩니다.
여기서 중요한 것은 객체 내부 필드의 정렬이 아니라, 객체 자체의 시작 주소가 항상 8바이트 경계에 맞춰진다는 점입니다. CPU가 데이터를 더 빠르게 읽기 위한 메모리 정렬(Alignment) 최적화 때문인데요, CPU는 특정 단위(보통 데이터 버스 폭)로 메모리를 읽으므로, 객체가 8바이트 경계에 맞춰져 있으면 접근 효율이 높아집니다. 반면, 경계가 맞지 않으면 두 번의 버스 접근이 필요하므로 성능이 저하됩니다.
따라서 JVM은 모든 객체를 8바이트 경계에 맞춰 저장하며, 이 특성이 Compressed OOPs의 핵심 전제가 됩니다. 여기서 중요한 내용을 이해해야 하는데요,
모든 객체 주소가 8의 배수이므로, 하위 3비트(2³=8)는 항상 0입니다.
조금 더 풀어서 설명한다면,
0x0000_0000_7FFF_0000
0x0000_0000_7FFF_0001
0x0000_0000_7FFF_0002
0x0000_0000_7FFF_0003
0x0000_0000_7FFF_0004
0x0000_0000_7FFF_0005
0x0000_0000_7FFF_0006
0x0000_0000_7FFF_0007
0x0000_0000_7FFF_0008
0x0000_0000_7FFF_0009
0x0000_0000_7FFF_000A
0x0000_0000_7FFF_000B
0x0000_0000_7FFF_000C
0x0000_0000_7FFF_000D
0x0000_0000_7FFF_000E
0x0000_0000_7FFF_000F
이렇게 16개 주소가 있을때, 이 16개 주소를 전부 계산할 필요 없이,
0x0000_0000_7FFF_0000(0)
0x0000_0000_7FFF_0008(8)
이 두 개 주소만 알고 있다면 저장된 데이터를 문제 없이 불러올 수 있다는 뜻입니다. 알아야 할 주소가 8개 -> 1개로 1/8로 줄어든 셈이죠.
즉, JVM은 이 8개 주소(3비트) 를 제거하면서 32비트 오프셋을 저장하여 “압축된 포인터(Compressed OOP)”를 만들 수 있습니다.
💡 왜 3비트인지 헷갈리신다면: 8 = 2³이므로, 8의 배수 주소는 이진수 하위 3비트가 항상
000입니다. 16진수로 보면 객체 주소의 마지막 자리가 항상0또는8인 것으로 확인할 수 있습니다.
이 압축된 포인터는 실제 주소로 사용할 때 다시 복원됩니다:
실제 주소 = Compressed OOP << 3
예를 들어, 압축된 OOP가 0x0000_0000_00AA_BBCC라면:
실제 주소 = 0x0000_0000_00AA_BBCC << 3 = 0x0000_0000_0555_E660
앞서 32비트 시스템에서는 최대 4GB의 메모리만 사용할 수 있다고 이야기 했습니다. 우리는 여기서 8바이트 정렬(패딩)을 통해 3비트의 여유공간을 더 확보했습니다. 그래서 사실상 35비트를 32비트로 표현할 수 있게 되었습니다.
이를 표현한 그림은 다음과 같습니다.
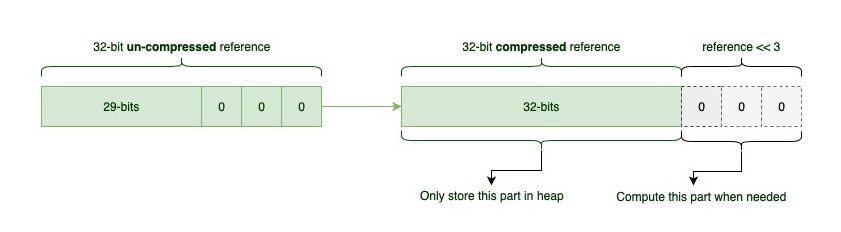
이로써 본래 32비트 포인터로는 4GB까지만 표현할 수 있었던 메모리를, 8바이트 정렬을 이용해 4GB * 8(3비트) = 32GB까지 확장해 표현할 수 있게 되었습니다.
64비트 JVM에서 모든 객체 참조를 64비트 포인터로 처리하는 것은 메모리 효율과 캐시 성능 측면에서 비효율적이기 때문에, JVM은 일정 범위(약 32GB) 내에서는 Compressed OOPs를 활성화해 메모리 사용량을 절감하는 것이 좋습니다.
3비트 shift 연산이 추가된다는 오버헤드가 있지만, 대부분의 워크로드에서 이로 인한 손실보다 메모리 절감 효과가 더 크다고 합니다. ElasticSearch와 같은 대규모 JVM 애플리케이션에서도 일반적으로 Compressed OOPs 활성화가 강력히 권장됩니다.
Compressed OOPs의 세 가지 모드
HotSpot JVM은 힙의 배치 상황에 따라 Compressed OOPs를 세 가지 모드로 나누어 적용합니다. 여기서 모든 주소는 OS가 프로세스에게 부여하는 가상 주소입니다.
1. Unscaled — 힙의 끝 주소가 4GB 이내인 경우:
compressed_oop = 실제 주소
실제 주소 = compressed_oop
힙의 모든 가상 주소가 32비트에 들어오므로, shift 연산조차 필요 없습니다. 가장 효율적이지만, 힙 크기가 4GB 미만일 때만 가능합니다.
2. Zero-based — 힙의 끝 주소가 32GB 이내인 경우:
compressed_oop = 실제 주소 >> 3
실제 주소 = compressed_oop << 3
shift 연산 하나로 주소를 복원할 수 있습니다. 핵심 조건은 힙이 가상 주소 0에서 시작하는 것이 아니라, **힙의 끝 주소(시작 주소 + 힙 크기)**가 약 32GB(2³² × 8) 이내인지입니다. compressed OOP에 실제 가상 주소를 8로 나눈 값을 그대로 저장하기 때문에, 이 값이 32비트에 들어와야 합니다.
예를 들어, 코드와 라이브러리가 낮은 주소 수백 MB를 차지하고 힙이 그 위에 배치되더라도 힙 끝 주소가 32GB 이내이면 Zero-based가 적용됩니다. 실무에서 힙 크기가 약 31GB 이하라면 대부분 이 모드로 동작합니다.
3. Non-zero-based — 힙의 끝 주소가 32GB를 넘지만, 힙 크기 자체는 32GB 이내인 경우:
compressed_oop = (실제 주소 - base) >> 3
실제 주소 = base + (compressed_oop << 3)
OS가 힙을 높은 가상 주소에 배치하여 끝 주소가 32GB를 넘으면, 실제 주소를 8로 나눈 값이 32비트에 들어오지 않습니다. 이때 힙 시작 주소(base)로부터의 오프셋을 저장하는 방식으로 전환됩니다.
예를 들어 base가 1GB라면, 힙은 1GB ~ 33GB 범위에 위치합니다. 힙의 가상 주소가 32GB를 넘더라도, 오프셋(실제 주소 - base)을 8로 나눈 값은 32비트에 들어오므로 Compressed OOPs가 동작합니다. 다만 참조를 복원할 때마다 base 덧셈이 추가되므로, Zero-based보다 약간의 성능 오버헤드가 있습니다.
💡 "주소가 32GB를 넘는다"와 "힙 크기가 32GB를 넘는다"는 다른 이야기입니다. Zero-based는 전자가 불가능할 때 Non-zero-based로 전환되고, 후자가 불가능하면 Compressed OOPs 자체가 비활성화됩니다.
Compressed OOPs 비활성화
힙 크기가 약 32GB를 넘어서면, 기본 8바이트 정렬 기준으로는 어떤 모드로도 32비트 포인터에 오프셋을 담을 수 없습니다. 이 경우 Compressed OOPs가 완전히 비활성화되어 모든 포인터가 8바이트로 돌아가면서 메모리 사용량이 급증합니다.
왜 31GB인가
ElasticSearch 등에서 힙을 32GB가 아닌 31GB로 지정하는 이유는, Compressed OOPs의 활성화 자체를 보장하기 위해서입니다.
-Xmx=32g로 설정하면 JVM 내부 오버헤드(객체 헤더, 정렬, 메타데이터 등)로 인해 실제 필요한 힙 공간이 32GB를 살짝 넘을 수 있습니다. 이 경우 HotSpot은 Compressed OOPs를 완전히 비활성화해버립니다. 31GB는 이 경계를 확실히 넘지 않기 위한 안전 마진입니다.
주의할 점은, 31GB로 설정한다고 Zero-based 모드가 보장되는 것은 아닙니다. 어떤 모드가 적용되는지는 OS의 힙 배치(ASLR 등)에 의존하며, 힙 크기만으로는 통제할 수 없습니다. 다만 실무에서는 대부분 Zero-based로 동작하고, Zero-based와 Non-zero-based의 성능 차이(참조당 덧셈 명령어 1개)는 미미하므로, 실질적으로 중요한 것은 Compressed OOPs가 켜져 있느냐 꺼져 있느냐입니다.