
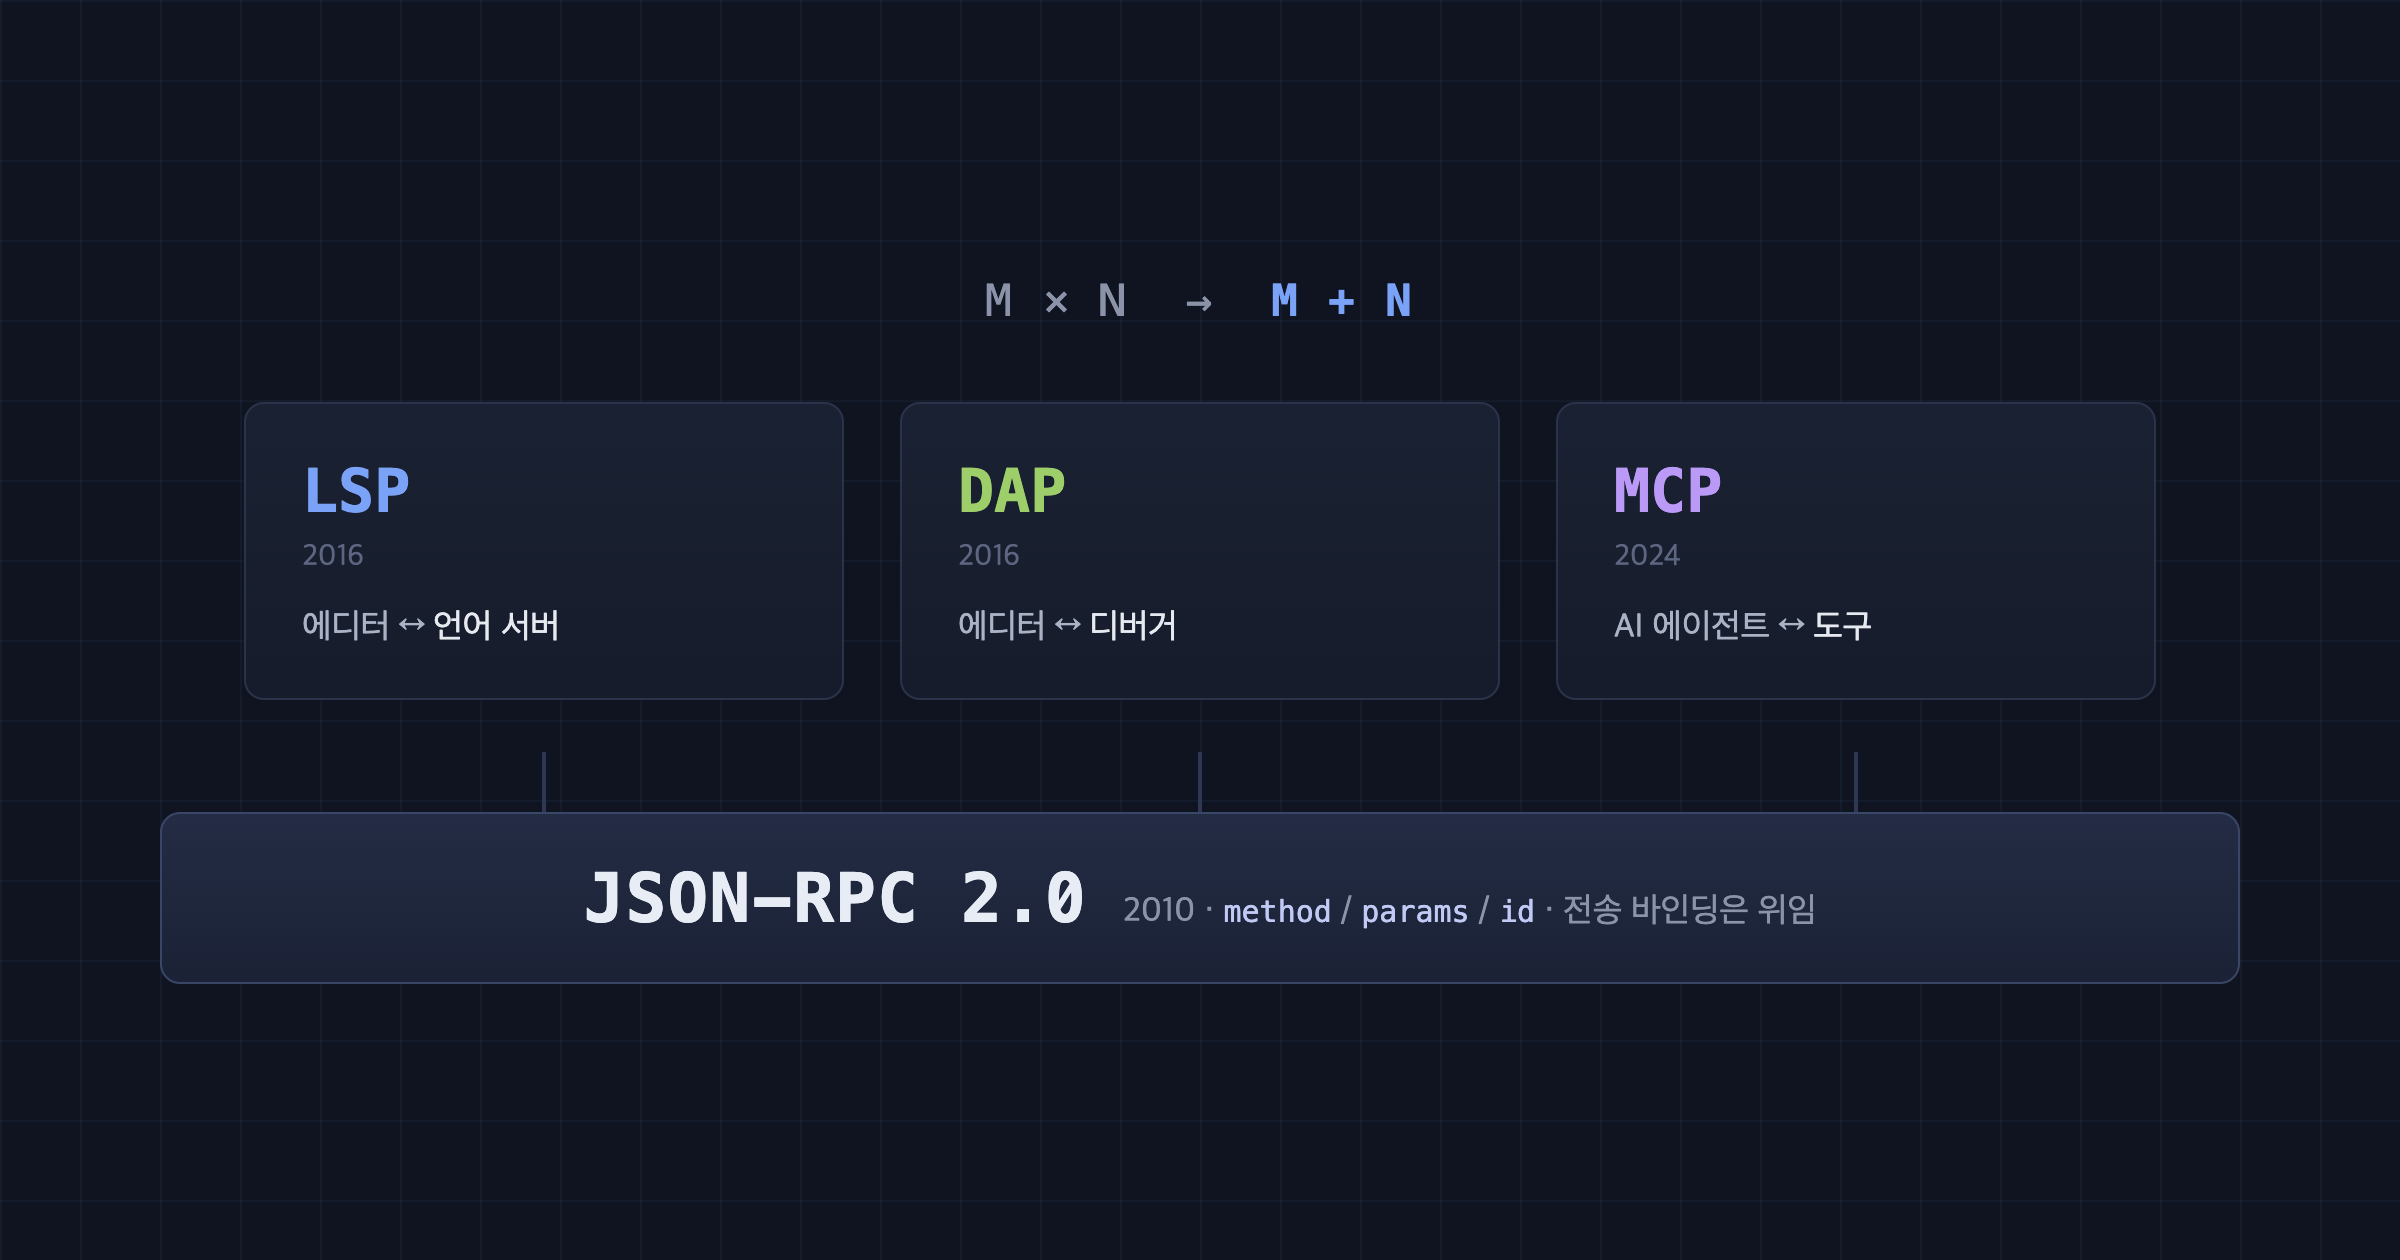
MCP(Model Context Protocol) 스펙 문서를 읽다 보면 LSP(Language Server Protocol)와 구조가 많이 닮았다는 인상을 받게 됩니다. JSON-RPC 위에서 동작하고, 클라이언트와 서버가 capability를 협상하고, stdio로 로컬 프로세스를 띄워 대화합니다. MCP 스펙이 LSP에서 영감을 받았다고 직접 명시하고 있으니, 이 닮음은 우연이 아니라 의도된 설계입니다.
이 글에서는 그 계보를 한번 따라가 봅니다. 1998년의 XML-RPC에서 2010년의 JSON-RPC 2.0으로, 2016년의 LSP로, 그리고 2024년의 MCP로 이어지는 흐름입니다. 중간에 LSP를 7년간 도입하지 않다가 입장을 바꾼 JetBrains의 사례도 함께 봅니다. 세 프로토콜이 각각 다른 영역에서 비슷한 문제를 비슷한 방식으로 풀었다는 것이 이 글에서 정리해 보려는 내용입니다.
1. JSON-RPC — 스펙이 작다는 것의 의미
JSON-RPC 2.0 명세는 A4 몇 장 분량입니다. 한 시간이면 다 읽을 수 있고, 어떤 언어로든 하루면 구현할 수 있습니다.
개념은 이름 그대로입니다. JSON으로 원격 프로시저를 호출(RPC, Remote Procedure Call)합니다.
// 요청
{ "jsonrpc": "2.0", "method": "subtract", "params": [42, 23], "id": 1 }

// 응답
{ "jsonrpc": "2.0", "result": 19, "id": 1 }
필드는 네 개입니다. method는 호출할 함수 이름, params는 인자, id는 요청과 응답을 짝짓는 토큰, jsonrpc는 버전 표식. 실패하면 result 대신 error 객체(code, message, 선택적 data)가 옵니다.
여기에 두 가지 장치가 더 있습니다.
- Notification:
id를 빼고 보내면 응답을 기대하지 않는 단방향 통지가 됩니다. LSP 서버가 diagnostics(에러·경고)를 에디터로 밀어 넣을 때 쓰는 방식입니다. id기반 비동기 다중화: 요청을 보낸 순서와 응답이 오는 순서가 달라도 됩니다. 한 연결 위에서 여러 호출이 동시에 진행될 수 있고, 양쪽 모두method를 보낼 수 있어서 클라이언트/서버 구분도 사실상 관습에 가깝습니다.
설계에서 눈여겨볼 부분은 스펙에 없는 것들입니다. JSON-RPC는 전송 계층을 정의하지 않습니다. HTTP, WebSocket, TCP 소켓, 자식 프로세스의 stdin/stdout 어디에 얹어도 됩니다.
다만 "정의하지 않는다"는 말이 합의가 필요 없다는 뜻은 아닙니다. 코어 스펙은 메시지 객체의 모양까지만 책임지고, 그 메시지를 무엇에 실어 나를지, 스트림 위에서 메시지 경계를 어떻게 나눌지(framing)는 품는 쪽 스펙에 위임합니다. LSP는 stdio 위에 Content-Length 헤더 프레이밍을 명문화했고, MCP는 stdio(줄바꿈 구분)와 Streamable HTTP라는 전송 바인딩을 설정으로 선언하게 했습니다. 양쪽이 다른 전송이나 프레이밍을 기대하면 당연히 통신은 되지 않습니다. 합의 비용이 사라진 것이 아니라 한 단계 위로 옮겨간 것이고, LSP와 MCP는 그 비용을 각자 한 문단 분량의 바인딩 정의로 해결했습니다. 그 덕분에 "프로세스 하나 띄우고 파이프로 대화한다"는 단순한 배포 모델이 가능해졌습니다.
대신 스키마와 타입 안전성, 바이너리 효율, 스트리밍, 인증도 전부 없습니다. 그래서 LSP와 MCP는 각자 TypeScript 타입 정의와 capability negotiation을 프로토콜 위에 따로 쌓았습니다.
같은 RPC, 반대 방향의 선택 — gRPC와의 비교
예전에 gRPC with Go 시리즈에서 gRPC를 다룬 적이 있습니다. 같은 RPC 계열인데, 두 프로토콜은 거의 정반대의 트레이드오프를 선택했습니다. 당시 1편에서 HTTP/1.1의 텍스트 파싱 비용과 HOL 블로킹을 짚으면서 gRPC가 HTTP/2와 Protocol Buffers를 채택한 배경을 정리했는데, JSON-RPC는 그 글에서 "비효율"로 분류했던 특성들 — 텍스트 포맷, 스키마 부재 — 을 의도적으로 유지한 쪽입니다.
| gRPC | JSON-RPC | |
|---|---|---|
| 직렬화 | Protocol Buffers (바이너리, 스키마 필수) | JSON (텍스트, 스키마 없음) |
| 전송 | HTTP/2 고정 | 미정의 (stdio, 소켓, HTTP, WebSocket...) |
| 계약 | .proto 파일 + 코드 생성으로 강제 |
문서와 관례로 합의 |
| 스트리밍 | Unary/Server/Client/Bidirectional 내장 | 없음 (notification으로 부분 대체) |
| 상대적 강점 | 처리량, 타입 안전성 | 구현 진입 장벽, 와이어 가독성 |
어느 쪽이 좋은 설계인지는 트래픽의 성격에 달려 있습니다. 마이크로서비스 사이의 대량 호출이라면 파싱 비용과 스키마 강제가 중요해지고, gRPC의 선택이 맞습니다. 반면 에디터와 언어 서버 사이의 대화는 사람의 타이핑 속도로 흐르고, 디버깅할 때 와이어를 눈으로 읽을 수 있다는 점이 실질적인 이득이 됩니다. HTTP/2 의존이 없어서 자식 프로세스의 stdin/stdout에 바로 얹을 수 있다는 점도 LSP·MCP의 배포 모델에는 결정적이었습니다.
💡 에디터와 언어 서버 사이의 트래픽은 초당 수만 건이 아니라 사람의 타이핑 속도로 흐릅니다. 이 영역에서는 직렬화 효율보다 구현 진입 장벽이 낮다는 점이 더 크게 작용했다고 생각합니다.
2. LSP — M×N 통합 문제
2016년, Microsoft가 VS Code에 쓰던 언어 서버 프로토콜을 Red Hat, Codenvy와 함께 공개 표준으로 내놓았습니다. 기원은 C#을 VS Code에서 지원하기 위한 OmniSharp, 그리고 TypeScript 컴파일러를 에디터 밖 프로세스로 분리한 tsserver입니다.
LSP가 푼 문제는 조합의 문제입니다. 에디터가 개, 언어가 개 있으면 통합 작업은 번 필요합니다. 언어 분석기를 표준 인터페이스 뒤로 분리하면 이것이 으로 줄어듭니다. rust-analyzer를 한 번 만들면 VS Code, Neovim, Emacs, Helix가 모두 그대로 사용합니다.
핵심 기능은 일곱 가지 정도로 요약됩니다. 정의로 이동(textDocument/definition), 참조 찾기(references), 타입·문서 표시(hover), 자동완성(completion), diagnostics 푸시, 전역 rename, 퀵픽스(codeAction).
효과는 양방향이었습니다. 새 언어가 에디터 생태계에 진입하는 비용이 줄었고, Zed나 Helix 같은 새 에디터가 출시 시점부터 수십 개 언어를 지원할 수 있게 되었습니다. 같은 해 공개된 DAP(Debug Adapter Protocol)는 동일한 구조를 디버깅에 적용했습니다. gdb, lldb, debugpy 같은 디버거를 어댑터로 감싸서 같은 형태를 만든 것입니다.
3. JetBrains — 거부의 근거와 전환의 이유
이 흐름에 가장 늦게 합류한 주요 업체가 JetBrains입니다.
기술적인 거부 근거는 분명했습니다. IntelliJ 플랫폼의 핵심인 PSI(Program Structure Interface)는 프로젝트 전체를 인덱싱한 시맨틱 모델 위에서 동작합니다. 크로스 언어 참조 추적, 구조적 검색·치환, 수백 개의 intention 기반 리팩터링 같은 기능은 "커서 위치를 주면 정의 위치를 돌려준다" 수준으로 평탄화된 프로토콜로는 표현하기 어렵습니다. LSP는 여러 에디터가 공유할 수 있는 최소공통분모를 정의한 것이고, PSI는 그보다 훨씬 풍부한 모델입니다. IntelliJ의 rename이 LSP 기반 에디터의 rename보다 더 많은 케이스를 잡아내는 것은 지금도 사실입니다.
다만 수익 구조 관점에서 보면 다른 그림이 됩니다. LSP가 무료로 보급한 것은 JetBrains가 유료로 팔던 것 — 코드 분석·완성·리팩터링 기능 — 과 상당 부분 겹칩니다. "꽤 괜찮은 80%"가 모든 에디터에 기본 탑재되는 환경에서는 나머지 20%의 가치로 구독을 정당화해야 합니다. 여기에 개발 도구의 무게중심이 에디터에서 AI 에이전트로 이동하면서 또 하나의 압력이 생겼습니다. 표준 프로토콜로 노출되지 않는 분석 엔진은, 품질과 무관하게 에이전트 생태계에 통합되지 못합니다.
실제 행보도 이 압력을 따라갔습니다. 2023년 IntelliJ Platform 2023.2에 LSP API가 들어왔습니다. 자사가 네이티브로 지원하지 않는 언어를 위한 플러그인 통로라는 제한적인 형태였습니다. 2025년에는 공식 Kotlin LSP 서버를 내놓았습니다. Kotlin을 VS Code에서 쓸 수 있게 하기 위한 것으로, Kotlin 생태계의 확장을 IDE 독점성보다 우선한 결정으로 읽힙니다.
저는 이 사례가 "표준이 항상 이긴다"는 이야기라기보다는, 기술적 우위와 인터페이스 접근성이 따로 움직일 수 있다는 사례에 가깝다고 생각합니다. PSI는 지금도 LSP보다 표현력이 높지만, 접근성은 표준 쪽에 있었습니다.
4. MCP — 같은 구조, 다른 호출자
MCP가 마주한 문제는 LSP와 같은 모양입니다. AI 클라이언트가 개(Claude, IDE 어시스턴트, 각종 에이전트), 외부 시스템이 개(GitHub, Slack, 데이터베이스, 사내 API). MCP 이전에는 에이전트마다 각 시스템 연동을 따로 구현했습니다. MCP는 도구와 컨텍스트를 표준 인터페이스 뒤로 분리해서 같은 방식으로 이 조합을 줄였습니다.
구조 대응은 거의 일대일입니다.
| LSP | MCP | |
|---|---|---|
| 기반 | JSON-RPC 2.0 | JSON-RPC 2.0 |
| 핸드셰이크 | initialize + capability negotiation | initialize + capability negotiation |
| 대표 요청 | textDocument/definition |
tools/call |
| 서버 푸시 | diagnostics notification | notification |
| 전송 | stdio / 소켓 | stdio / Streamable HTTP |
| 주도 기업 | Microsoft (VS Code) | Anthropic (Claude) |
보급 경로도 비슷합니다. 자사 제품의 통합 문제를 풀기 위해 만든 내부 설계를 공개 표준으로 전환했고, 경쟁사들이 채택했습니다. 차이가 있다면 속도입니다. OpenAI와 Google이 MCP를 채택하는 데 걸린 시간은 JetBrains가 LSP를 받아들이는 데 걸린 7년보다 훨씬 짧았습니다.
구조는 같지만 성질까지 같지는 않은데, 가장 큰 차이는 호출하는 주체입니다.
LSP의 호출자는 결정론적 코드입니다. 사용자가 F12를 누르면 에디터가 definition을 요청합니다. MCP의 호출자는 확률적 모델입니다. 무엇을 언제 호출할지 LLM이 판단하고, 서버가 돌려준 텍스트가 다시 모델의 입력이 됩니다. 그래서 LSP에는 없던 문제가 생깁니다. 프롬프트 인젝션, 도구 설명을 통한 컨텍스트 오염, 과도한 권한을 가진 서버의 오남용. LSP 서버가 잘못된 응답을 주면 잘못된 위치로 점프하는 정도로 끝나지만, MCP 서버가 잘못된(또는 악의적인) 응답을 주면 에이전트가 그것을 근거로 행동할 수 있습니다. MCP 스펙 개정 이력에서 OAuth 인증과 권한 동의에 많은 지면이 할애되는 배경입니다. trust model(무엇을 어디까지 신뢰할지에 대한 설계)이 LSP에서는 부차적 문제였다면 MCP에서는 핵심 문제가 되었습니다.
5. 정리하며
비슷한 구조의 문제가 다음으로 보이는 곳은 에이전트와 에이전트 사이입니다. 멀티 에이전트 시스템이 늘어나면 "에이전트 개 × 프레임워크 개"라는 익숙한 조합이 다시 나타나는데, Google이 2025년 공개한 A2A(Agent2Agent) 프로토콜이 이 자리를 노리고 있습니다. 같은 패턴이 반복될지는 지켜봐야겠지만, 만약 반복된다면 그 프로토콜의 모양 — 작은 스펙, 전송 계층 무정의, capability negotiation — 은 이미 세 번 본 형태와 크게 다르지 않을 것 같습니다.
이 계보를 정리하면서 개인적으로는 프로토콜을 평가할 때 기능 목록보다 "남들이 얼마나 쉽게 구현할 수 있는가"를 먼저 보게 되었습니다.
TL;DR
- JSON-RPC는
method/params/id만으로 구성된 작은 RPC 프로토콜입니다. 전송과 framing은 품는 쪽 스펙(LSP의Content-Length프레이밍, MCP의 stdio/Streamable HTTP)이 정의하며, 이 위임 덕분에 stdio 파이프 위의 프로세스 간 통신이라는 단순한 배포 모델이 가능합니다. gRPC와는 거의 정반대의 트레이드오프입니다. - LSP(2016, Microsoft)는 에디터×언어의 M×N 통합 문제를 M+N으로 줄였습니다. DAP는 같은 구조를 디버깅에 적용했습니다.
- JetBrains는 PSI의 표현력을 근거로 LSP를 7년간 도입하지 않았지만, 코드 분석 기능의 commoditize와 에이전트 시대의 통합 압력 속에서 2023년 LSP API, 2025년 공식 Kotlin LSP 서버를 내놓았습니다.
- MCP(2024, Anthropic)는 LSP와 같은 구조를 에이전트-도구 연결에 적용했습니다. 다만 호출 주체가 결정론적 코드에서 확률적 모델로 바뀌면서 trust model이 핵심 설계 문제가 되었습니다.
- 에이전트 간 통신(A2A 등)에서 같은 패턴이 반복될 가능성이 있습니다.