
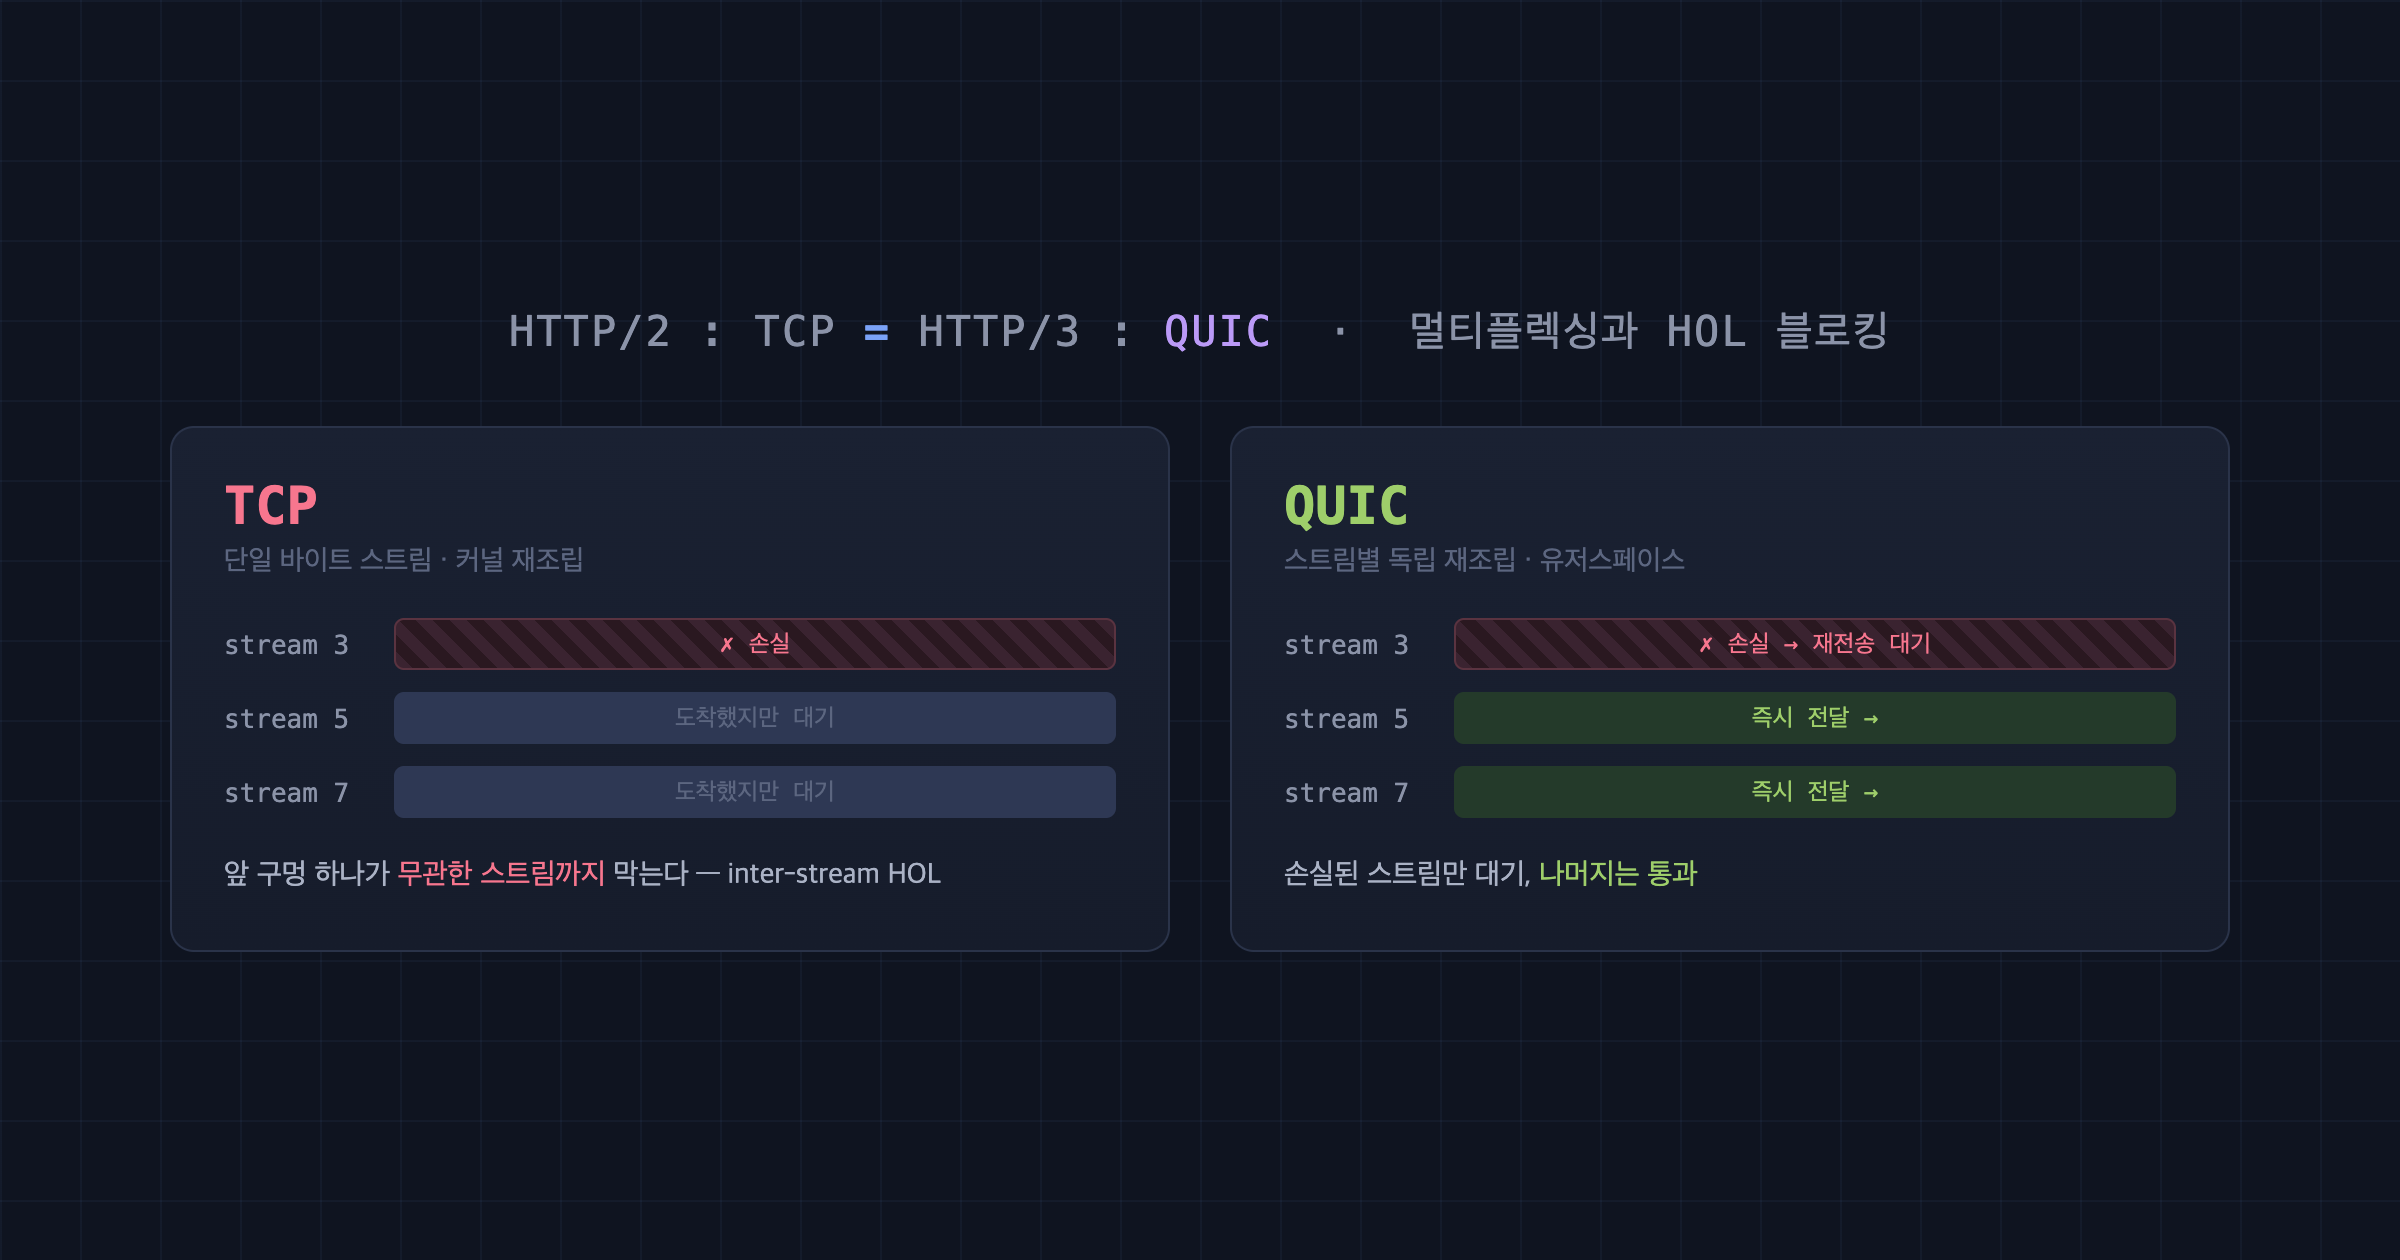
HTTP/2가 "한 연결로 여러 요청을 동시에 처리한다"는 설명은 자주 보이지만, 그 동시성이 정확히 어디까지 가능하고 어디서 막히는지는 잘 안 짚고 넘어가게 됩니다. 동시에 보낸 것처럼 보이는 스트림들이 사실 하나의 TCP 바이트 스트림 위에 직렬화되고, 중간 세그먼트 하나가 손실되면 무관한 스트림까지 멈추는 지점이 있습니다. QUIC은 바로 이 지점을 겨냥해 설계되었습니다.
이 글은 HTTP/2 멀티플렉싱의 프레임/스트림 구조에서 출발해, TCP의 HOL(Head-of-Line) 블로킹이 왜 발생하는지, QUIC이 그것을 어떻게 우회하는지, 그리고 QUIC도 여전히 지연되는 경우와 실무에서의 적합성까지 한 흐름으로 정리해 본 것입니다. 예전에 gRPC with Go 시리즈에서 HTTP/1.1의 HOL 블로킹과 HTTP/2 채택 배경을 다뤘는데, 이 글은 그 다음 층위인 "HTTP/2도 못 푸는 TCP 레벨의 HOL"에서 시작합니다.
들어가기 전에 — 프레임·세그먼트·패킷
이 글은 여러 계층을 오가기 때문에, 같은 단어가 계층마다 다른 것을 가리키는 일이 잦습니다. 먼저 기준을 잡고 시작하겠습니다. 각 계층이 다루는 데이터 단위(PDU, Protocol Data Unit)는 보통 다음과 같이 부릅니다.
| 계층 | 데이터 단위 | 식별/역할 |
|---|---|---|
| L2 링크 (Ethernet) | 프레임(frame) | MAC 주소로 같은 링크 안에서 전달 |
| L3 네트워크 (IP) | 패킷(packet) | IP 주소로 종단 간 라우팅 |
| L4 전송 — TCP | 세그먼트(segment) | 순서·신뢰성 있는 바이트 스트림 |
| L4 전송 — UDP | 데이터그램(datagram) | 비신뢰·비순서 전달 |
| 애플리케이션 — HTTP/2 | 프레임(frame) | HEADERS·DATA 등. L2 프레임과 무관 |
헷갈리기 쉬운 두 단어를 미리 못 박아 두겠습니다.
- "프레임"은 두 계층에서 쓰입니다. 하나는 L2 이더넷 프레임, 다른 하나는 HTTP/2(그리고 뒤에 나올 QUIC)의 애플리케이션 계층 프레임입니다. 이름만 같을 뿐 서로 다른 계층의 다른 것입니다. 이 글에서 그냥 "프레임"이라고 하면 HTTP/2 프레임을 가리킵니다. 이더넷 프레임은 이 글의 관심 밖이라 따로 등장하지 않습니다.
- "패킷"도 두 계층에서 쓰입니다. 하나는 L3 IP 패킷, 다른 하나는 QUIC이 UDP 페이로드 안에 만드는 QUIC 패킷입니다. 이 글에서 "QUIC 패킷"이라고 명시하면 후자를 뜻합니다.
QUIC은 특히 이 두 단어를 자기 계층에서 다시 씁니다. UDP 데이터그램 하나 안에 QUIC 패킷이 들어가고, 그 QUIC 패킷 안에 다시 QUIC 프레임(ACK 프레임, STREAM 프레임 등)이 담깁니다. 그래서 같은 데이터가 아래로 내려가는 동안 부르는 이름이 여러 번 바뀝니다. 두 경로를 한 줄로 늘어놓으면 이렇습니다.
HTTP/2 over TCP   :  HTTP/2 프레임  → TCP 세그먼트  → IP 패킷 → (이더넷 프레임)
HTTP/3 over QUIC  :  QUIC 프레임    → QUIC 패킷     → UDP 데이터그램 → IP 패킷 → (이더넷 프레임)
이 기준으로 보면 뒤에서 다룰 "HTTP/2 프레임과 TCP 세그먼트는 서로의 경계를 모른다"는 이야기가, 애플리케이션 계층의 프레임과 전송 계층의 세그먼트라는 다른 계층 두 단위 사이의 이야기라는 점이 분명해집니다.
1. HTTP/2 멀티플렉싱: 프레임과 스트림
HTTP/1.1은 한 연결에서 요청을 순차로 처리합니다. 앞 응답이 끝나야 다음 요청을 보낼 수 있어서, 브라우저는 도메인당 6개 안팎의 TCP 연결을 동시에 열어 이 제약을 우회해 왔습니다.
HTTP/2는 단일 TCP 연결 위에서 여러 요청/응답을 동시에 주고받습니다. 핵심은 두 가지 추상화입니다.
- 스트림(Stream): 요청/응답 한 쌍에 대응하는 논리적 흐름. 각각 고유한 Stream ID를 가집니다.
- 프레임(Frame): 실제 전송 단위. 모든 프레임 헤더에 Stream ID가 들어 있습니다.
송신측은 여러 스트림의 프레임을 잘게 쪼개 인터리빙(교차 전송)하고, 수신측은 각 프레임 헤더의 Stream ID를 보고 원래 스트림으로 재조립합니다.
논리적으로는 세 개의 독립된 흐름이지만, 물리적으로는 하나의 TCP 연결을 타고 내려갑니다. 이 구조가 뒤에서 다룰 HOL 블로킹의 출발점이 됩니다.
2. 프레임은 어떻게 쪼개지는가
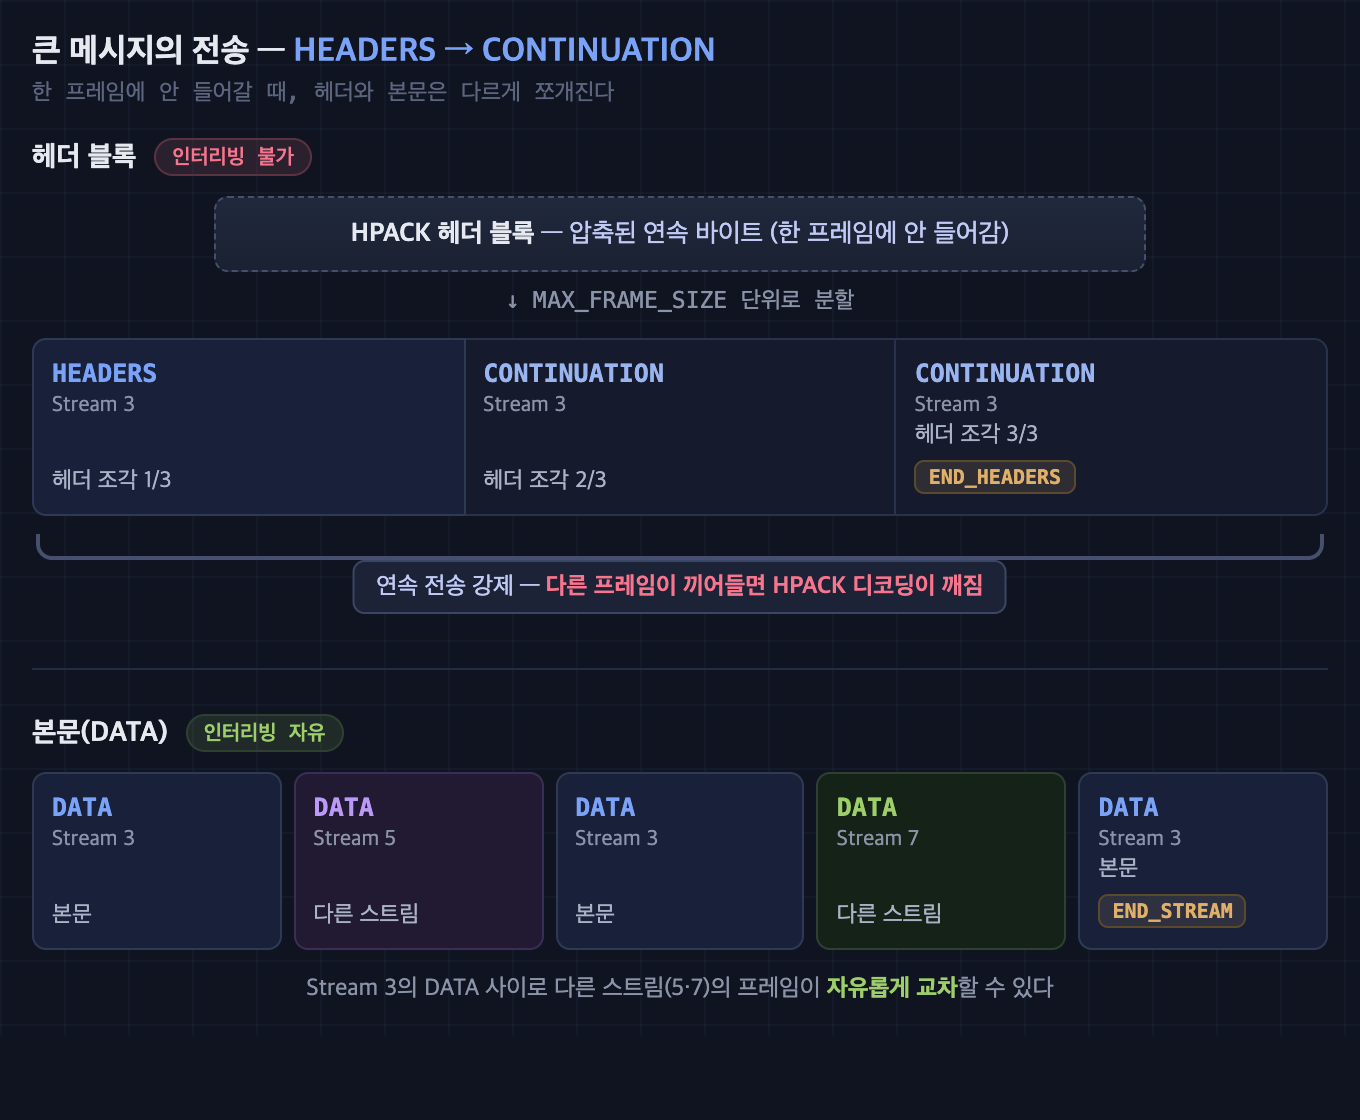
프레임의 Length 필드는 24비트라 이론상 한 프레임이 약 16MB까지 가능하지만, 실제로는 SETTINGS_MAX_FRAME_SIZE로 제한됩니다. 기본값은 **16,384바이트(16KB)**이고, 연결 협상으로 16KB~16MB 사이에서 조정합니다.
메시지가 한 프레임에 안 들어가면 종류에 따라 처리가 갈립니다.
| 부분 | 처리 방식 | 인터리빙 |
|---|---|---|
| 헤더가 큼 | HEADERS → CONTINUATION* → END_HEADERS로 종료 |
불가 |
| 본문이 큼 | DATA 프레임 여러 개 → END_STREAM으로 종료 |
자유 |
헤더 블록은 HPACK으로 압축된 연속 바이트라서 중간에 다른 프레임이 끼어들면 디코딩이 깨집니다. 그래서 HEADERS와 뒤따르는 CONTINUATION은 연속으로 보내야 합니다. 반면 DATA 프레임은 다른 스트림의 프레임과 자유롭게 교차할 수 있습니다.
정리하면 세 가지 다이얼이 각각 다른 일을 합니다.
- 얼마나 쪼갤지 →
MAX_FRAME_SIZE - 스트림 종료 →
END_STREAM플래그 - 헤더 블록 종료 →
END_HEADERS플래그
3. HTTP/2 프레임과 TCP 세그먼트는 서로의 경계를 모른다
여기서 한 번 헷갈리기 쉬운 부분이 있습니다. HTTP/2가 프레임으로 쪼갠 단위와 TCP가 세그먼트로 쪼갠 단위는 전혀 일치하지 않습니다.
- HTTP/2는
MAX_FRAME_SIZE(예: 16KB) 기준으로 프레임을 만듭니다. - TCP는
MSS(보통 1460바이트) 기준으로 세그먼트를 만듭니다. - TCP 입장에서 HTTP/2 프레임은 그냥 바이트 스트림일 뿐이라, "프레임 경계"라는 개념 자체가 없습니다.
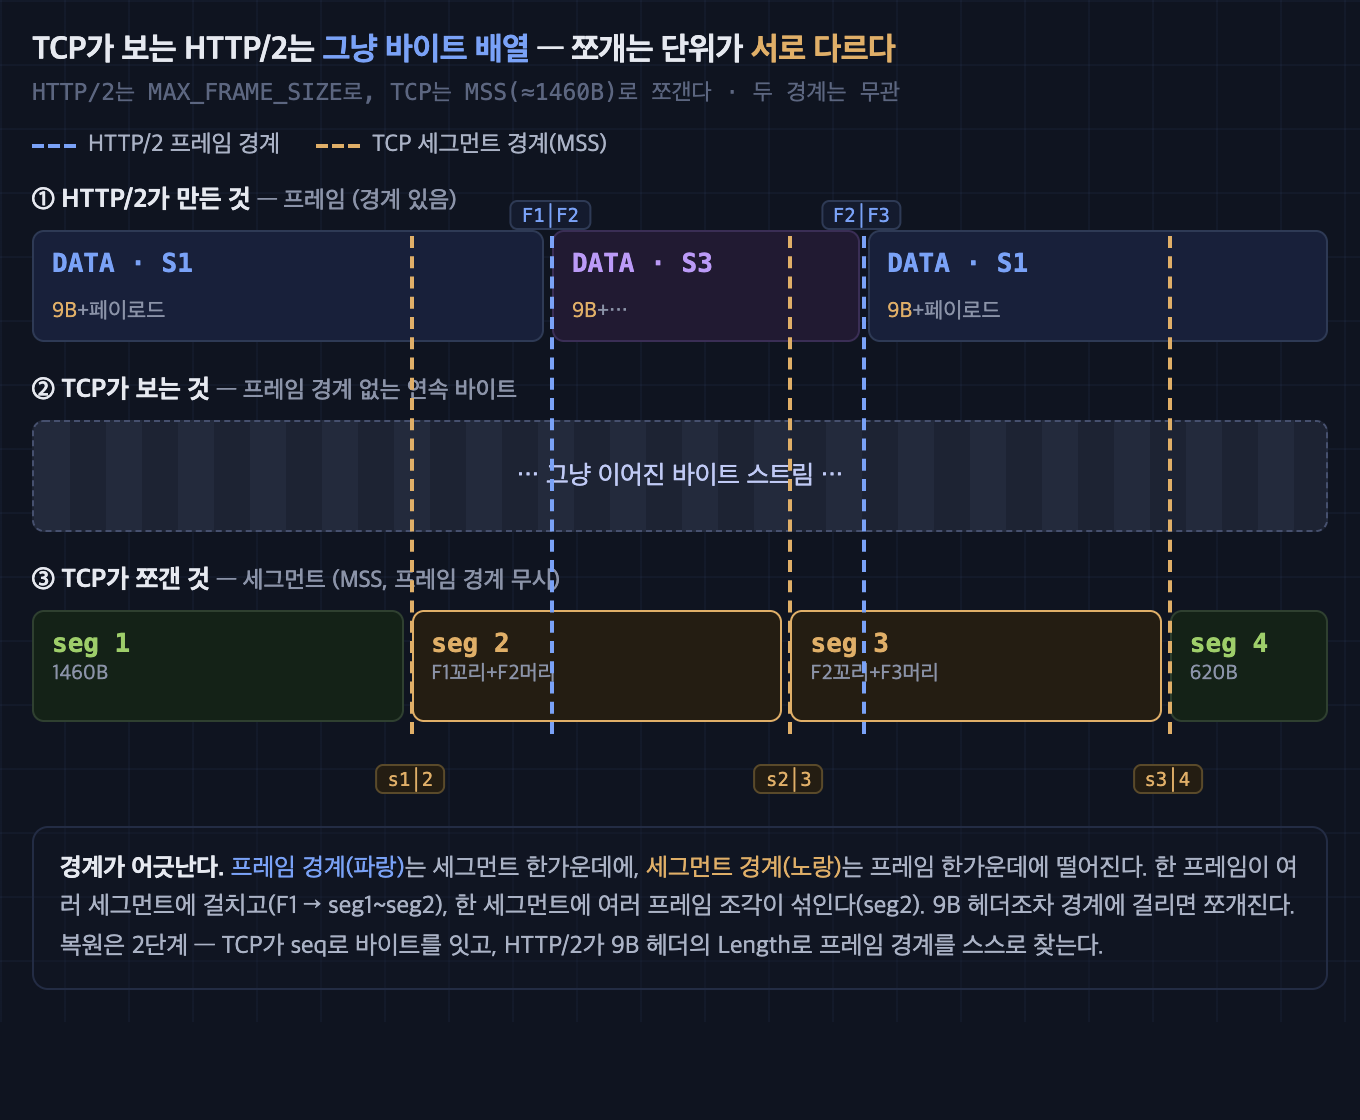
그래서 수신측은 2단계로 재조립합니다.
- TCP 계층: seq 번호로 세그먼트를 순서대로 이어 붙여 연속 바이트 스트림을 복원합니다.
- HTTP/2 계층: 9바이트 프레임 헤더의 Length를 읽어 프레임 경계를 스스로 찾고, Stream ID로 분류합니다.
프레임이 self-describing(Length가 헤더에 박혀 있음)이라, TCP가 어디서 잘랐든 HTTP/2 계층이 정확히 경계를 복원할 수 있습니다. 두 계층의 분할이 독립적이어도 문제가 없는 이유입니다.
4. TCP HOL 블로킹
이제 멀티플렉싱이 막히는 지점입니다. 흔한 오해부터 풀어 보겠습니다.
"중간 세그먼트가 손실돼도, 그 뒤에 도착한 세그먼트는 이미 받았으니 애플리케이션으로 넘어오지 않나?"
넘어오지 않습니다. TCP는 순서가 어긋난(out-of-order) 세그먼트를 애플리케이션으로 올려보내지 않습니다. read()의 계약이 "틈 없이 이어진 연속 바이트 스트림"이기 때문입니다.
수신측 커널 TCP 버퍼:
┌──────────────┬──────────┬──────────────┐
│ seq 1000~2459│  [구멍]   │ seq 3920~5379│
│ seg1 ✓       │ seg2 ✗   │ seg3 ✓       │
└──────────────┴──────────┴──────────────┘
       ↓                          ↓
  read() 가능              커널 버퍼에 갇힘
  (seq 2459까지)           (seg2 도착 전까지 전달 불가)
seg3는 물리적으로 이미 도착했지만, 앞에 구멍이 있어 연속성이 깨졌으므로 커널이 보관만 하고 read()로 내주지 않습니다. TCP의 전달 단위는 "개별 세그먼트"가 아니라 **"구멍 없이 이어진 prefix"**입니다.
문제는 HTTP/2와 만났을 때입니다. 손실된 세그먼트에 Stream 3의 데이터가 들어 있었더라도, TCP는 바이트 순서를 강제하므로 그 뒤에 도착한 무관한 Stream 5의 데이터까지 함께 막힙니다. HTTP/2가 논리적으로 스트림을 분리해 놓아도, 그 아래의 단일 TCP 바이트 스트림이 물리적 직렬화를 강제하기 때문입니다.
HTTP/2의 멀티플렉싱이 애플리케이션 계층에서 끝나고, 전송 계층의 제약은 그대로 남아 있다고 읽힙니다. 이 한계가 QUIC을 설계하게 된 직접적인 동기입니다.
5. QUIC: UDP 위에서 신뢰성을 다시 만든다
QUIC의 출발점은 단순합니다. TCP는 신뢰성 로직이 커널에 박혀 있어 "단일 바이트 스트림"이라는 모델에 고정되어 있습니다. 그렇다면 신뢰성 로직을 커널 밖으로 꺼내, 스트림별로 독립적으로 설계하면 됩니다.
TCP:  [신뢰성 로직 = 커널 안]
QUIC: UDP(아무것도 안 함) + [신뢰성 로직 = 유저스페이스 QUIC]
QUIC은 UDP 위에서 TCP가 하던 일을 유저스페이스에서 재구현합니다. 패킷 번호(Packet Number), ACK 프레임, 재전송, 흐름/혼잡 제어를 모두 자기가 들고 있습니다.
두 종류의 순서
QUIC을 이해하는 핵심은 순서가 두 층위로 나뉜다는 점입니다.
| 구분 | 의미 | 범위 |
|---|---|---|
| 패킷 번호 | 전송 단위의 순서. 손실 감지/재전송에 사용 | 연결 전체에서 단조 증가 |
| 스트림 오프셋 | 각 스트림 내부 데이터의 순서 | 스트림마다 독립 |
Packet #8 = [Stream3 ...]  ✗ 손실
Packet #9 = [Stream5 ...]  ✓ 도착
  → Stream 3은 막히지만, Stream 5는 오프셋이 연속이면 즉시 앱에 전달
TCP라면 Packet #8 손실이 그 뒤 모든 바이트를 막았겠지만, QUIC은 손실된 스트림만 대기시키고 나머지는 통과시킵니다. 복구 단위가 연결 전체가 아니라 스트림별이기 때문입니다.
여기서 "무손실"이라는 표현은 손실이 안 난다는 뜻이 아닙니다. 손실을 ACK로 감지하고 재전송해서 결국 빠짐없이 전달한다는, TCP와 동일한 신뢰성 개념입니다. 다만 TCP와 다른 점이 둘 있습니다.
- 재전송 시 새 패킷 번호를 씁니다. "무엇을(스트림 오프셋)"과 "어떤 패킷으로(패킷 번호)"를 분리해, TCP의 retransmission ambiguity(재전송된 세그먼트의 ACK가 원본 것인지 재전송 것인지 모호한 문제)를 피합니다.
- 복구 단위가 스트림별이라, 손실된 스트림만 기다리고 나머지는 막지 않습니다.
재조립 버퍼는 어디에 있는가
QUIC이 스트림별 독립 처리를 할 수 있는 근본 이유는 재조립 버퍼의 위치에 있습니다.
TCP는 재조립 로직이 커널에 박혀 있어 단일 바이트 스트림 모델을 벗어날 수 없습니다. 그래서 inter-stream HOL이 구조적으로 생깁니다. QUIC은 재조립 로직이 유저스페이스에 있으니 스트림마다 독립 버퍼를 자유롭게 둘 수 있고, 덤으로 프로토콜 개선을 앱 업데이트로 배포할 수 있게 됩니다.
ACK는 어디에 들어가나
UDP에는 ACK가 없습니다. QUIC은 UDP 페이로드 안에 ACK 프레임을 직접 써넣습니다.
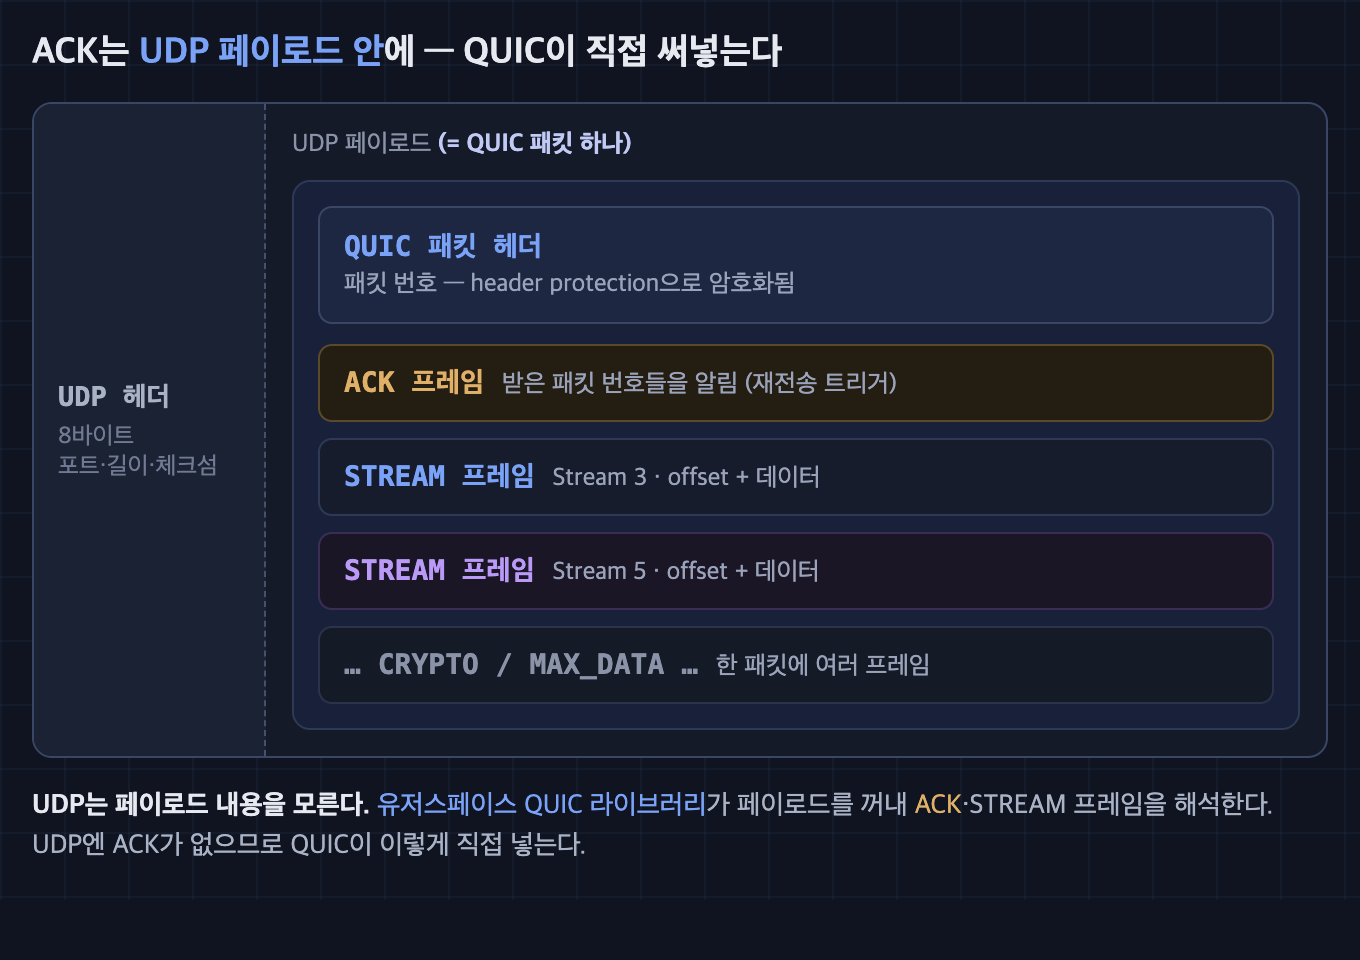
UDP는 페이로드 내용을 모릅니다. 유저스페이스 QUIC 라이브러리가 페이로드를 꺼내 ACK·STREAM 프레임을 해석합니다.
6. QUIC, HTTP/3, UDP는 각각 무엇인가
용어가 자주 섞여서 한 번 정리하고 가겠습니다.
- HTTP/3 ≠ QUIC입니다. HTTP/3는 애플리케이션 계층, QUIC은 전송 기능입니다.
HTTP/2 : TCP = HTTP/3 : QUIC로 대응시키면 깔끔합니다. - QUIC은 HTTP 전용이 아닙니다. DNS over QUIC처럼 다른 용도로도 쓰입니다. 반대로 HTTP/3는 QUIC 없이는 정의되지 않습니다.
- 계층 모델로 보면 UDP가 진짜 L4이고, QUIC은 그 위에 얹힌 유저스페이스 전송 구현이라 교과서적 계층 모델에 깔끔히 들어맞지 않습니다.
QUIC이 굳이 UDP를 택한 이유는 ossification 회피입니다. NAT·방화벽 같은 미들박스는 자기가 모르는 새로운 L4 프로토콜을 차단하는 경향이 있습니다. 이미 널리 통과되는 UDP 위에 얹으면 이 차단을 피할 수 있습니다.
7. QUIC에 통합된 TLS
QUIC에서 TLS는 별도 레이어가 아니라 프로토콜 안에 통합되어 있습니다.
- 암호화가 필수입니다. 평문 QUIC은 없고, TLS 1.3만 사용합니다.
- 핸드셰이크가 통합되어 연결 수립이 1-RTT(재연결은 0-RTT)에 끝납니다. TCP+TLS가 2~3 RTT인 것과 대비됩니다.
- TLS 1.3 핸드셰이크 메시지는 QUIC의 CRYPTO 프레임에 담겨 전달됩니다.
- 역할 분담이 명확합니다. TLS는 키 교환·인증·키 생성을 맡고, 실제 패킷 암호화는 QUIC이 수행합니다.
- TCP+TLS는 TCP 헤더가 평문이지만, QUIC은 패킷 번호 같은 헤더까지 암호화(header protection)합니다. 미들박스가 끼어들어 내용을 보고 간섭하기 어렵게 만든 설계입니다.
8. QUIC도 지연되는 경우: 스트림 내부
QUIC이 HOL 블로킹을 "없앤다"는 말은 정확히는 스트림 간(inter-stream) HOL을 없앤다는 뜻입니다. 한 스트림 내부의 순서 보장 비용까지 사라지는 것은 아닙니다.
Packet #2 끝:   Stream A offset 0~499    ✗ 손실
Packet #3 시작: Stream A offset 500~999  ✓ 도착
  → Stream A는 offset 0~499에 구멍 → 재전송까지 대기 (지연 발생)
같은 스트림 안에서 앞 오프셋이 손실되면, 뒤 오프셋은 도착했어도 재전송을 기다려야 합니다. 스트림 내부에서는 여전히 순서가 보장되어야 하기 때문입니다.
| 손실 상황 | Stream A (손실) | Stream B (무관) |
|---|---|---|
| TCP | 지연 | 지연 ← 무관한데도 막힘 |
| QUIC | 지연 | 정상 ← 통과 |
TCP는 무관한 Stream B까지 막지만, QUIC은 Stream B를 통과시킵니다. QUIC이 제거한 것은 정확히 이 "무관한데도 막히는" 부분입니다.
9. 유저스페이스라는 선택의 대가
QUIC이 신뢰성 로직을 유저스페이스에 둔 1차적 이유는 **배포 가능성(deployability)**입니다.
- 커널에 박으면 전 세계 OS 업데이트가 필요해 수년이 걸리고, 미들박스 차단 문제도 남습니다. TCP가 겪은 ossification이 그 결과입니다.
- 앱 안에 넣으면 앱 업데이트만으로 즉시 배포되고, UDP라 미들박스도 통과합니다.
대신 성능 비용이 실재합니다.
- UDP 데이터그램이 패킷마다 커널↔유저스페이스를 오가며 syscall 오버헤드가 붙습니다.
- 암호화도 유저스페이스에서 처리하고, TCP가 받는 NIC 하드웨어 오프로드의 혜택을 받기 어렵습니다.
- 초기 QUIC은 TCP+TLS 대비 CPU를 2~3배가량 더 썼습니다.
이를 줄이는 기법들이 나와 있습니다. recvmmsg/sendmmsg로 syscall을 배칭하고, GSO/GRO로 세그멘테이션을 오프로드하고, AF_XDP·io_uring·DPDK 같은 kernel-bypass를 쓰고, NIC 하드웨어 오프로드를 활용하는 식입니다.
in-kernel QUIC, 그리고 예상 밖의 결과
이 흐름은 LWN의 QUIC for the kernel(Jonathan Corbet, 2025-07-22)에 잘 정리되어 있습니다. Xin Long이 메인라인 지원을 위한 첫 패치셋을 올렸고, 구현 자체는 lxin/quic 레포(In-kernel QUIC implementation with Userspace handshake)에서 모듈과 libquic로 함께 개발되고 있습니다. 두 자료가 in-kernel QUIC의 설계와 현황을 따라가기에 좋은 출발점이라고 생각합니다.
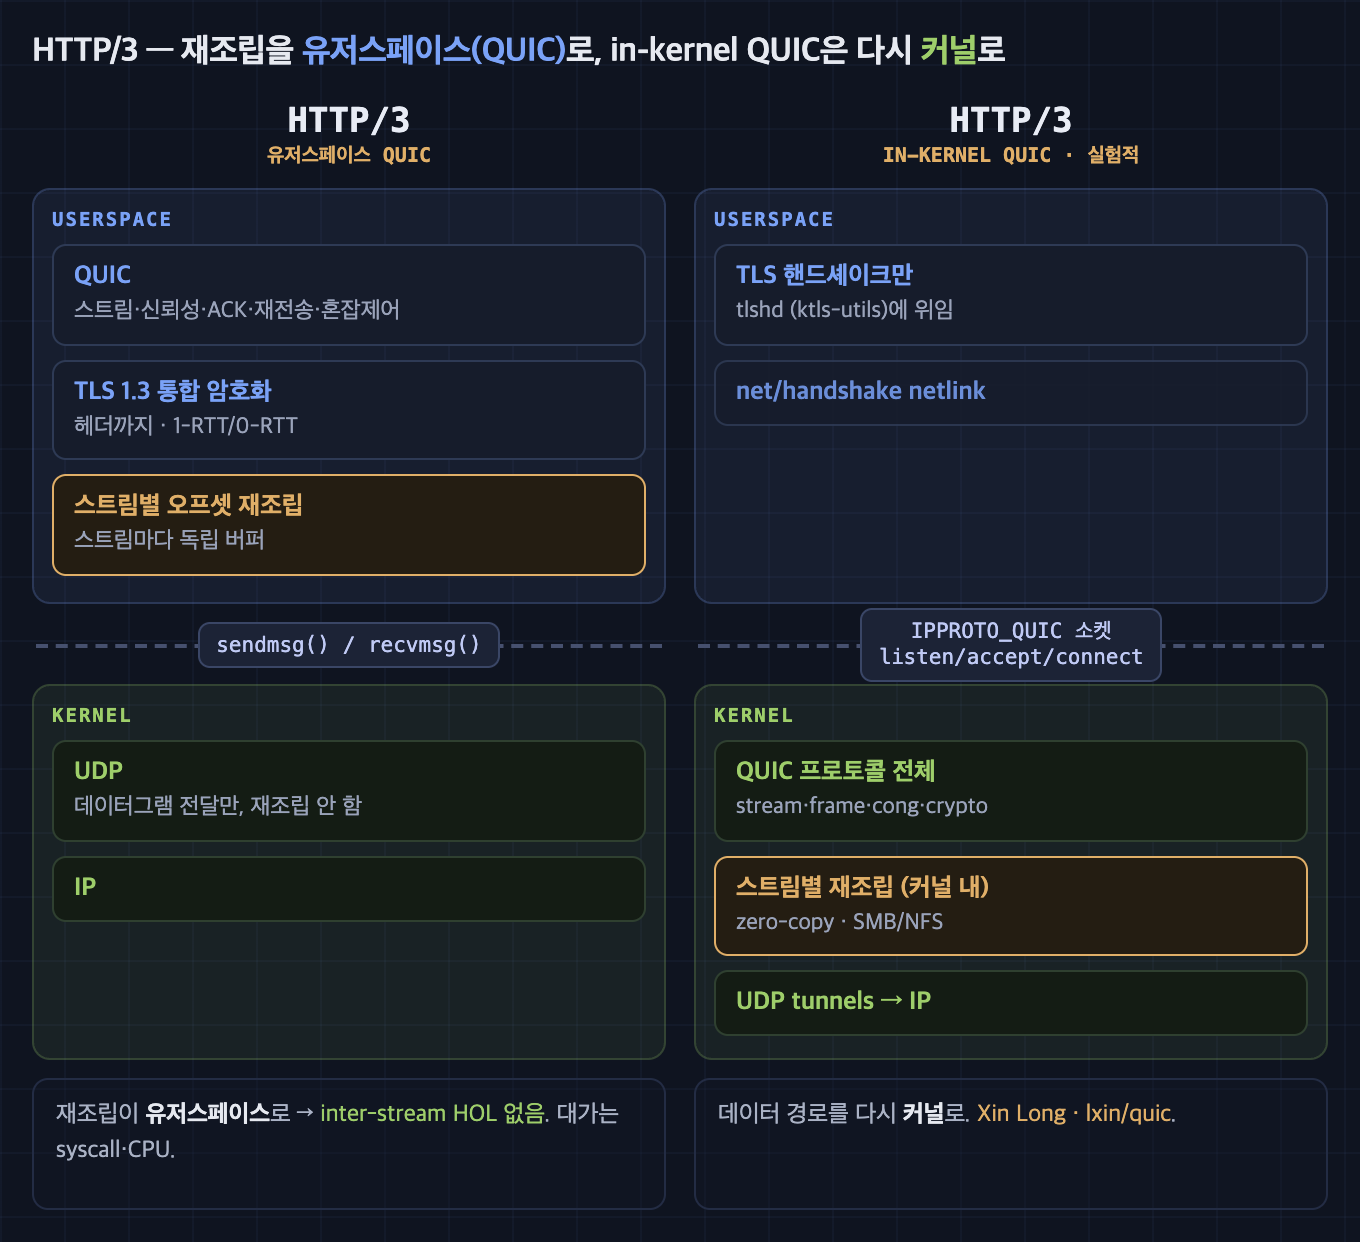
설계의 골자는 "QUIC 본체는 커널, TLS 핸드셰이크만 유저스페이스"입니다.
- ULP 레이어를 쓰지 않고
IPPROTO_QUIC소켓 타입(IPPROTO_MPTCP와 유사)을 만들어 UDP 터널 위에서 동작시킵니다.socket()·bind()·connect()·listen()·accept()·sendmsg/recvmsg·get/setsockopt같은 POSIX 소켓 시맨틱을 그대로 따릅니다. - 인증서 검증 같은 정책성 작업이 많은 TLS 핸드셰이크는 in-kernel TLS와 같은 방식으로 유저스페이스에 위임합니다. 커널이
net/handshakenetlink로 요청을 올리면ktls-utils의tlshd서비스(또는libquic)가 처리하고, 협상 결과는 cmsg로 커널에 전달됩니다. - ALPN 기반 디스패칭으로 한 포트에 온 QUIC 연결을 ALPN 식별자에 따라 여러 유저스페이스 프로세스로 demux할 수 있고, SMB·NFS 같은 커널 서브시스템이 핸드셰이크 이후 표준 커널 전송 인터페이스로 QUIC을 그대로 쓸 수 있게 합니다.
- 지원 RFC: RFC 9000/9001/9002(전송·TLS·손실복구), 9221(DATAGRAM), 9287·9368·9369. 커널 6.1 이상이 필요합니다.
다만 아직 초기입니다. LWN에 따르면 첫 패치셋은 9,000줄이 조금 넘는 저수준 코드뿐이고 나머지 구현은 예고만 된 상태라, 빨라도 2026년경 메인라인 진입이 전망됩니다. 그럼에도 Samba(MR 머지됨), 커널 SMB/NFS, curl 쪽에서 채택 관심이 이어지고 있습니다.
흥미로운 부분은 커널로 옮겨도 아직 TCP보다 느리다는 점입니다. LWN이 인용한 패치 벤치마크 기준입니다.
- in-kernel QUIC vs in-kernel TLS → 일부 테스트에서 TLS가 약 3배 처리량.
- 암호화를 끈 QUIC vs 순수 TCP → 일부 테스트에서 TCP가 4배 이상 빠름.
원인은 segmentation offload 부재, 전송 경로의 추가 데이터 복사, QUIC 헤더 암호화입니다. 즉 처리량 격차의 주된 원인은 "커널이냐 유저스페이스냐"보다 하드웨어 오프로드의 유무에 가깝다고 읽힙니다. NIC 벤더의 QUIC 오프로드가 보급되면 이 격차는 줄어들 것으로 보입니다.
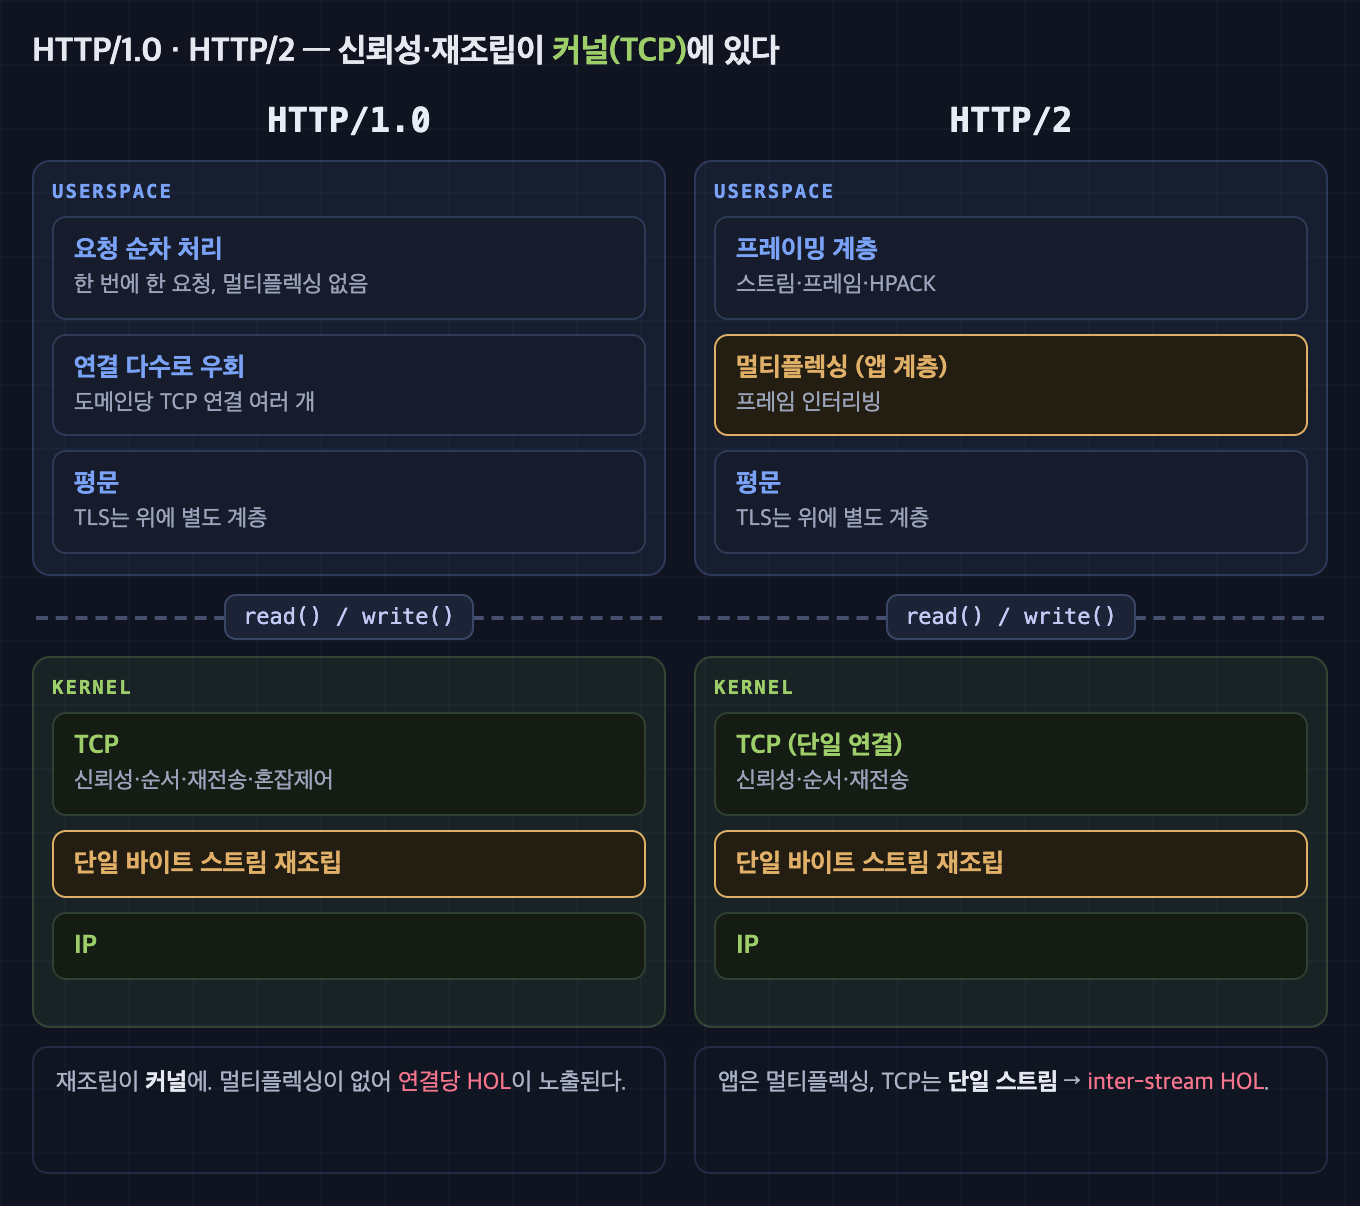
여기까지의 이야기를 HTTP/1.0·HTTP/2·HTTP/3로 나란히 놓고, 신뢰성·재조립 로직이 커널과 유저 공간 중 어디에 있는지로 정리하면 다음과 같습니다. in-kernel QUIC은 그 경계를 다시 커널 쪽으로 옮기려는 시도입니다.
10. 그래서 QUIC은 쓸모가 있는가
"벤치마크에서 TCP보다 느리니 QUIC은 쓸모없다"는 결론을 종종 보는데, 그 벤치마크들이 측정한 지표(bulk throughput, server CPU)가 QUIC의 강점 영역이 아니었고, 측정 대상(초기 커널 구현)이 미성숙했던 영향이 큽니다.
QUIC이 실제로 이기는 영역은 다음과 같습니다.
- 연결 수립 지연: 1-RTT, 재연결 0-RTT.
- 손실 환경에서의 HOL 회피: 모바일·Wi-Fi처럼 손실이 잦은 망.
- Connection Migration: IP가 바뀌어도(Wi-Fi↔LTE) Connection ID 기반으로 연결을 유지합니다. TCP는 4-tuple이 바뀌면 연결이 끊깁니다.
- 짧은 요청이 다수일 때의 연결 비용 절감.
실제로 Google(검색·YouTube·Gmail), Meta, Cloudflare, Akamai, Microsoft 등이 프로덕션에서 대규모로 운영 중이고, 인터넷 트래픽의 상당 비중이 이미 QUIC입니다. 정리하면 QUIC은 서버 CPU 효율을 일부 희생하는 대신, 사용자 체감 지연과 불안정한 네트워크에서의 견고성을 얻는 트레이드오프라고 생각합니다.
11. 유스케이스별 적합성
판단 기준을 단순화하면 이렇게 갈립니다.
QUIC 유리:   RTT 길다 / 손실 있다 / 네트워크 전환 / 짧은 요청 多 / 병렬 스트림
QUIC 불리:   손실 0% & RTT≈0 (DC 내부) / 단일 대용량 전송 / UDP 차단 / 신뢰성 불필요
| 유스케이스 | 적합도 | 핵심 이유 |
|---|---|---|
| 모바일 웹 / HTTP/3 | ✅✅ | RTT↓, 손실·전환에 강함, 병렬 요청 |
| 동영상 VOD (YouTube) | ✅✅ | 청크 다수 + 모바일 + migration |
| 공용 API 엔드포인트 | ✅ | 짧은 호출 多, 연결 비용↓ |
| 실시간 게임 (상태 동기화) | ⚠️ | 신뢰성이 오히려 해로움 → DATAGRAM이면 가능 |
| 음성/영상 통화 | ⚠️ | 최신성 > 신뢰성, WebRTC 영역과 경쟁 |
| 저지연 라이브 스트리밍 | ⚠️ | 기술 발전 단계 |
| 데이터센터 내부 통신 | ❌ | 손실0·RTT≈0 → 강점 무의미, CPU만 손해 |
| 대용량 단일 전송 | ❌ | throughput·CPU 효율은 TCP 우위 |
| UDP 차단 환경 | ❌ | 접속 불가, TCP fallback 필수 |
| IoT 극저전력 | ❌ | 암호화·상태 관리 부담 |
여기서 한 가지 함정은 "실시간 = QUIC"이라는 등식입니다. 실시간 게임이나 통화의 상태·미디어 패킷은 최신성이 신뢰성보다 중요해서, 오래된 패킷은 버리는 편이 낫습니다. QUIC의 기본 신뢰성 스트림은 손실된 옛 패킷을 재전송하느라 최신 데이터를 막을 수 있습니다(스트림 내부 HOL).
이 경우의 해법이 **QUIC DATAGRAM 확장(RFC 9221)**입니다. 비신뢰·비순서 전송을 제공해서, 게임 상태는 DATAGRAM으로(UDP처럼) 보내고 채팅·매치메이킹은 신뢰성 스트림으로 보내는 하이브리드가 가능합니다. WebTransport, Media over QUIC이 이 방향을 잡고 있습니다.
TL;DR
- HTTP/2 멀티플렉싱은 프레임을 인터리빙하고 Stream ID로 재조립해 단일 TCP 연결로 동시성을 얻습니다. 하지만 그 동시성은 애플리케이션 계층에서 끝납니다.
- TCP는 out-of-order 세그먼트를 애플리케이션에 올려주지 않습니다. 그래서 한 스트림의 세그먼트 손실이 무관한 스트림까지 막는 inter-stream HOL 블로킹이 생깁니다.
- QUIC은 UDP 위에서 신뢰성을 유저스페이스에 재구현합니다. 재조립 버퍼가 유저스페이스에 있어 스트림별 독립 처리가 가능하고, 패킷 번호와 스트림 오프셋을 분리해 inter-stream HOL을 제거합니다.
- QUIC이 없애는 것은 inter-stream HOL이지 intra-stream HOL이 아닙니다. 같은 스트림 안에서는 여전히 순서를 기다립니다.
- 유저스페이스 선택의 대가로 CPU 비용이 들고, in-kernel QUIC도 아직 TCP보다 느립니다. 주된 원인은 커널/유저 구분보다 하드웨어 오프로드의 유무입니다.
- QUIC은 연결 지연·손실 환경·네트워크 전환에서 이기고, 안정망의 대용량 단일 전송에서는 TCP가 우위입니다. 신뢰성이 방해되는 실시간 트래픽은 DATAGRAM 확장이 답입니다.