
write()와 fsync() 사이, 데이터가 머무는 네 장소
개요
Redis의 AOF, MySQL의 redo log, Kafka의 세그먼트 파일은 모두 "저장했다"는 말을 자기 방식으로 정의합니다. 그 정의를 따라 내려가면 결국 같은 자리에 도착합니다. 프로그램이 write()를 부르고, 커널이 페이지 캐시에 받아 두고, 언젠가 fsync()가 디스크에 내려보내는 경로입니다. 이 시리즈는 오픈소스가 그 경로의 어느 지점에서 무엇을 호출하는지, 그 사이에 프로세스가 죽거나 전원이 나가면 어디까지 남는지를 실제로 실행하고 측정해서 확인하는 것을 목표로 합니다.
첫 글은 그 공통 경로 자체를 다룹니다. Go로 쓴 작은 프로그램을 Linux VM에서 돌리고, strace와 /proc/meminfo로 데이터가 어디에 있는지 따라갑니다. 본문의 수치와 실험 결과는 모두 실제 측정값입니다.
1. 실습 환경과 프로그램
실습은 Oracle Cloud의 arm64 VM에서 했습니다. 이 글의 주제가 커널과 디스크 사이의 경계라서, 환경의 어떤 값이 결과에 영향을 주는지 먼저 적어 둡니다.
| 항목 | 값 |
|---|---|
| OS / 커널 | Ubuntu 22.04.5, 6.8.0-1057-oracle, aarch64 |
| 디스크 | virtio-scsi Block Volume 46GB, 단일 파티션 |
| 파일시스템 | ext4, 4KB 블록, has_journal, metadata_csum, journal_checksum_v3 (crc32c) |
| 마운트 옵션 | rw,relatime,discard (data=ordered, commit=5 기본값) |
| 디스크 쓰기 캐시 | /sys/block/sda/queue/write_cache = write through, WCE=0 |
| dirty writeback | dirty_writeback_centisecs 500, dirty_expire_centisecs 3000 |
macOS에서 직접 하지 않은 이유가 있습니다. macOS의 fsync()는 디스크 캐시 flush를 보장하지 않아 F_FULLFSYNC라는 별도 fcntl이 있고, strace와 /proc이 없습니다. Linux 커널의 동작을 보려면 Linux 커널이 필요합니다.
프로그램은 파일을 열고 write()를 한 번 호출한 뒤 대기하는 것이 전부입니다. -sync를 주면 write() 직후 fsync()를 한 번 부릅니다.
package main

import (
	"bytes"
	"flag"
	"fmt"
	"os"
	"time"
)

func main() {
	sync := flag.Bool("sync", false, "write() 후 fsync() 호출")
	size := flag.Int("size", 1024, "쓸 바이트 수")
	flag.Parse()
	path := flag.Arg(0)

	f, err := os.OpenFile(path, os.O_CREATE|os.O_WRONLY|os.O_TRUNC, 0o644)
	if err != nil {
		panic(err)
	}

	data := bytes.Repeat([]byte("HELLO-FSYNC-LAB\n"), *size/16)
	n, err := f.Write(data) // write(2)를 직접 호출한다. stdio 버퍼가 없다
	if err != nil {
		panic(err)
	}
	fmt.Printf("pid=%d write()=%d bytes\n", os.Getpid(), n)

	if *sync {
		if err := f.Sync(); err != nil { // Linux에서는 fsync(2)
			panic(err)
		}
		fmt.Println("fsync() done")
	}

	fmt.Println("waiting... (kill -9 or sysrq to test)")
	time.Sleep(24 * time.Hour)
}
Go를 고른 이유는 관찰이 깨끗하기 때문입니다. Go의 File.Write는 libc의 stdio 버퍼를 거치지 않고 write(2)를 바로 호출하므로, 코드의 Write 한 줄이 시스템콜 한 번에 대응합니다. File.Sync는 Linux에서 fsync(2)입니다. 맥에서 GOOS=linux GOARCH=arm64로 빌드해 VM에 올렸습니다.
NOTEstrace는 프로세스가 커널에 요청하는 시스템콜을 가로채 한 줄씩 보여주는 도구입니다. 커널의 ptrace 기능으로 대상 프로세스를 시스템콜 진입과 복귀 시점에 멈추고 레지스터에서 인자와 반환값을 읽습니다. 프로그램을 고치지 않고 "커널에 실제로 무엇을 시켰나"를 볼 수 있지만, 그 요청이 커널 안에서 어디까지 갔는지는 보여주지 않습니다. 멈추고 깨우는 비용 때문에 시스템콜이 많은 프로세스는 수 배 느려지므로 운영 중인 서비스에는 붙이지 않습니다.
2. write()가 반환됐다는 것
먼저 fsync 없이 1024바이트를 쓰는 경우를 strace로 봅니다.
$ strace -f -T -e trace=openat,write,fsync,fdatasync ./write1 a.txt
...
[pid 3364835] openat(AT_FDCWD, "a.txt", O_WRONLY|O_CREAT|O_TRUNC|O_CLOEXEC, 0644) = 3 <0.000083>
[pid 3364835] write(3, "HELLO-FSYNC-LAB\nHELLO-FSYNC-LAB\n"..., 1024) = 1024 <0.000041>
[pid 3364835] write(1, "pid=3364835 write()=1024 bytes\n", 31) = 31 <0.000012>
-f는 Go 런타임이 만드는 스레드까지 따라가기 위한 옵션이고, -e trace=는 런타임의 mmap, futex, clone 호출 수백 줄을 걷어내기 위한 필터입니다. 첫 줄의 write(3, ...)이 파일 쓰기이고, 그 아래 write(1, ...)은 fmt.Printf입니다. 터미널 출력도 커널 경계에서는 같은 시스템콜입니다.
볼 것은 두 가지입니다. fsync 호출이 없다는 것과, write()가 41마이크로초 만에 1024바이트 전부를 받았다고 돌아왔다는 것입니다. 네트워크 블록 스토리지에 쓰기가 완료되기에는 짧은 시간이므로, 이 반환값은 디스크 도달과 무관한 무언가를 뜻해야 합니다.
write()가 보증하는 것은 "커널이 이 바이트들을 페이지 캐시로 복사해 받아들였다"까지입니다. 그 페이지에는 디스크 원본과 다르다는 표시가 붙고, 이 상태를 dirty라고 부릅니다. 이후에 그 페이지를 디스크로 내려보내는 일은 write()의 계약 밖입니다.
3. 데이터가 머무는 네 장소
write()에서 fsync()까지를 따라가려면 데이터가 있을 수 있는 장소를 먼저 나눠야 합니다. RAM에 하나, 디스크에 셋입니다.
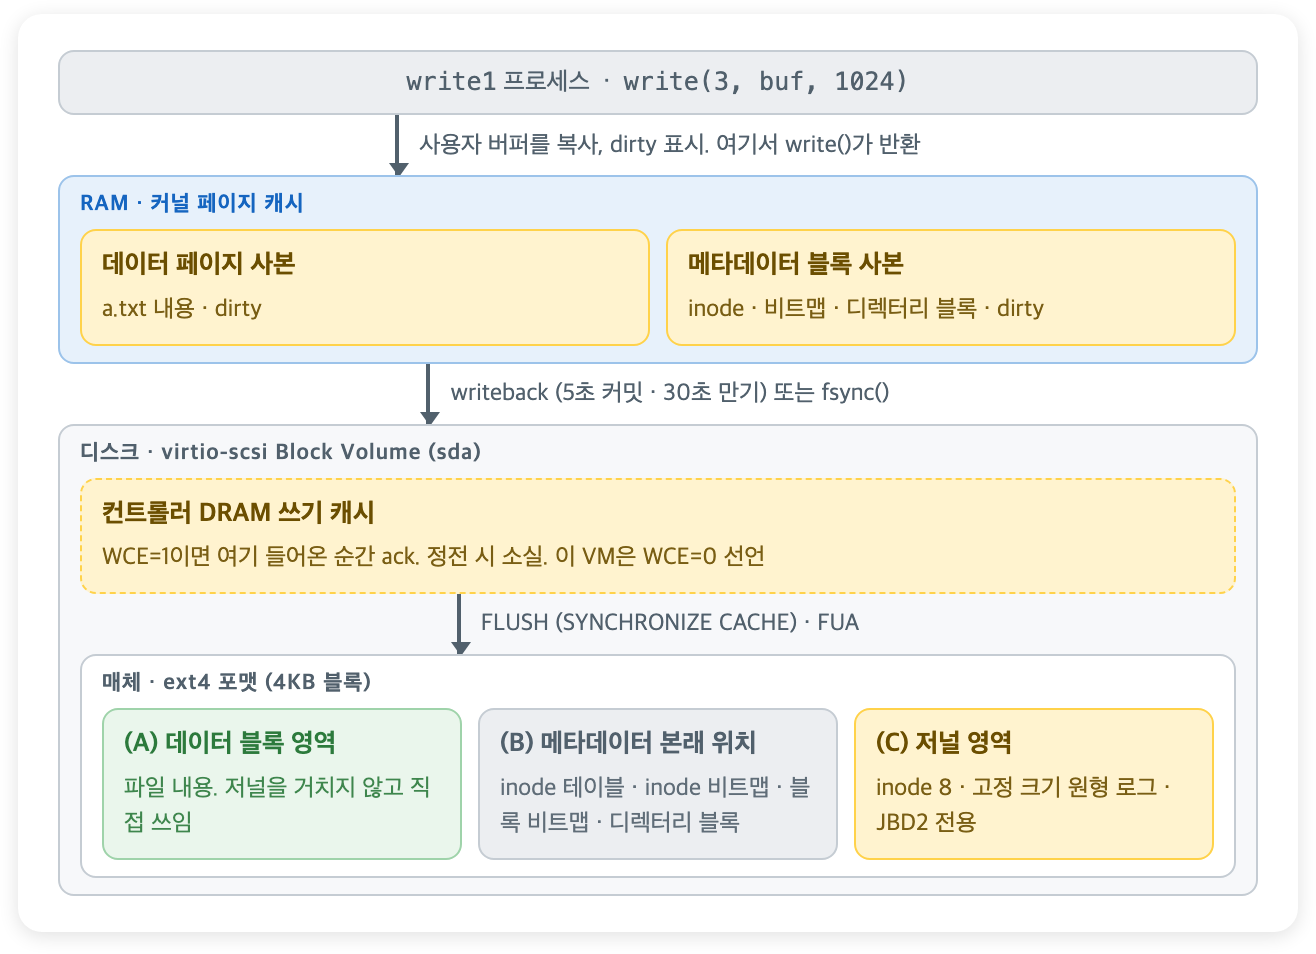
RAM, 커널 페이지 캐시. 파일 내용을 4KB 페이지 단위로 들고 있는 커널 메모리입니다. 파일 데이터만이 아니라 inode, 비트맵, 디렉터리 블록 같은 파일시스템 구조체도 여기 올라옵니다. 프로세스 소유가 아니라 커널 소유라는 점이 뒤에 나오는 실험 C의 결과를 결정합니다.
(A) 데이터 블록 영역. 파일 내용이 놓이는 디스크 블록들입니다.
(B) 메타데이터 본래 위치. inode 테이블, inode 비트맵, 블록 비트맵, 디렉터리 블록, 그룹 디스크립터가 각자 정해진 번호의 디스크 블록에 고정으로 놓여 있습니다.
(C) 저널 영역. ext4가 포맷 시점에 예약해 둔 고정 크기의 원형 로그입니다. 이 VM에서는 inode 8번이 그 영역이고, JBD2만 접근합니다.
"블록"이라는 말은 이 글에서 두 개체를 가리킵니다. 디스크 위의 4KB 원본과, 커널이 그것을 고치기 위해 RAM에 읽어 둔 사본입니다. CPU는 디스크를 직접 고칠 수 없으므로 모든 변경은 RAM 사본에 일어나고, 사본이 원본과 달라지면 dirty가 됩니다. 사본을 같은 번호의 디스크 블록에 다시 쓰면 원본이 갱신되고 dirty가 풀립니다. 정전이 나면 RAM 사본은 전부 사라지고 디스크 원본만 남습니다. 뒤에서 "메타데이터 사본이 dirty"라고 쓰면 이 RAM 사본을 뜻합니다.
NOTEext4와 JBD2(Journaling Block Device 2) 는 역할이 나뉩니다. ext4는 파일시스템이고 저널 영역 (C)를 소유하지만, 거기에 쓰고 커밋하고 복구하는 코드는 갖고 있지 않습니다. 그 일은 ext3 시절 범용 계층으로 분리된 JBD2가 맡고, ext4는 "이 메타데이터 블록들이 한 트랜잭션이다"라고 알려주기만 합니다. 커널 스레드
jbd2/sda1-8이 그 담당자이고, 이름은 sda1의 inode 8번 저널이라는 뜻입니다. XFS나 btrfs는 자기 저널 코드를 직접 갖고 있어 JBD2와 무관합니다.
디스크 쪽에도 캐시가 한 층 더 있습니다. HDD와 SSD의 컨트롤러 기판에는 수십에서 수백 MB의 DRAM이 있고, 장치는 쓰기가 이 DRAM에 들어온 순간 완료(ack)를 돌려준 뒤 나중에 유리한 순서로 매체에 씁니다. 정전이면 이 DRAM의 내용도 사라집니다. 그래서 fsync()는 두 층을 건너야 하는 요청입니다. 페이지 캐시의 dirty를 장치까지 내려보내는 일과, 장치의 DRAM을 매체까지 비우게 하는 일입니다.
NOTESCSI, mode page, WCE. SCSI는 호스트가 저장 장치에 명령을 보내는 명령어 집합입니다. 원래는 병렬 케이블 규격이었지만 지금은 명령어 집합만 남아 SAS, USB 저장장치, iSCSI, 그리고 이 VM의 virtio-scsi 위에서 쓰입니다. 장치는 자기 설정값을 mode page라는 구조체로 노출하고, 그중 8번 Caching mode page의 WCE(Write Cache Enable) 비트가 "나는 휘발성 쓰기 캐시를 켜 두었다"는 선언입니다. Linux의 sd 드라이버가 디스크를 붙일 때 이 비트를 읽어
/sys/block/sda/queue/write_cache를 write back 또는 write through로 세팅합니다. NVMe는 SCSI가 아닌 별도 명령어 집합이지만 같은 개념의 Volatile Write Cache 비트를 갖습니다.
이 VM의 디스크는 WCE=0을 선언하고 있고, 값을 바꿀 수도 없습니다.
$ cat /sys/block/sda/queue/write_cache
write through
$ sudo sdparm --get WCE /dev/sda
WCE           0  [cha: n, def:  0]
이 선언이 뒤에서 fsync()의 마지막 단계를 바꿉니다. 7절에서 다시 다룹니다.
4. 커널은 스스로 내려보낸다 (실험 B)
write()가 페이지 캐시에서 끝난다면, fsync를 부르지 않는 프로그램의 데이터는 언제 디스크로 가는지 봅니다. 시스템 전체의 dirty 페이지 합계는 /proc/meminfo의 Dirty로 읽을 수 있습니다. 1KB는 배경 잡음에 묻혀서 32MB를 썼습니다.
$ grep -E '^(Dirty|Writeback):' /proc/meminfo
Dirty:               592 kB
Writeback:             0 kB
$ ./write1 -size 33554432 b.txt &
pid=3378566 write()=33554432 bytes
1초 뒤부터 5초 간격으로 읽은 값입니다.
| 시점 | Dirty |
|---|---|
| write() 전 | 592 kB |
| write() 후 1초 | 33,360 kB |
| 6초 | 636 kB |
| 11초 | 600 kB |
| 31초 | 268 kB |
write() 직후 Dirty가 정확히 32MB 늘었고, 프로그램은 계속 대기 중인데 6초 시점에는 이미 원래 수준으로 돌아왔습니다. 그동안 다른 프로세스에서 head -c 32 b.txt를 실행하면 내용이 그대로 읽힙니다. 읽는 쪽이 디스크가 아니라 페이지 캐시를 보기 때문입니다.
아무도 fsync를 부르지 않았는데 6초 안에 내려간 것은 커널에 자기 주기로 dirty를 정리하는 주체가 둘 있기 때문입니다.
- jbd2의 주기 커밋.
jbd2/sda1-8은 5초(commit=5)마다 열려 있는 트랜잭션을 커밋합니다. ext4의 기본 모드 data=ordered에서는 커밋 전에 그 트랜잭션에 속한 inode의 dirty 데이터 페이지를 먼저 (A)에 내려보내야 하므로, 파일 크기가 바뀐 b.txt의 32MB가 이 경로로 함께 내려갔습니다. 6초 시점에 Dirty가 사라진 것은 이 경로입니다. - flusher 스레드의 writeback.
dirty_writeback_centisecs(5초)마다 깨어나dirty_expire_centisecs(30초)를 넘긴 dirty 페이지를 내려보냅니다. 저널과 무관하게 모든 dirty 페이지에 적용되는 일반 규칙입니다. 새 블록 할당 없이 기존 내용만 덮어쓰는 경우에는 이 30초 경로만 남습니다.
fsync()가 하는 일은 "내려보내라"가 아닙니다. 내려보내는 것은 커널이 언젠가 알아서 합니다. fsync()는 "지금 당장 내려보내고 끝날 때까지 나를 기다리게 하라"는 요청이고, fsync 없는 프로그램의 위험은 데이터가 안 내려가는 것이 아니라 언제 내려갔는지 프로그램이 알 수 없다는 것입니다.
5. 프로세스가 죽어도 페이지 캐시는 남는다 (실험 C)
write() 직후 프로세스를 kill -9로 죽입니다.
$ ./write1 c.txt &
pid=3378671 write()=1024 bytes
$ kill -9 %1
$ ls -l c.txt
-rw-r--r-- 1 ubuntu ubuntu 1024 Sep  4 07:23 c.txt
$ head -c 32 c.txt
HELLO-FSYNC-LAB
HELLO-FSYNC-LAB
kill -9는 프로세스의 메모리를 회수하지만 페이지 캐시는 프로세스의 것이 아니라 커널의 것입니다. dirty 페이지는 그대로 남고, 커널이 4절의 두 경로로 평소처럼 내려보냅니다. OOM killer에 죽는 경우도 같습니다. 프로세스가 write()까지 마쳤다면 그 데이터는 프로세스의 생사와 무관하게 보존됩니다.
이 결과가 뒤의 정전 실험과 갈리는 지점입니다. 프로세스 죽음은 RAM 사본을 건드리지 않고, 정전과 커널 패닉은 RAM 사본을 전부 지웁니다. "인스턴스가 꺼졌다"는 말이 이 둘 중 어느 쪽인지에 따라 데이터베이스와 캐시 서버의 방어선이 완전히 달라지므로, 이후 시리즈에서도 계속 두 경우를 나눠 봅니다.
6. fsync()가 실제로 하는 일
-sync를 주고 같은 프로그램을 돌립니다.
$ strace -f -T -e trace=openat,write,fsync ./write1 -sync s.txt
[pid 3378561] openat(AT_FDCWD, "s.txt", O_WRONLY|O_CREAT|O_TRUNC|O_CLOEXEC, 0644) = 3 <0.000059>
[pid 3378561] write(3, "HELLO-FSYNC-LAB\nHELLO-FSYNC-LAB\n"..., 1024) = 1024 <0.000045>
[pid 3378561] fsync(3)                  = 0 <0.002563>
write()는 45마이크로초, fsync()는 2.56밀리초입니다. 약 57배 차이이고, 이 2.5밀리초 안에서 일어나는 일이 이 절의 내용입니다.
저널이 필요한 이유
새 파일에 1024바이트를 쓰는 작업은 (B)의 여러 블록을 고칩니다. openat(O_CREAT) 시점에만 세 블록입니다.
| 디스크 블록 | 담는 것 | 고치는 내용 |
|---|---|---|
| 디렉터리 블록 | 파일명과 inode 번호의 목록 | a.txt → 1234 한 줄 추가 |
| inode 비트맵 블록 | inode 번호별 사용 여부 1비트 | 1234번을 1로 |
| inode 테이블 블록 | inode 구조체의 배열 | 1234번 자리에 소유자, 권한, 크기 0 |
이후 데이터 블록을 배정할 때 블록 비트맵과 그룹 디스크립터가 추가되고, inode 테이블 블록은 크기와 블록 목록이 바뀌어 다시 고쳐집니다. 서로 다른 위치의 블록 다섯 종류가 한 작업으로 바뀌는데, 디스크가 원자적으로 쓸 수 있는 단위는 섹터 하나입니다. 이 블록들을 (B)에 바로 쓰다가 중간에 정전이 나면 절반만 반영된 구조가 남습니다. 비트맵은 사용 중인데 가리키는 inode가 없으면 블록이 새고, inode는 가리키는데 비트맵은 비어 있으면 나중에 같은 블록이 다른 파일에 또 배정되어 두 파일이 한 블록을 공유하게 됩니다. ext2 시절에는 부팅 때 fsck로 디스크 전체를 훑어 이런 불일치를 고쳤고, 디스크가 커지면서 이 시간이 감당이 안 되자 저널링이 도입됐습니다.
저널의 방식은 흩어진 쓰기를 (C)에 모아 쓰고, 마지막에 블록 하나짜리 커밋 레코드로 전부를 확정하는 것입니다. 커밋 전까지 (B)는 옛 값으로 온전히 남고, 커밋 후에는 (C)의 사본으로 (B)를 복원할 수 있습니다.
파일 내용은 이 보호를 받지 않습니다. 내용은 구조가 아니라서 절반만 쓰여도 파일시스템 자체는 마운트되고, 양이 압도적으로 많아 두 번 쓰면 쓰기 성능이 절반이 됩니다. 기본 모드 data=ordered는 데이터를 (A)에 직접 쓰되 한 가지 순서만 강제합니다. 커밋 레코드보다 먼저 도착해야 한다는 것입니다. 순서가 반대면 inode에는 "블록 #N에 1024바이트"라고 커밋됐는데 #N에는 이전 파일의 잔해가 있는 상태가 남습니다.
NOTEext4의 data= 모드 세 가지.
ordered(기본)는 메타데이터만 저널에 넣고 데이터는 커밋 전에 먼저 쓰도록 순서를 강제합니다.writeback은 이 순서도 보장하지 않아 정전 후 파일에 옛 잔해가 보일 수 있고 대신 빠릅니다.journal은 데이터까지 저널에 넣어 두 번 쓰기 때문에 거의 쓰이지 않습니다. 이 글의 모든 설명은 ordered 기준입니다.
단계별 진행
새 파일 a.txt에 1024바이트를 쓰고 fsync()하는 경우를 RAM 사본과 (A), (B), (C)의 상태로 따라갑니다.
단계 0, openat(O_CREAT). 위 표의 세 블록을 RAM에 읽어 사본을 고칩니다. 세 사본이 dirty가 되고 JBD2의 현재 트랜잭션에 등록됩니다. 디스크는 A, B, C 모두 무변화입니다.
단계 1, write(). 사용자 버퍼를 a.txt 첫 페이지의 RAM 사본으로 복사합니다. inode 사본의 크기가 1024로 바뀝니다. 어느 디스크 블록에 놓을지는 아직 정하지 않습니다(delayed allocation). 디스크는 무변화이고, 여기서 write()가 반환됩니다.
단계 2, 데이터 writeback. fsync()에 진입한 ext4가 이 파일의 dirty 데이터 페이지를 내려보냅니다. 이때 블록 #N을 배정하므로 블록 비트맵과 그룹 디스크립터 사본이 dirty가 되어 트랜잭션에 추가되고, inode 사본의 블록 목록도 갱신됩니다. 데이터 페이지를 (A)의 #N에 쓰고 완료를 기다립니다.
단계 3, 사본 쓰기. ext4가 JBD2에 커밋을 요청합니다. JBD2는 트랜잭션에 등록된 dirty 메타데이터 사본 다섯 종류의 내용을 (C)에 이어 씁니다. 앞에는 각 사본이 (B)의 몇 번 블록으로 갈 것인지 적은 디스크립터 블록이 붙습니다. RAM 사본들은 여전히 dirty입니다. (C)에 썼다고 clean이 되지는 않습니다.
단계 4, 커밋 레코드. JBD2가 (C)에 커밋 레코드 한 블록을 씁니다. 순번과 crc32c 체크섬이 들어 있습니다. 완료되면 fsync()가 반환됩니다. 커밋 레코드는 어디로도 복사되지 않습니다. 본래 위치가 없고, (C) 안에서 "이 앞의 사본들은 확정됐다"는 표시로 놓이는 것이 역할의 전부입니다.
단계 5, checkpoint. RAM의 dirty 메타데이터 사본들을 (B)의 각 원본 자리에 씁니다. (C)를 읽어서 옮기는 것이 아니라 RAM에서 쓰는 것입니다. (C)의 사본은 정전 대비용이고, 실제로 (C)를 읽는 것은 재부팅 후 복구 때만입니다. 계기는 둘 중 먼저 오는 쪽입니다. 4절의 30초 writeback이거나, (C)가 고정 크기 원형 버퍼라서 새 트랜잭션 자리가 없을 때 가장 오래된 커밋 완료 트랜잭션의 사본을 즉시 내려보내는 경우입니다. 끝나면 RAM 사본은 clean이 되고 (C)의 그 공간은 재사용 대상이 됩니다.
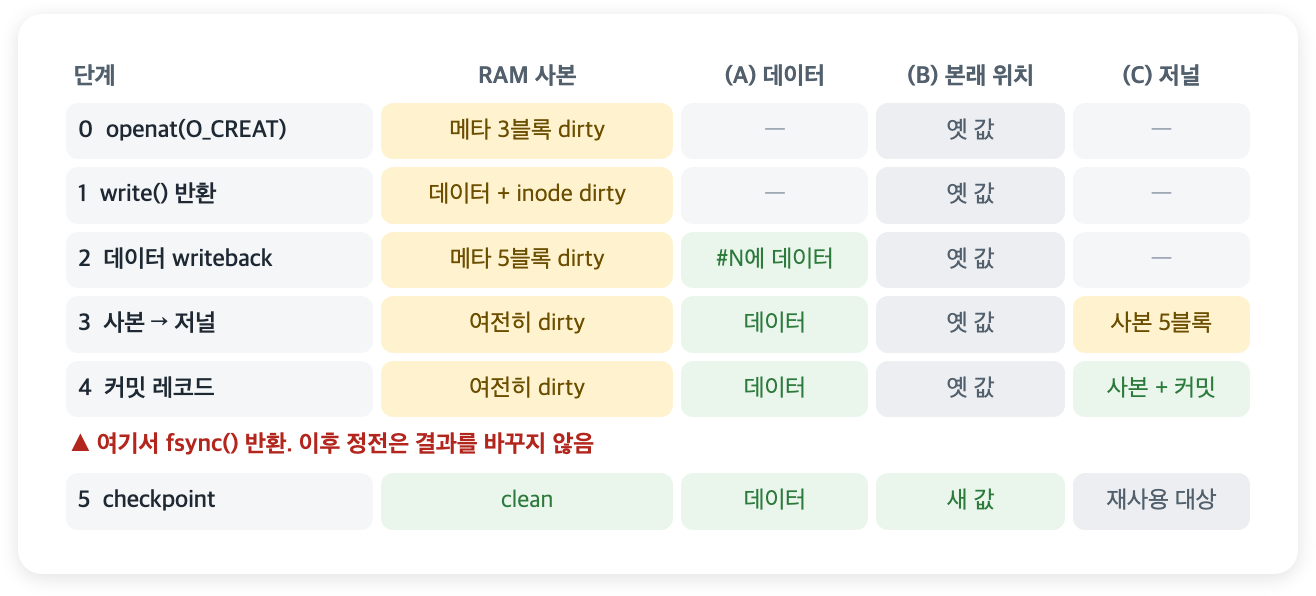
정리하면 메타데이터는 RAM 사본에서 두 번 나갑니다. 커밋 때 (C)로, checkpoint 때 (B)로. 데이터는 (A)로 한 번, 커밋 레코드는 (C)에서 끝입니다. 이 VM에서 fsync()의 2.5밀리초는 단계 2에서 4까지, 즉 네트워크 블록 스토리지에 데이터 1블록과 저널 6~7블록을 쓰고 각각의 완료를 기다린 시간입니다.
7. 커밋 레코드와 FLUSH
커밋 레코드가 스위치가 되는 조건
재부팅 시 JBD2는 (C)를 처음부터 읽습니다. 디스크립터, 사본들, 커밋 레코드가 온전히 있는 트랜잭션은 사본을 (B)에 덮어써 재적용하고, 커밋 레코드가 없거나 순번이 안 맞거나 체크섬이 틀리면 거기서 멈추고 나머지는 읽지 않습니다. 능동적으로 지우는 것이 아니라 무시하고, 그 공간은 다음 트랜잭션이 덮어씁니다.
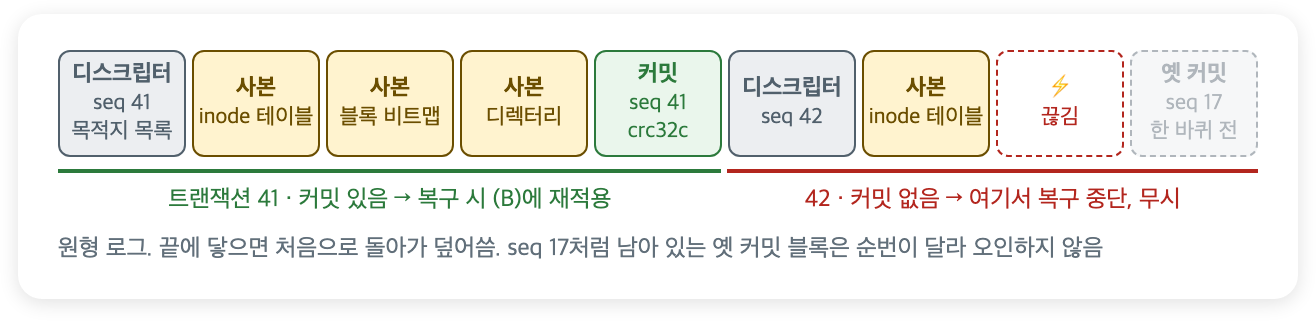
커밋 레코드 하나가 여러 블록에 걸친 변경 전부를 확정할 수 있는 조건은 두 가지입니다. 첫째, 커밋 레코드는 블록 하나짜리 쓰기라서 "있다" 또는 "없다" 둘 중 하나입니다. 여러 블록 변경의 원자성을 한 블록 쓰기의 원자성으로 환원한 것입니다. 둘째, 커밋 레코드가 사본들보다 나중에 매체에 도착해야 합니다. 이 두 번째 조건이 3절의 디스크 DRAM 캐시와 부딪힙니다.
순서 뒤바뀜과 FLUSH
커널은 사본 쓰기 요청의 완료를 기다린 뒤에야 커밋 레코드 요청을 보내므로, 커널이 장치에 넘기는 순서는 확실히 사본이 먼저입니다. 문제는 그 완료의 의미입니다. WCE=1인 장치는 데이터가 DRAM 캐시에 들어온 순간 ack를 돌려주므로, 커널이 "사본 완료"라고 아는 시점에 사본은 아직 매체에 없을 수 있습니다. 그 뒤 커밋 레코드가 캐시에 들어오면 장치는 캐시 안의 둘을 자기 편한 순서로 매체에 내립니다.
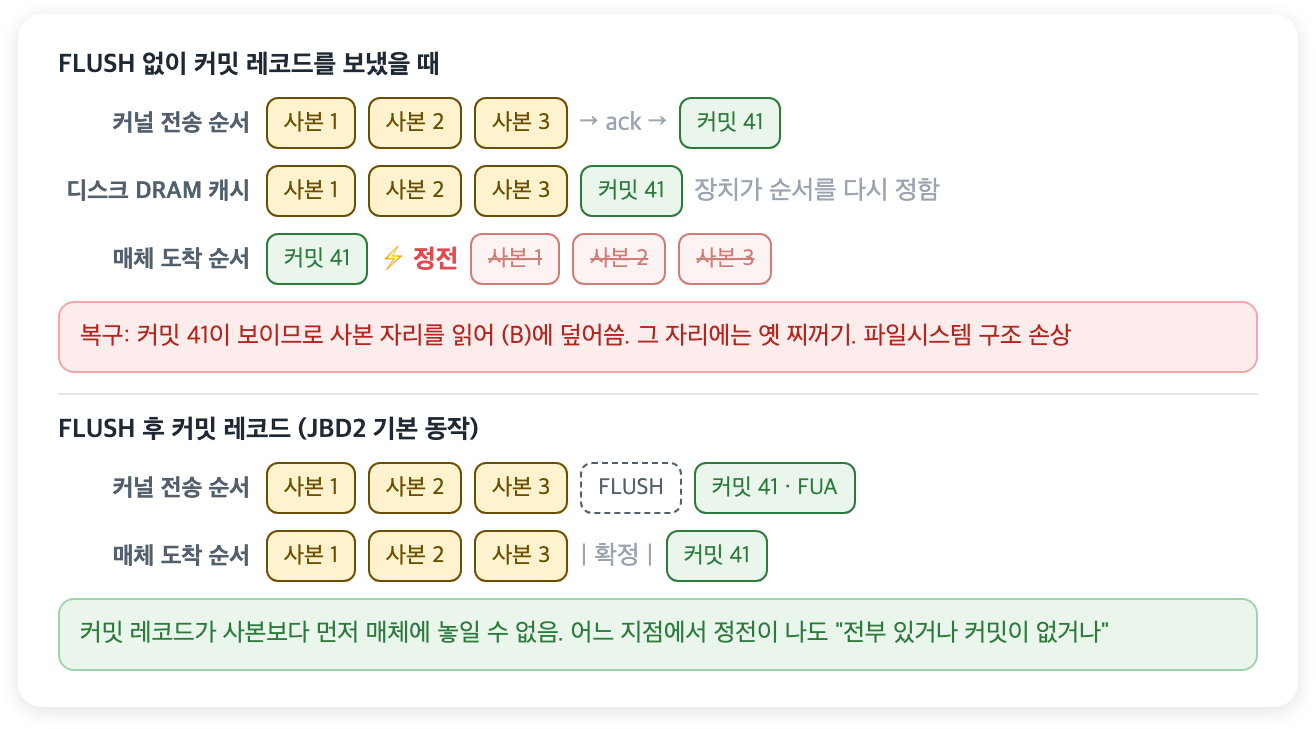
커밋 레코드가 먼저 매체에 놓이고 사본이 내려가기 전에 정전이 나면, 재부팅 시 JBD2는 커밋 레코드를 보고 트랜잭션이 확정됐다고 판단해 사본 자리를 읽어 (B)에 덮어씁니다. 그 자리에는 한 바퀴 전 트랜잭션의 찌꺼기가 있으므로 inode 테이블과 비트맵에 쓰레기가 기록됩니다. 파일 하나의 손실이 아니라 파일시스템 구조의 손상입니다. 커밋 레코드가 사라지는 반대 경우는 위험하지 않습니다. 트랜잭션이 무시되고 (B)는 옛 값으로 온전히 남습니다.
이 순서 뒤바뀜을 막는 것이 FLUSH입니다. 장치에 보내는 "지금까지 ack한 쓰기를 전부 매체에 내리고 나서 응답하라"는 명령이고, SCSI로는 SYNCHRONIZE CACHE입니다. JBD2는 사본 완료 뒤 FLUSH를 거치고 나서 커밋 레코드를 보내며, 커밋 레코드 자체는 FUA로 씁니다.
NOTEREQ_PREFLUSH와 REQ_FUA는 파일시스템이 블록 레이어에 넘기는 요청에 붙이는 플래그입니다. REQ_PREFLUSH는 "이 요청을 처리하기 전에 장치 캐시를 FLUSH하라", REQ_FUA(Force Unit Access)는 "이 쓰기 하나는 캐시에 두지 말고 매체 도달 후 ack하라"입니다. JBD2의 커밋 레코드 요청에는 둘이 함께 붙습니다. 앞의 사본들을 매체에 내린 뒤에 커밋 레코드를 쓰고, 그 커밋 레코드도 매체에 닿은 뒤에 완료를 알리라는 뜻입니다. 그래서 fsync()의 반환은 "커밋 레코드가 매체에 있다"와 같은 말이 됩니다. 커널 문서
Documentation/block/writeback_cache_control.rst에 두 페이지 분량으로 정의되어 있습니다.
write through 장치에서 일어나는 일
3절에서 이 VM의 디스크는 WCE=0, write through를 선언한다고 했습니다. 장치가 "ack한 쓰기는 이미 영속이다"라고 말한 것이므로, 커널은 블록 레이어에서 REQ_PREFLUSH와 REQ_FUA를 제거합니다. FLUSH를 보낼 이유가 없다고 판단하는 것입니다. 위 flowchart에서 이 VM이 FLUSH 없는 경로로 가는 이유가 이것입니다.
이 선언이 시사하는 것은 내구성 보장의 경계가 VM 밖으로 넘어갔다는 점입니다. 우리가 아는 것은 "캐시가 없다"는 사실이 아니라 장치가 그렇게 선언했다는 것뿐입니다. 선언이 참이면 ack 순서가 곧 매체 도달 순서이므로 뒤바뀜이 생길 수 없고, 하이퍼바이저가 캐시를 두고도 없다고 했다면 위의 손상이 그대로 가능합니다. Oracle Cloud의 블록 스토리지 내부에도 여러 캐시 계층이 있겠지만 ack 전에 영속화를 끝내는 계약을 지키는 방식일 것이고, 게스트 안에서는 이를 검증할 방법이 없습니다. QEMU로 비유하면 cache=writethrough가 이렇게 광고하고, cache=unsafe는 캐시가 있다고 광고하면서 FLUSH를 버립니다. 클라우드 볼륨은 이 둘 중 어느 쪽인지 문서와 신뢰로 판단할 수밖에 없다고 봅니다.
실습 환경으로는 이 특성이 오히려 유리한 면이 있습니다. 디스크 캐시 소실이라는 변수가 없으므로, 정전 실험에서 잃는 것은 게스트 페이지 캐시와 커밋되지 않은 저널만입니다. write()와 fsync() 사이를 다른 요인 없이 볼 수 있습니다. 대신 fsync() 비용 모델이 달라집니다. 이 VM의 fsync 지연은 순전히 네트워크 블록 스토리지의 쓰기 ack 지연이고, FLUSH 비용이 없습니다. 특히 O_DIRECT로 쓴 파일에 fdatasync를 부르면 메타데이터 변경이 없어 커널이 할 일이 FLUSH 하나뿐인데 그게 빠지므로 거의 공짜가 됩니다. MySQL의 innodb_flush_method=O_DIRECT가 정확히 이 경로를 타므로, 이 환경에서 측정한 커밋 지연을 write back 캐시가 있는 로컬 SSD로 일반화하면 안 됩니다.
커널 쪽 동작만은 강제로 볼 수 있습니다. /sys/block/sda/queue/write_cache는 쓰기 가능한 파일이어서 write back을 써 넣으면 커널이 FLUSH 요청을 만들기 시작하고 blktrace에 FLUSH 액션이 찍힙니다. 다만 이것은 커널이 FLUSH를 어떻게 생성하고 배치하는지를 보여줄 뿐이고, 하이퍼바이저가 그 명령을 실제로 어떻게 처리하는지는 여전히 알 수 없습니다.
8. 정전 지점별 결과 (실험 D, E)
6절의 단계를 기준으로 각 지점에서 정전이 났을 때 재부팅 후 상태를 정리하면 다음과 같습니다.
| 정전 지점 | (A) | (B) | (C) | 복구 동작 | a.txt |
|---|---|---|---|---|---|
| 단계 1 직후 | 없음 | 옛 값 | 없음 | 할 것 없음 | 없음 |
| 단계 2 직후 | 데이터 있음 | 옛 값 | 없음 | 할 것 없음 | 없음. #N은 빈 블록으로 취급 |
| 단계 3 직후 | 데이터 | 옛 값 | 사본만 | 커밋 없어 무시 | 없음 |
| 단계 4 직후 | 데이터 | 옛 값 | 사본과 커밋 | (C)의 사본을 (B)에 재적용 | 완전 |
| 단계 5 도중 | 데이터 | 일부 새 값 | 사본과 커밋 | (C)의 사본을 (B)에 다시 재적용 | 완전 |
| 단계 5 이후 | 데이터 | 새 값 | 재사용됨 | 할 것 없음 | 완전 |
"없음"은 디렉터리 엔트리가 (B)에 없기 때문입니다. 단계 0의 파일 생성이 이전 5초 주기 커밋에 이미 들어갔다면 그 경우에는 크기 0으로 존재합니다. ordered 규칙 때문에 "크기는 1024인데 내용이 없음"은 나올 수 없습니다. 단계 2 직후의 경우 블록 #N에는 1024바이트가 물리적으로 남아 있지만, (B)의 블록 비트맵이 옛 값이라 #N은 빈 블록으로 표시되어 있고 다음 할당 때 덮어써집니다.
단계 5 도중의 재적용이 몇 번 반복돼도 안전한 이유는 사본이 "비트맵의 1234번을 1로 바꿔라" 같은 연산이 아니라 4KB 블록의 완성된 내용이기 때문입니다. 같은 4KB를 다시 덮어쓰는 것이라 한 번 하든 열 번 하든 (B)의 결과가 같습니다. 저널 슈퍼블록의 시작 위치는 (B) 쓰기가 전부 끝난 뒤에야 옮겨지므로, 그 전에 다시 죽으면 다음 부팅에서 같은 트랜잭션을 처음부터 재적용합니다.
정전은 프로세스를 죽이는 것으로는 재현되지 않습니다. 5절에서 본 대로 kill -9는 페이지 캐시를 남깁니다. 이 VM에서는 sysrq로 sync와 umount 없이 즉시 재부팅해 게스트 페이지 캐시를 날리는 방식으로 재현합니다. write() 후 1초 안에 죽여야 하는 이유는 4절의 5초 주기 커밋이 오면 fsync 없이도 단계 4에 도달하기 때문입니다.
# D: fsync 없이 write() 1초 후 정전
$ ./write1 d.txt & sleep 1; echo b | sudo tee /proc/sysrq-trigger
pid=3381281 write()=1024 bytes
Read from remote host 161.33.45.160: Connection reset by peer

# 재부팅 후
$ ls -l d.txt; cat d.txt
-rw-r--r-- 1 ubuntu ubuntu 0 Sep  4 07:52 d.txt
D의 결과는 "크기 0으로 존재"입니다. 표의 두 경우 중 파일 생성은 커밋됐고 내용은 커밋되지 않은 경우입니다. write()와 정전 사이 1초 남짓에 5초 주기 커밋이 한 번 지나간 것으로 보이는데, 이 노드에는 kubelet이 계속 메타데이터를 쓰고 있어 트랜잭션이 항상 열려 있고 5초마다 커밋되므로 그 창에 걸릴 확률은 대략 넷 중 하나입니다. 그 커밋에 openat의 세 블록은 들어갔지만 크기는 0으로 기록됐습니다. delayed allocation 때문입니다. write()는 RAM의 inode 크기만 1024로 바꾸고, 디스크에 기록되는 크기(i_disksize)는 블록이 실제로 배정되는 writeback 시점에야 갱신됩니다. 블록 배정 전에 커밋이 지나가면 디스크의 inode는 크기 0이고, 그래서 정전 후에 "크기는 1024인데 내용은 옛 잔해"가 아니라 "크기 0"이 남습니다. ordered 규칙이 이 형태로 지켜진 것입니다.
# E: write() 직후 fsync(), 1초 후 정전
$ ./write1 -sync e.txt & sleep 1; echo b | sudo tee /proc/sysrq-trigger
pid=1173 write()=1024 bytes
fsync() done
Read from remote host 161.33.45.160: Connection reset by peer

# 재부팅 후
$ ls -l e.txt; head -c 32 e.txt
-rw-r--r-- 1 ubuntu ubuntu 1024 Sep  4 07:54 e.txt
HELLO-FSYNC-LAB
HELLO-FSYNC-LAB
E는 1024바이트가 온전히 남았습니다. fsync()가 반환됐다는 것은 단계 4의 커밋 레코드가 (C)에 있다는 뜻이고, 재부팅 시 JBD2가 그 트랜잭션을 (B)에 재적용했습니다. 반환 뒤 1초 만에 죽었으니 checkpoint는 일어나지 않았을 것이고, 표의 "단계 4 직후" 행이 그대로 나온 것입니다.
같은 정전에서 잃은 것이 하나 더 있었습니다. 정전 직전 이 노드의 마지막 journald 로그는 07:50:29이고 정전은 약 07:52:09였습니다. 약 100초 분량의 시스템 로그가 사라진 것인데, journald가 로그 파일을 5분마다만 fsync하기 때문입니다. 로그 데몬도 write()와 fsync() 사이에서 같은 규칙을 받습니다.
9. 저널이 막아주지 않는 것
이 글의 예시는 모두 새 블록을 할당하는 쓰기였습니다. 이미 배정된 블록을 덮어쓰는 경우는 다릅니다. 메타데이터 변경이 거의 없고 데이터는 (A)의 제자리에 바로 쓰이므로, 4KB 블록 하나를 쓰는 도중 정전이 나면 앞은 새 내용, 뒤는 옛 내용인 블록이 남을 수 있습니다. ext4는 이것을 손상으로 보지 않습니다. 파일시스템 구조는 멀쩡하기 때문입니다. 이 현상을 torn write라고 부르고, 파일시스템 저널은 파일시스템 자신을 지킬 뿐 파일 내용의 원자성은 응용 프로그램의 책임으로 남겨 둡니다.
데이터베이스가 자기 저널을 따로 갖는 이유가 여기서 나옵니다. InnoDB의 doublewrite buffer와 PostgreSQL의 full page writes는 이 torn write를 막기 위한 장치이고, Redis의 RDB가 임시 파일에 쓰고 rename하는 것도 같은 문제에 대한 다른 답입니다. 파일시스템이 "구조는 내가 지키고 내용은 네가 지켜라"고 그은 선 위에서, 각 오픈소스가 어떤 방식으로 내용을 지키는지가 이후 글들의 주제입니다.
TL;DR
- write()의 반환은 커널이 데이터를 페이지 캐시로 복사했다는 뜻이고, 디스크 도달과는 무관합니다. 측정에서 write()는 41~45마이크로초, fsync()는 2.56밀리초였고, write() 1초 뒤 정전에서는 크기 0인 파일만 남았습니다.
- 페이지 캐시는 커널 소유라서 프로세스가 kill -9나 OOM으로 죽어도 남고, 5초 주기 jbd2 커밋과 30초 writeback으로 커널이 스스로 내려보냅니다. 정전과 커널 패닉만이 페이지 캐시를 지웁니다.
- ext4는 메타데이터만 저널(C)을 거쳐 본래 위치(B)로 보내고, 데이터는 (A)에 직접 쓰되 커밋 레코드보다 먼저 도착하도록 순서만 강제합니다. 메타데이터는 커밋 때 (C)로, checkpoint 때 (B)로 두 번 쓰입니다.
- 커밋 레코드는 저널의 마지막 한 블록이고, 그것이 사본보다 나중에 매체에 놓이도록 FLUSH와 FUA가 순서를 강제합니다. 장치가 write through를 선언하면 커널은 이 단계를 생략하고 장치의 약속을 신뢰합니다.
- 저널은 파일시스템 구조를 지키고 파일 내용의 원자성은 지키지 않습니다. torn write를 막는 것은 응용 프로그램의 일입니다.
다음 글에서는 Redis가 이 경로 위에서 RDB 스냅샷과 AOF를 어떻게 쓰는지 다룹니다. fork와 copy-on-write, appendfsync 세 가지 설정이 위 단계의 어디에 대응하는지, 그리고 rewrite 도중 정전이 나면 어느 파일이 남는지를 같은 방식으로 확인합니다.