
InnoDB, 제대로 이해하고 있나요?
MySQL을 쓴 지 꽤 됐고, 트랜잭션 격리 수준 정도는 안다고 생각했습니다. REPEATABLE READ가 기본값이고, Phantom Read를 막아 주고, 동시성 문제가 생기면 락을 걸면 된다 — 이 정도면 충분한 줄 알았습니다.
잠금 쪽은 그럭저럭 설명할 수 있었습니다. 갭 락이 Phantom Read를 막는다는 것도 알고 있었고요. 정작 막힌 쪽은 MVCC였습니다. "MVCC가 정확히 무엇을 간직하고 어떻게 동작하는지", "언두 로그와 Read View가 각각 무엇을 저장하는지"를 설명하려니 곳곳에서 흐릿했고, 몇 군데는 아예 반대로 알고 있었습니다. 이 글은 그렇게 다시 짚어 본 격리 수준·잠금·MVCC의 기록입니다. 잠금은 정리하는 셈 치고 짚되, MVCC 쪽에서 제가 잘못 알고 있던 지점은 그때그때 표시해 두었습니다.
먼저 전제 하나. InnoDB에서 동시성을 다루는 장치는 사실 두 개이고, 서로 독립적으로 움직입니다. 하나는 잠금(record/gap/next-key lock), 다른 하나는 MVCC(Multi-Version Concurrency Control)입니다. 제가 흐릿했던 것들의 대부분은 MVCC를 잠금과 뭉뚱그려 봤거나, MVCC 내부를 대충만 알고 있었기 때문이었습니다.
트랜잭션 격리 수준과 세 가지 이상 현상
시작은 익숙한 표입니다. MySQL InnoDB 기준으로 각 격리 수준에서 발생 가능한 이상 현상은 다음과 같습니다.
| 격리 수준 | Dirty Read | Non-Repeatable Read | Phantom Read |
|---|---|---|---|
| READ UNCOMMITTED | O | O | O |
| READ COMMITTED | X | O | O |
| REPEATABLE READ (기본값) | X | X | △ |
| SERIALIZABLE | X | X | X |
O = 발생함, X = 발생 안 함, △ = 표준 SQL에선 발생하나 InnoDB에선 대부분 방지됨
여기까지는 외워서 그릴 수 있었습니다. 세 이상 현상도 이름은 알고 있었고요.
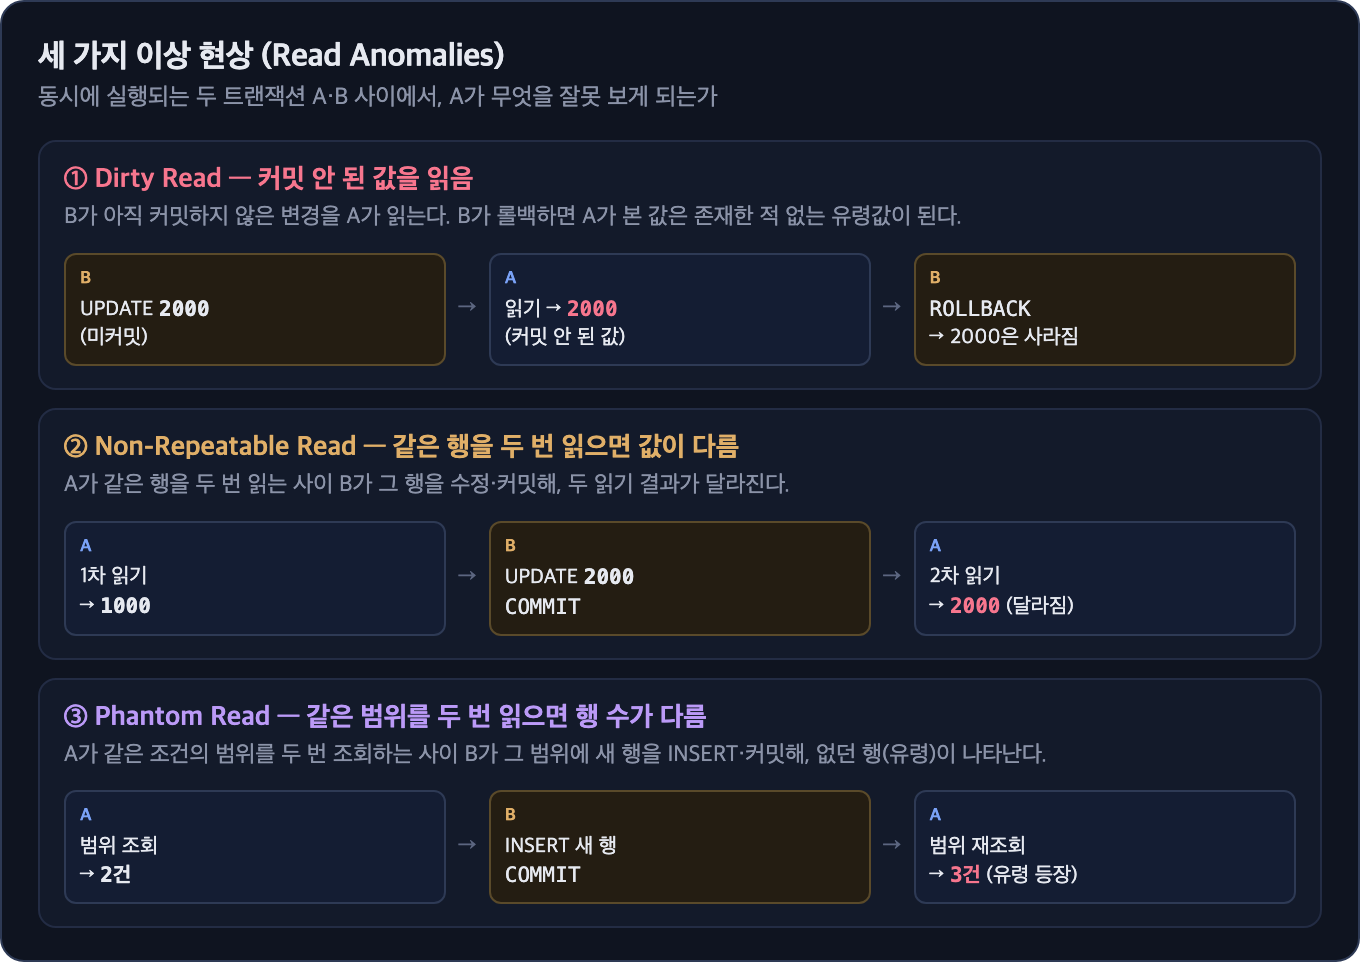
- Dirty Read: 다른 트랜잭션이 아직 커밋하지 않은 변경을 읽는 것. 그 트랜잭션이 롤백하면 내가 본 값은 존재한 적 없는 값이 됩니다.
- Non-Repeatable Read: 같은 행을 두 번 읽는 사이 다른 트랜잭션이 그 행을 수정·커밋해, 두 읽기의 값이 달라지는 것.
- Phantom Read: 같은 조건의 범위를 두 번 조회하는 사이 다른 트랜잭션이 그 범위에 INSERT·커밋해, 없던 행(유령 행)이 나타나는 것.
표에서 눈여겨볼 건 REPEATABLE READ의 Phantom Read가 △라는 점입니다. 표준 SQL 정의대로라면 발생해야 하는데 InnoDB는 대부분 막습니다. 저는 이걸 갭 락(넥스트 키 락) 덕분이라고 알고 있었는데, 나중에 보니 그건 절반의 답이었습니다. 일반 SELECT를 막는 나머지 절반은 잠금이 아니라 MVCC였고, 그 갈래를 놓치고 있었습니다. 그 대비를 위해서라도, 익숙한 잠금부터 차례로 정리해 봅니다.
세 가지 잠금 — 레코드 락, 갭 락, 넥스트 키 락
InnoDB 잠금은 "무엇을 잠그는가"를 먼저 구분해야 합니다. 세 락은 잠그는 대상이 서로 다릅니다.
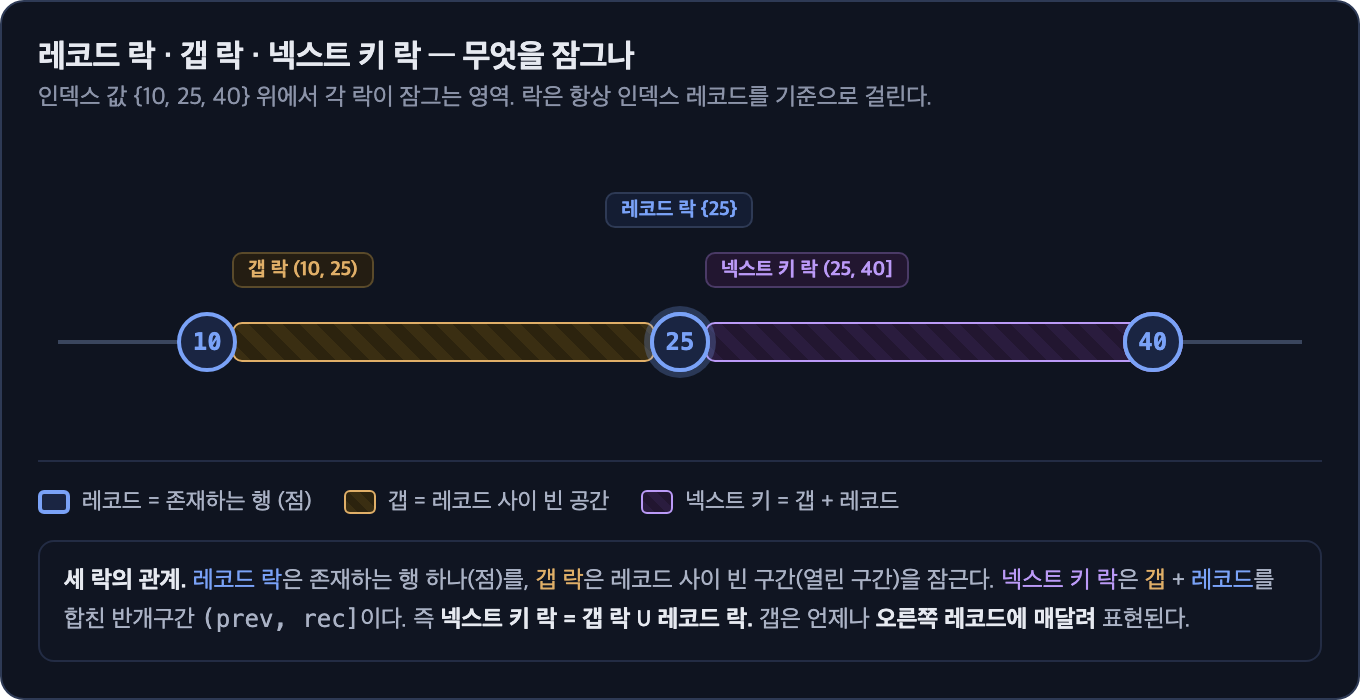
- 레코드 락(record lock): 인덱스 상에 존재하는 행 하나(점)를 잠급니다.
- 갭 락(gap lock): 레코드 사이의 빈 구간(열린 구간)을 잠급니다. 양 끝 레코드는 포함하지 않습니다.
- 넥스트 키 락(next-key lock): 위 둘을 합친 반개구간
(prev, rec]입니다.
집합으로 쓰면 넥스트 키 락 = 갭 락 ∪ 레코드 락이고, 레코드 락과 갭 락은 잠그는 영역이 겹치지 않습니다. 여기서 구현 사실 하나를 짚어 두면, 갭 락은 독립적으로 존재하지 않고 항상 오른쪽 레코드에 매달려 표현됩니다. InnoDB의 락은 언제나 특정 인덱스 레코드에 부착되고, 그 레코드에 어떤 "모드"가 걸리느냐로 세 가지가 갈립니다.
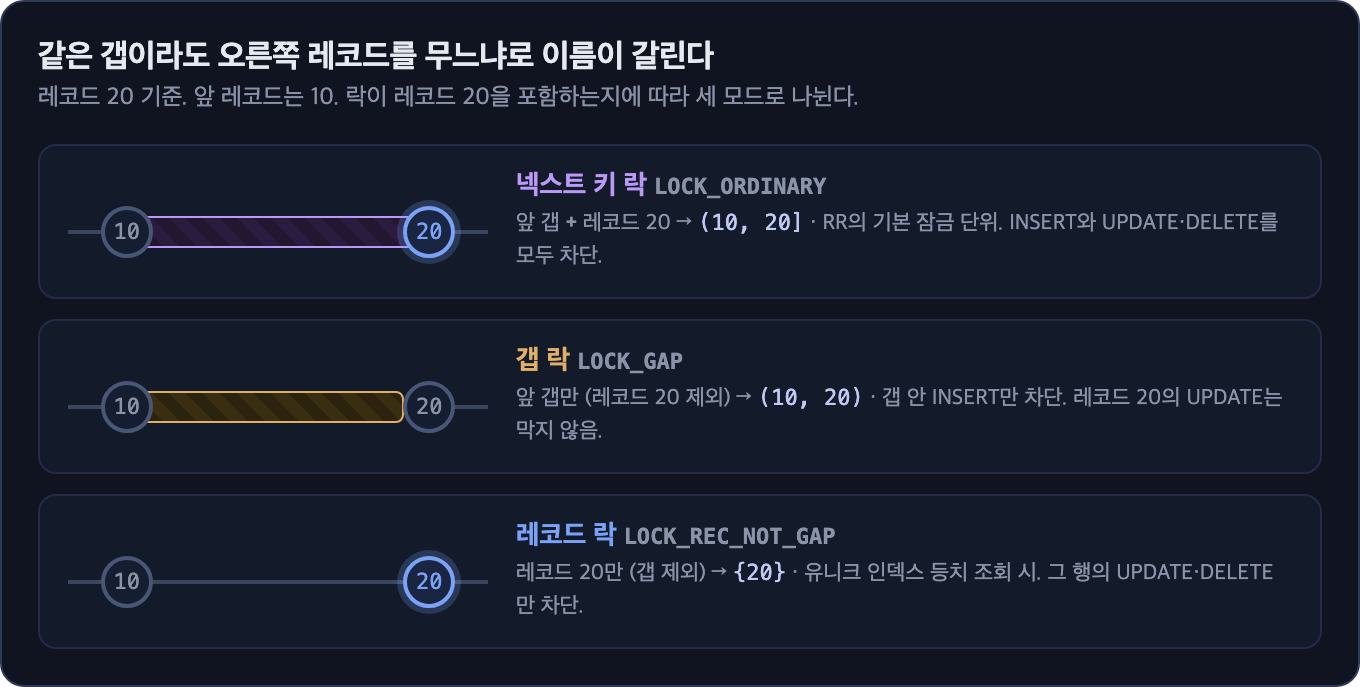
이 구조를 알고 나면 performance_schema.data_locks나 SHOW ENGINE INNODB STATUS의 락이 항상 어떤 인덱스 레코드를 기준으로 X, X,GAP, X,REC_NOT_GAP으로 찍히는 이유가 읽힙니다. "이 갭이 어느 레코드에 매달렸는지"를 읽는 법을 알면 데드락 로그 해석이 한결 수월해집니다.
갭 락은 어떻게 Phantom Read를 막는가
Phantom의 핵심은 "아직 존재하지 않는 행"입니다. 레코드 락은 이미 존재하는 행만 잠그므로, 앞으로 INSERT될 행을 막을 수 없습니다. 그래서 갭 락이 필요합니다. 갭 락은 값이 아니라 레코드 사이의 빈 공간 자체를 잠가, 그 구간에 새 행이 들어오는 것을 막습니다.
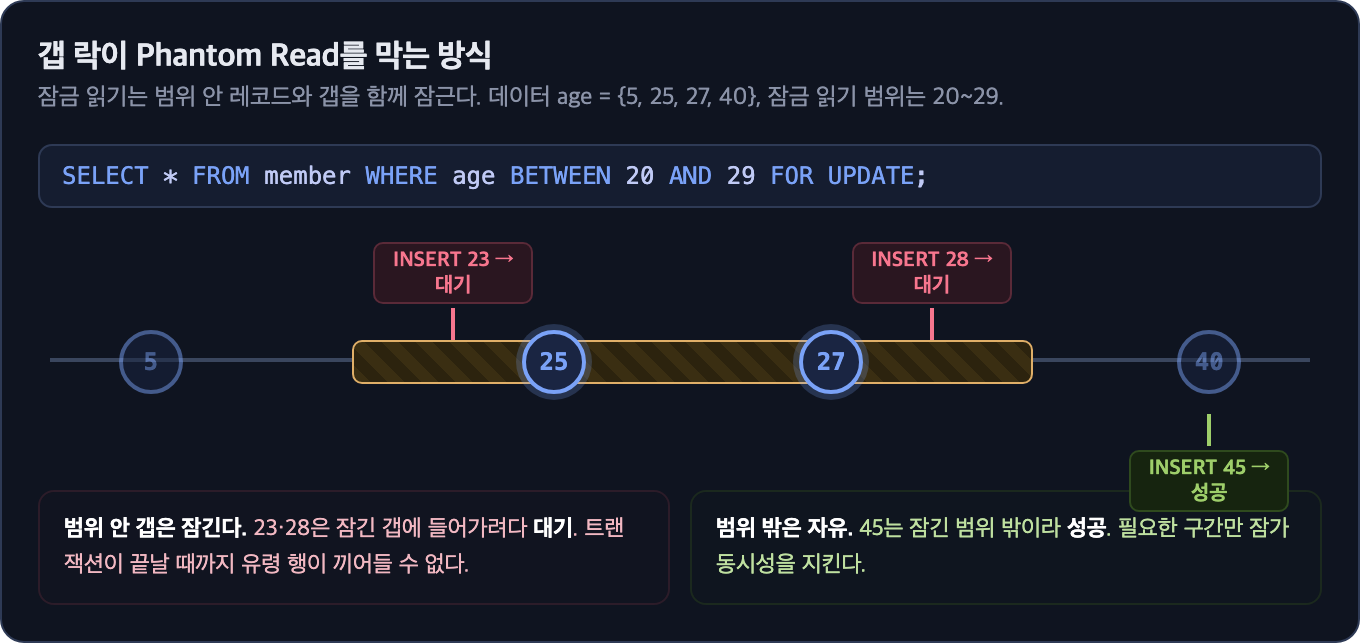
SELECT ... WHERE age BETWEEN 20 AND 29 FOR UPDATE를 실행하면 범위에 걸치는 레코드와 그 사이 갭이 함께 잠깁니다. 그러면 23이나 28을 INSERT하려는 트랜잭션이 잠긴 갭에서 대기하고, 45처럼 범위 밖 INSERT는 그대로 성공합니다.
💡 헷갈리기 쉬운 점: 갭 락은 빈 공간의 INSERT만 막습니다. 이미 존재하는 행의 UPDATE·DELETE는 갭 락이 아니라 레코드 락의 관할입니다. 갭 락이 "행"이 아니라 "행 사이의 공간"을 잠근다는 걸 놓치면, "갭이 걸렸으니 그 행은 못 고친다" 같은 오해가 생깁니다.
여기까지가 제가 알던 부분이었습니다. 그런데 이게 절반이었습니다. InnoDB가 Phantom을 막는 방식은 두 갈래인데, 저는 갭 락 쪽만 보고 있었습니다.
- 일반 SELECT(비잠금 읽기): 갭 락이 아니라 MVCC 스냅샷이 막습니다. 트랜잭션 시점의 스냅샷만 보므로 남이 넣은 행이 애초에 안 보입니다. 남의 INSERT를 물리적으로 막지는 않습니다.
- 잠금 읽기(
SELECT ... FOR UPDATE등): 스냅샷을 쓸 수 없으므로 넥스트 키 락으로 범위를 잠가 INSERT 자체를 대기시킵니다.
앞서 △였던 REPEATABLE READ의 Phantom이 여기서 풀립니다. "안 보이게 하는 것(MVCC)"과 "못 들어오게 막는 것(갭 락)"은 전혀 다른 장치이고, 어느 쪽 읽기를 쓰느냐에 따라 다르게 작동합니다. 제가 흐릿했던 것은 앞쪽, MVCC였습니다. 그 얘기는 잠금을 마저 정리한 뒤에 하겠습니다.
잠금 범위는 인덱스가 결정한다
갭 락은 인덱스를 기준으로 동작합니다. 그래서 같은 조회라도 인덱스 상황에 따라 잠기는 범위가 크게 달라집니다.
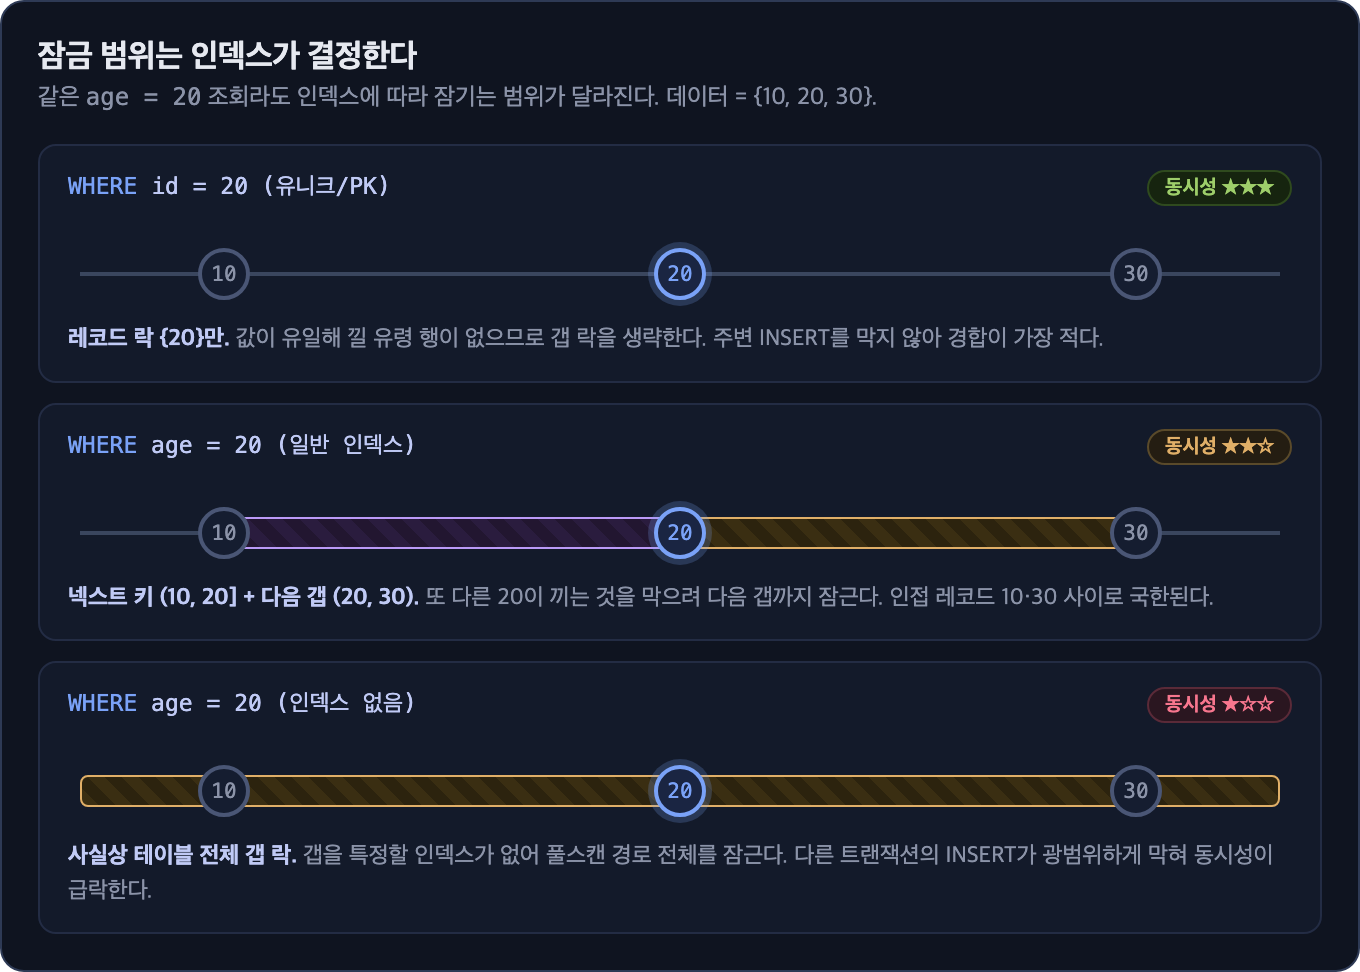
- 유니크 인덱스 등치 조회(
WHERE id = 20): 값이 유일해 낄 유령 행이 없으므로 갭 락을 생략하고 레코드 락만 겁니다. 경합이 가장 적습니다. - 일반 인덱스 등치 조회(
WHERE age = 20): 또 다른 20이 끼는 것을 막으려 넥스트 키 락에 더해 다음 갭까지 잠급니다. 다만 인접 레코드가 경계 역할을 해서 잠금은 그 사이로 국한됩니다. - 인덱스 없음: 갭을 특정할 수 없어 풀스캔 경로 전체를 잠급니다. 사실상 테이블 전체에 갭 락이 퍼져 동시성이 급락합니다.
여기서 헷갈리기 쉬운 것이 "범위 락"이라는 표현입니다. WHERE age BETWEEN ...으로 범위를 잠그면 그 구간이 통짜 갭 락 하나로 덮이는 것처럼 들리지만, 실제로는 그렇지 않습니다. 잠긴 범위 안이라도 이미 존재하는 행은 레코드 락, 빈 틈은 갭 락으로 역할이 쪼개집니다. InnoDB에는 "범위 락"이라는 단일 객체가 없고, 스캔하며 지나간 각 레코드·갭에 개별 락을 붙인 것의 총합일 뿐입니다.
이 관점을 갖고 나면 두 가지가 더 보입니다. 첫째, 갭의 경계는 "값이 가까운 지점"이 아니라 인덱스에 실제로 존재하는 인접 레코드가 정합니다. 데이터가 듬성듬성하면 갭이 커져 경합이 늘어납니다. 둘째, 범위 스캔은 종료 지점을 확인하려 범위 바로 다음 레코드까지 읽어 그 갭을 함께 잠그기도 합니다. BETWEEN 20 AND 30인데 31~39 INSERT까지 막히는, 겉보기엔 범위 밖인데 막히는 현상이 여기서 나옵니다.
💡 실무에서 겪은 데드락·락 대기의 상당수는 "조건 컬럼에 인덱스가 없어서" 스캔 경로가 넓어지고, 그만큼 잠금이 번진 경우였습니다. 잠금 범위를 줄이는 첫 번째 레버는 격리 수준이 아니라 인덱스와 스캔량이라고 생각합니다.
MVCC — 언두 로그와 버전 체인
여기서부터가 제가 대충만 알고 있던 영역입니다. 일반 SELECT가 "다른 트랜잭션이 커밋한 최신 값" 대신 "내 트랜잭션 시점의 값"을 볼 수 있는 것은 MVCC 덕분인데, 정작 그 옛 값이 어디에 어떻게 남아 있는지는 설명하지 못했습니다.
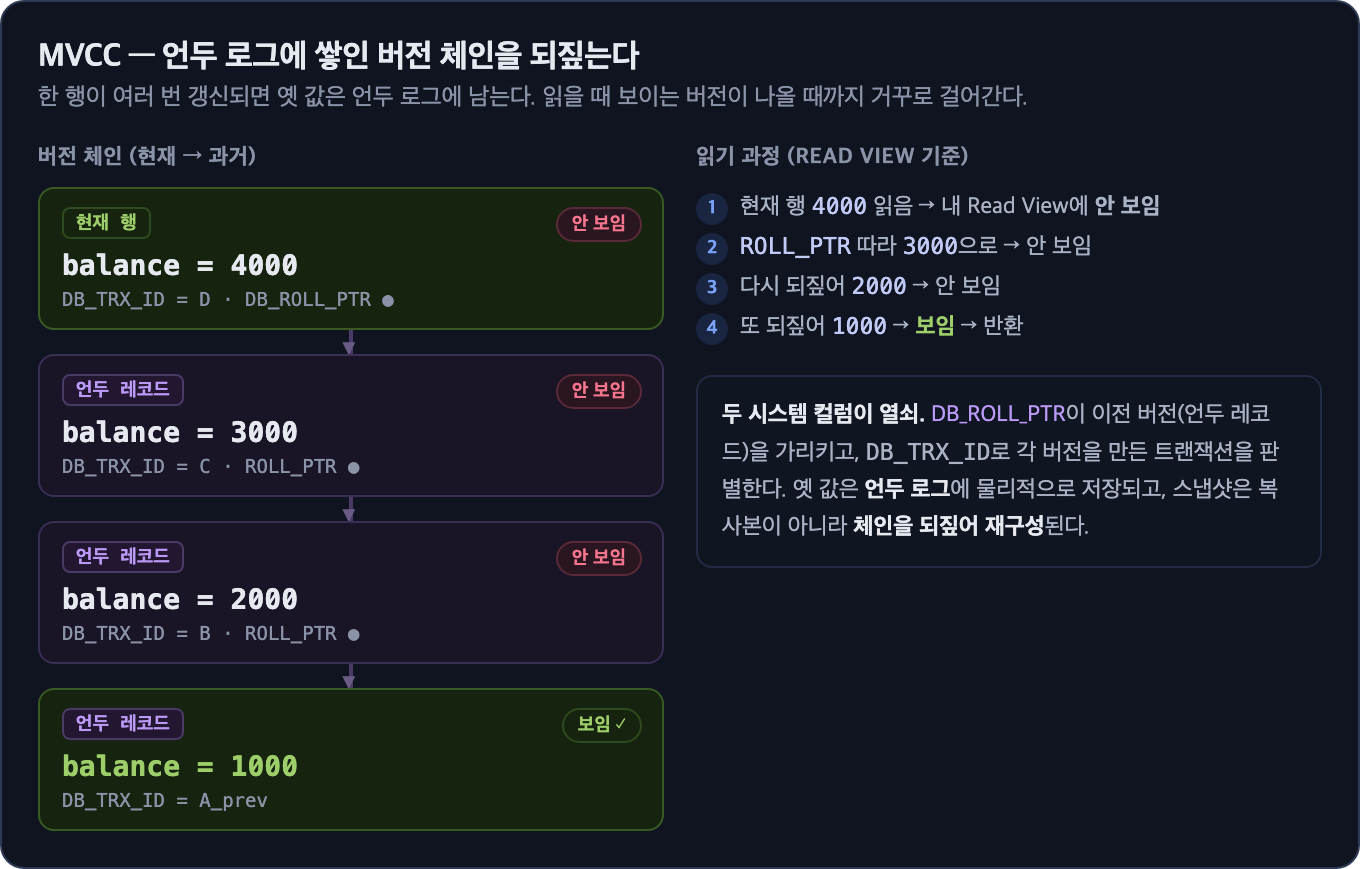
부품 단위로 나누면 이렇습니다.
- 모든 InnoDB 행에는 숨겨진 시스템 컬럼이 있습니다.
DB_TRX_ID(이 행을 마지막으로 수정한 트랜잭션 ID)와DB_ROLL_PTR(이전 버전이 담긴 언두 레코드를 가리키는 포인터)입니다. - 행이 수정되면 새 값은 현재 행에 덮어써지고, 옛 값은 언두 로그(undo log)에 언두 레코드로 밀려나 보관됩니다.
- 읽을 때는 현재 행부터 시작해 가시성을 판정하고, 안 보이면
DB_ROLL_PTR을 따라 이전 버전으로 이동하는 과정을 보이는 버전이 나올 때까지 반복합니다.
제가 여기서 놓치고 있던 감각은 "스냅샷"이라는 말이었습니다. 스냅샷을 어딘가에 통째로 떠 놓는 게 아니라, 옛 값은 언두 로그에 남고, 읽을 때 그 체인을 되짚어 그때그때 재구성하는 것이었습니다. 이 구조 때문에 긴 트랜잭션이 언두 로그를 부풀립니다. 오래 사는 트랜잭션이 볼지 모르는 옛 버전을 purge하지 못하기 때문입니다. 커밋을 미룬 트랜잭션이나 배치성 긴 조회가 언두 테이블스페이스를 폭증시키는 문제는 대체로 여기서 시작된다고 읽힙니다.
Read View — 가시성은 어떻게 판정되나
MVCC에서 제가 가장 크게 오해하고 있던 것이 Read View였습니다.
💡 저는 Read View가 **"그 시점 데이터의 스냅샷을 통째로 복사해 둔 것"**이라고 생각했습니다. 아니었습니다. Read View는 데이터를 복사하지 않습니다. 옛 값은 어디까지나 언두 로그에 있고, Read View는 그저 "활성 트랜잭션 ID 목록과 두 워터마크"라는 판정 필터일 뿐입니다. 데이터가 아니라, "어느 버전이 나에게 보이는가"를 계산하는 기준표에 가깝습니다.
Read View가 생성될 때 기록하는 것은 특정 행 정보가 아니라 전역적인 트랜잭션 ID 정보이고, 대략 네 가지입니다.
m_ids: 그 순간 활성 상태(시작했지만 미커밋)인 트랜잭션 ID 목록up_limit_id:m_ids중 최소값. 이보다 작은DB_TRX_ID는 무조건 보임low_limit_id: 다음에 배정될 트랜잭션 ID. 이보다 크거나 같으면 무조건 안 보임creator_trx_id: Read View 주인 자신의 트랜잭션 ID
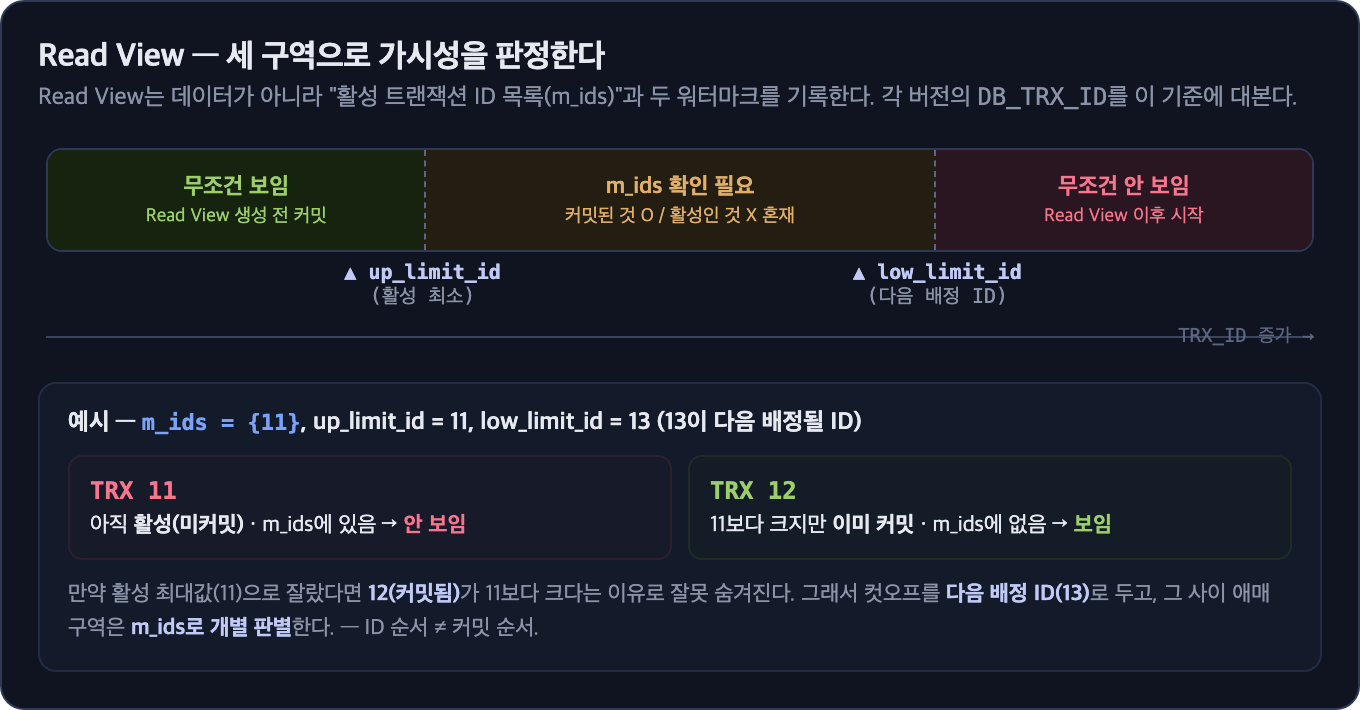
판정은 버전의 DB_TRX_ID = t에 대해 이렇게 이루어집니다. ① t == creator_trx_id면 보임(내 변경), ② t < up_limit_id면 보임(생성 전 커밋), ③ t >= low_limit_id면 안 보임(생성 후 시작), ④ 그 사이면 t가 m_ids에 있으면 안 보임(당시 활성), 없으면 보임(당시 이미 커밋).
이 규칙을 처음 봤을 때 두 군데서 걸렸습니다. 하나는 m_ids의 의미였습니다. 저는 m_ids를 "보여야 할 목록"으로 읽었는데, 반대로 "숨겨야 할(활성) 목록"이었습니다. 여기 없으면서 이미 배정된 ID는 곧 커밋된 트랜잭션이고, 커밋됐으니 보여야 합니다. 다른 하나는 "왜 굳이 아직 배정도 안 된 low_limit_id로 자르지? 활성 최대값보다 크면 숨기면 되잖아?"라는 의문이었습니다. 이유는 ID 순서와 커밋 순서가 일치하지 않기 때문이었습니다. 활성 최대값이 11이어도, 그보다 큰 12번 트랜잭션이 먼저 커밋해버릴 수 있습니다. 12는 커밋됐으니 보여야 하는데, 11로 자르면 잘못 숨겨집니다. 그래서 컷오프를 다음 배정 ID로 넉넉히 두고, 애매한 중간 구역은 m_ids로 개별 판별하는 것이었습니다.
정리하면, 가시성은 "지금 커밋됐는가"가 아니라 "내 Read View를 만든 순간에 그 트랜잭션이 활성이었는가"로 결정됩니다. 그리고 이 Read View를 언제 만드느냐가 두 격리 수준을 가릅니다. REPEATABLE READ는 첫 읽기 때 한 번 만들어 끝까지 재사용하고(그래서 반복 읽기가 일관됨), READ COMMITTED는 매 SELECT마다 새로 만듭니다(그래서 중간 커밋이 반영됨). 앞 절에서 미뤄 둔 "일반 SELECT가 Phantom을 안 보는 이유"도 결국 이 스냅샷 때문이었습니다.
스냅샷 읽기 vs 현재 읽기
잠금과 MVCC가 한 트랜잭션 안에서 만나는 지점입니다. 그리고 제가 실무 로직에서 실제로 실수할 뻔했던 부분이기도 합니다.
핵심은 같은 트랜잭션 안에서도 일반 SELECT는 스냅샷 읽기(consistent read)지만, UPDATE·DELETE·SELECT ... FOR UPDATE는 현재 읽기(current read)로 최신 커밋 데이터를 읽고 잠근다는 것입니다.
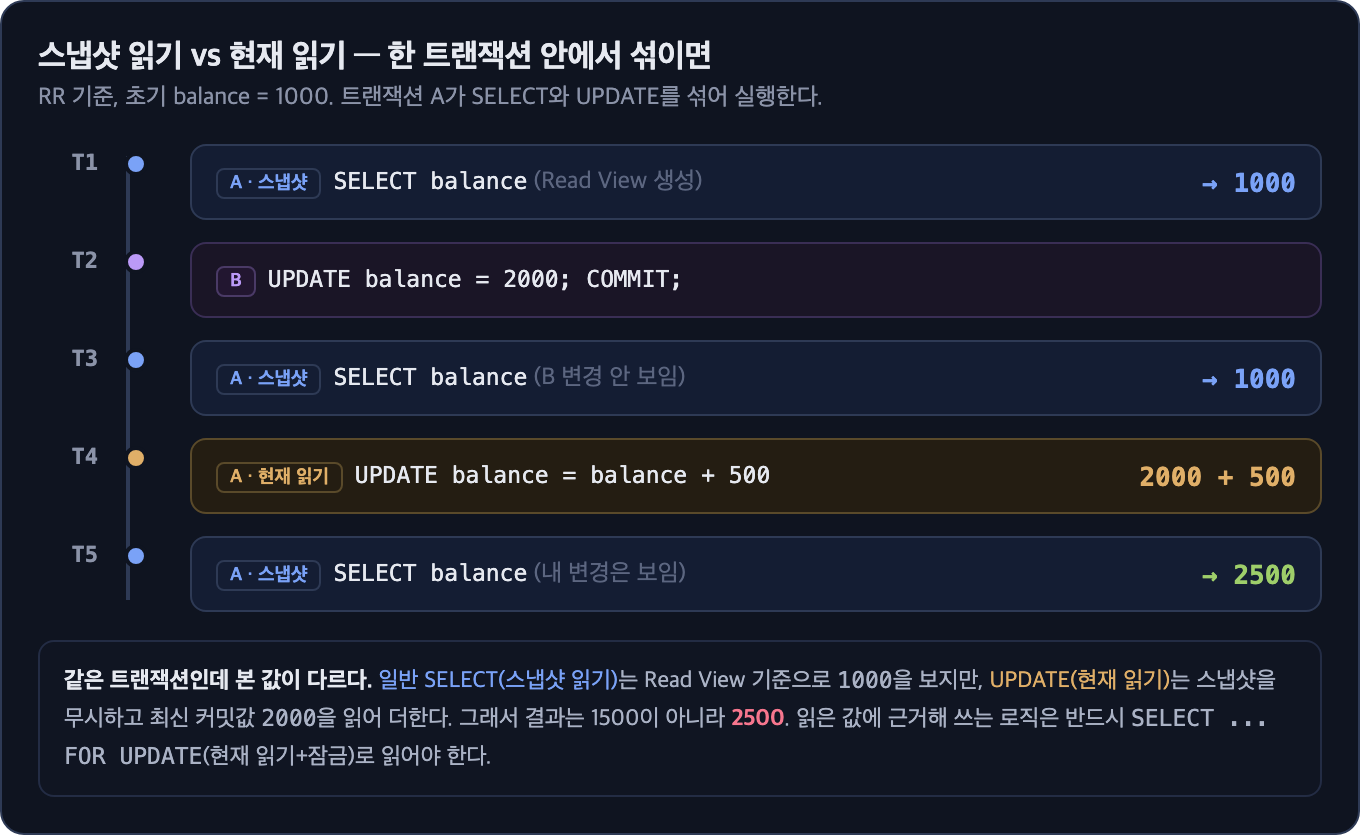
초기 balance = 1000인 상태에서 다른 트랜잭션이 2000으로 바꾸고 커밋한 뒤, 내 트랜잭션이 UPDATE balance = balance + 500을 실행하면 결과는 얼마일까요. 저는 당연히 스냅샷 값 기준으로 1000 + 500 = 1500이라고 생각했습니다. 실제 결과는 2500이었습니다. 일반 SELECT는 스냅샷 기준으로 1000을 보지만, UPDATE는 스냅샷을 무시하고 최신값 2000을 읽어 더하기 때문입니다.
이게 실무에서 왜 위험하냐면, 애플리케이션이 본 값과 DB가 쓰기에 쓴 값이 어긋나기 때문입니다.
-- 위험: 앱은 1000을 보고 판단했지만, UPDATE는 최신 2000을 기반으로 계산한다
SELECT balance FROM account WHERE id = 1;    -- 1000 (스냅샷)
-- 앱: "1000이니 300 빼도 되겠네"
UPDATE account SET balance = balance - 300 WHERE id = 1;  -- 실제로는 2000 기반 → 1700
읽은 값에 근거해 쓰는 로직이라면 처음부터 SELECT ... FOR UPDATE(현재 읽기 + 잠금)로 읽어야 값이 어긋나지 않습니다. 스냅샷 읽기와 현재 읽기가 한 트랜잭션 안에서 다른 시점을 본다는 걸 모르면, 이 차이는 좀처럼 눈에 안 들어옵니다.
실무에서의 선택
마지막으로 지금까지의 개념이 실무 결정으로 이어지는 지점을 정리합니다.
REPEATABLE READ vs READ COMMITTED. RC로 낮추면 갭 락이 (외래키·중복키 검사 등 예외를 빼면) 사라지고, 매칭되지 않은 행의 락도 조기 해제됩니다. INSERT 경합과 데드락이 줄어 동시성이 좋아지지만, 대가로 Non-Repeatable Read와 Phantom Read를 허용합니다.
| REPEATABLE READ | READ COMMITTED | |
|---|---|---|
| 갭 락 | 사용 | 대부분 미사용 |
| 레코드 락 | 사용 | 사용(유지) |
| INSERT 경합·데드락 | 상대적으로 잦음 | 줄어듦 |
| Non-Repeatable / Phantom | 방지 | 발생 허용 |
여기서 주의할 것은, 사라지는 것은 갭 락이지 락 전체가 아니라는 점입니다. RC에서도 레코드 락은 그대로 걸립니다. 그리고 쓰기(정확히는 겹치는 키 범위에 대한 동시 쓰기·잠금 읽기)가 드물다면 두 격리 수준의 성능 차이는 대체로 미미해서, 그럴 때는 성능이 아니라 정합성 기준으로 고르면 된다고 생각합니다.
N개 자원 중 하나 선점 — SKIP LOCKED. 좌석 예약이나 작업 큐처럼 "여러 후보 중 안 잠긴 것 하나를 집는" 패턴에는 FOR UPDATE SKIP LOCKED가 잘 맞습니다.
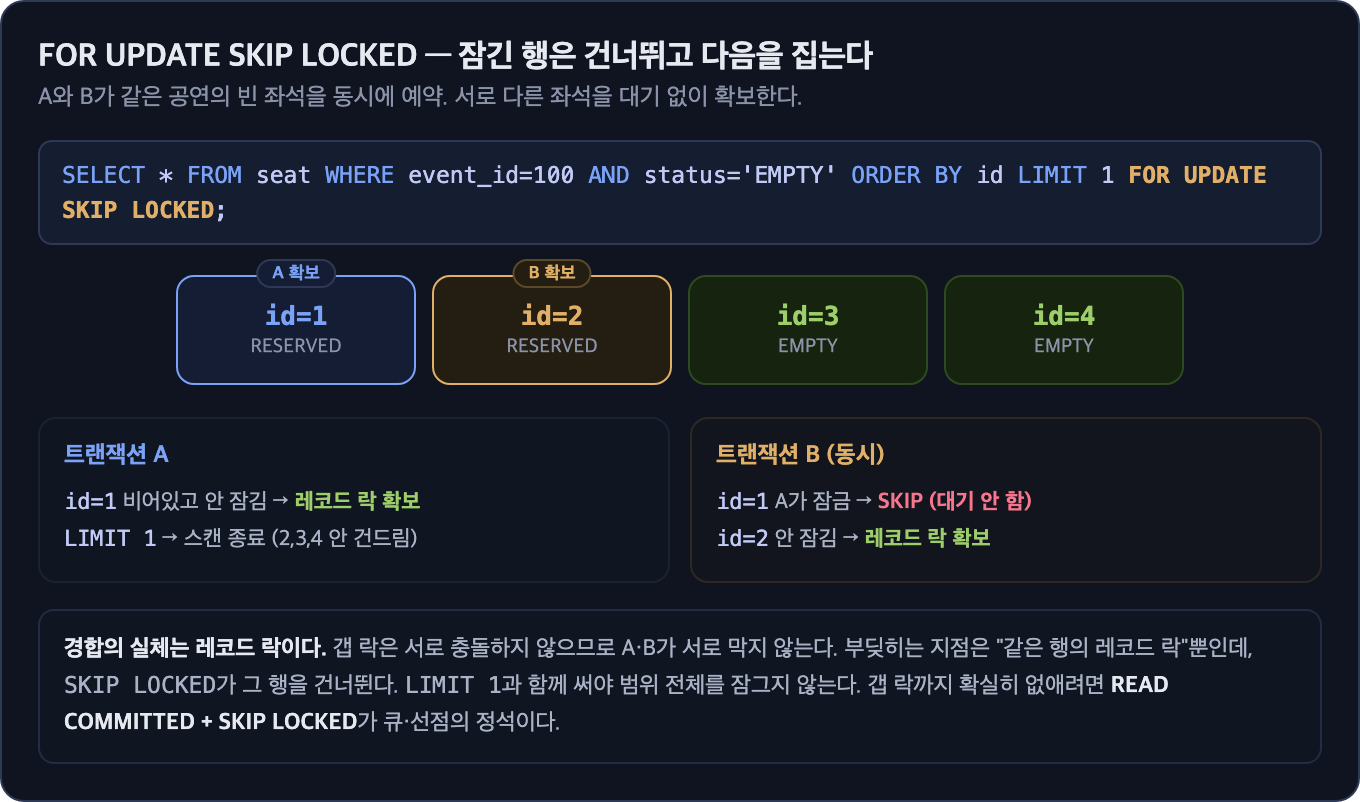
SKIP LOCKED는 스캔 중 이미 잠긴 행을 만나면 대기하지 않고 건너뜁니다. LIMIT 1과 함께 쓰면 하나를 집는 순간 스캔이 멈춰 범위 전체를 잠그지 않습니다. A와 B가 부딪히는 지점은 갭 락이 아니라 같은 행의 레코드 락이라는 점이 중요합니다(갭 락은 서로 충돌하지 않습니다).
💡 헷갈리기 쉬운 점:
SKIP LOCKED는 "잠긴 행을 만났을 때의 행동(건너뜀)"을 바꿀 뿐, 갭 락을 걸지 말지는 격리 수준이 결정합니다. 갭 락까지 확실히 배제하려면 READ COMMITTED + SKIP LOCKED 조합이 큐·선점 구현의 정석입니다.
단순 증감 — 원자적 UPDATE. UPDATE ... SET balance = balance + N은 락을 안 거는 것이 아니라, X 락을 아주 짧게(단일 문장 실행 구간만) 잡습니다. "락 없이 최신 값을 받아 처리해서 빠르다"고 오해하기 쉽지만, 정확히는 락을 잡되 보유 시간이 짧아서 빠른 것입니다. SELECT ... FOR UPDATE 후 애플리케이션에서 계산하는 방식은 락을 네트워크 왕복 시간 내내 잡지만, 원자적 UPDATE는 읽기-계산-쓰기가 DB 안에서 원자적으로 끝납니다.
다만 원자적 UPDATE도 만능은 아닙니다. 같은 행(hot row)에 갱신이 폭주하면 그 행의 X 락을 두고 트랜잭션들이 직렬화됩니다. 그때는 카운터 샤딩, 비동기 집계, 인메모리 카운터 후 주기적 flush 같은 아키텍처 차원의 분산으로 넘어가게 됩니다.
정리
다시 짚어 보니, 잠금은 대체로 알고 있던 대로였고 제가 틀렸던 지점은 대부분 MVCC 쪽 — "언두 로그와 Read View가 무엇을 간직하고 어떻게 동작하는지"에 몰려 있었습니다. 마지막으로 정리하면 이렇습니다.
- 격리 수준의 O/X 표는 결과이고, 그 결과를 만드는 것은 잠금과 MVCC라는 두 개의 독립된 레이어입니다.
- 레코드 락(점)·갭 락(빈 구간)·넥스트 키 락(둘의 합)은 잠그는 대상이 다르며, 갭 락은 항상 오른쪽 레코드에 매달려 표현됩니다.
- 갭 락은 INSERT만 막습니다. 기존 행의 UPDATE·DELETE는 레코드 락의 관할입니다.
- Phantom을 막는 방식은 두 갈래입니다. 일반 SELECT는 MVCC 스냅샷으로, 잠금 읽기는 넥스트 키 락으로 막습니다. (제가 알던 건 뒤쪽뿐이었습니다.)
- MVCC의 옛 값은 언두 로그에 남고, 스냅샷은 복사본이 아니라 버전 체인을 되짚어 재구성됩니다.
- Read View는 데이터가 아니라 "활성 트랜잭션 ID 필터"입니다. 가시성은 커밋 시각이 아니라 Read View 생성 순간의 활성 여부로 결정됩니다.
- 한 트랜잭션 안에서도 일반 SELECT는 스냅샷 읽기, UPDATE·
FOR UPDATE는 현재 읽기입니다. read-modify-write는 이 차이 때문에FOR UPDATE로 읽어야 안전합니다. - 선점은
SKIP LOCKED, 단순 증감은 원자적 UPDATE로 먼저 풀고, 격리 수준을 낮추거나 아키텍처를 분산하는 건 그다음이라고 생각합니다.