
OpenSearch 환경에서 키워드(BM25)와 벡터(HNSW) 검색을 결합한 하이브리드 검색을 구축하면서 겪은 문제들과 해결 과정을 정리했습니다.
단순히 두 엔진을 연동하는 것을 넘어, 실제 서비스 적용 시 맞닥뜨린 세 가지 병목을 해결한 과정을 기술합니다.
- HNSW 파라미터 조율을 통한 정확도(Recall)와 성능 타협
- 스케일이 다른 두 점수를 합치기 위한 RRF(순위 융합) 도입
- 필터 쿼리 추가 시 kNN 검색의 결과 누수 현상 방지
NOTEkNN과 ANN의 관계, NSW에서 HNSW로 발전한 이유, HNSW가 감당하지 못하는 규모에서 쓰는 SPANN 같은 인덱스 등 알고리즘 자체에 대한 자세한 내용은 벡터 검색 알고리즘 정리 — kNN과 ANN의 차이, NSW에서 HNSW로, 그리고 SPANN에서 별도로 다룹니다.
1. sparse vector와 dense vector는 뭐가 다른가
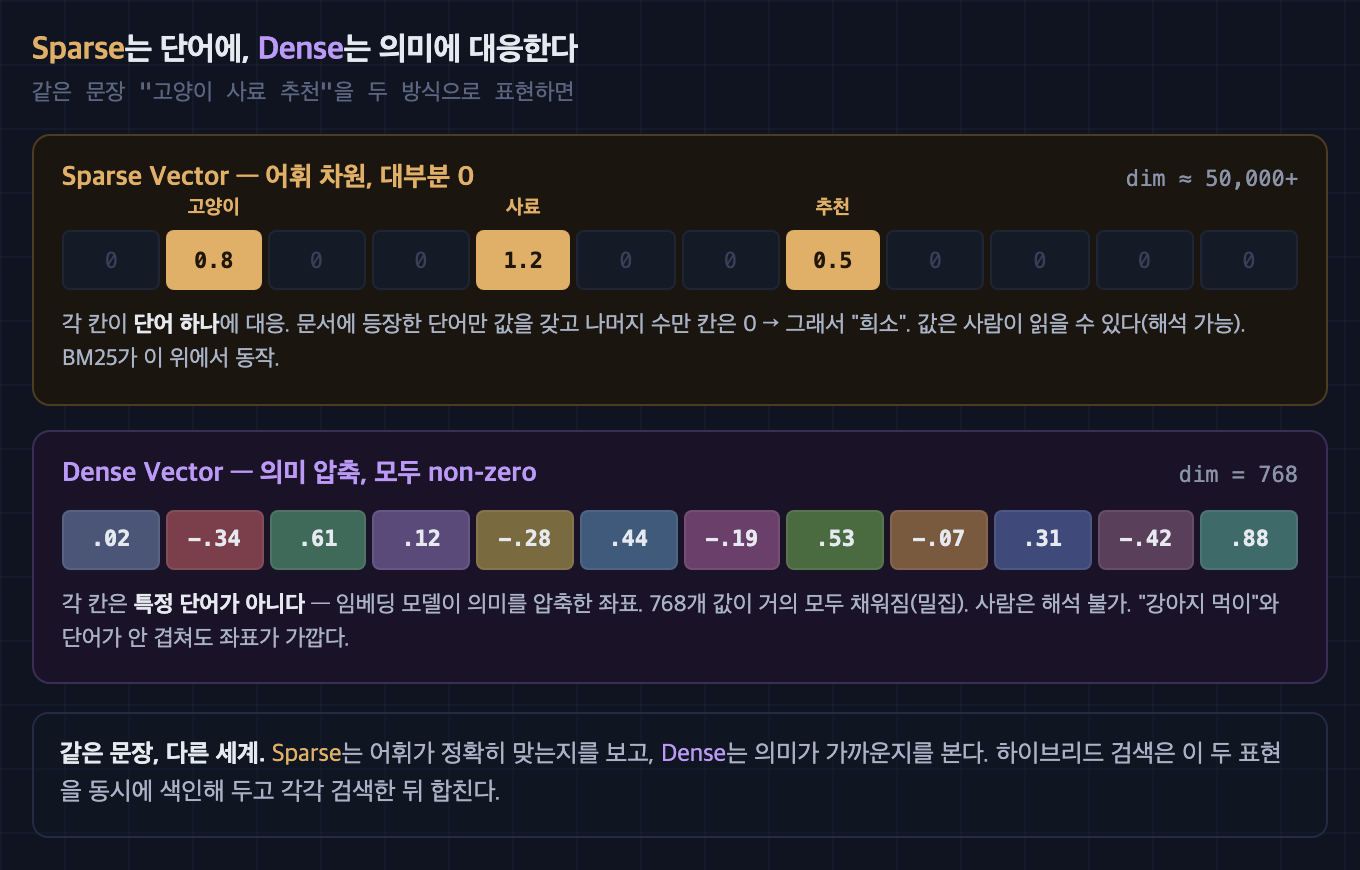
하이브리드 검색은 서로 다른 데이터 표현 방식을 함께 사용합니다. 단어 자체를 매칭하는 Sparse Vector(어휘 기반)와 문맥적 의미를 매칭하는 Dense Vector(임베딩 기반)의 비교입니다.
| 분류 | Sparse Vector | Dense Vector |
|---|---|---|
| 차원 수 | 어휘 사전 크기 (보통 50,000 이상) | 고정된 저차원 (보통 512 ~ 1536) |
| 값 분포 | 극소수 단어만 수치화, 대부분 0 | 모든 차원에 조밀하게 실수값 존재 |
| 매칭 기준 | 단어의 텍스트 자체(Lexical)가 일치하는가 | 단어가 담은 의미(Semantic)가 근접한가 |
| 장점 | 고유명사, 코드 번호, 고유 ID 검색에 강력 | 동의어·의역 탐색, 오타 및 표현 변형에 유연 |
| 단점 | '노트북'과 '랩탑' 같은 동의어를 못 찾음 | 매우 희귀한 명사나 특정 문자열 매칭에 취약 |
TF-IDF — 단어의 중요도를 수치화하는 기초
BM25를 이해하려면 먼저 그 전신인 TF-IDF를 살펴볼 필요가 있습니다. TF-IDF는 두 지표의 곱으로, 단어 하나가 특정 문서 내에서 얼마나 중요한지를 표현합니다.
TF (Term Frequency, 단어 빈도): 특정 단어가 문서에 얼마나 자주 등장하는지를 나타냅니다.
- : 분석 대상 단어
- : 문서
- : 문서 안에서 단어 의 등장 횟수
- : 문서 의 전체 단어 수
IDF (Inverse Document Frequency, 역문서 빈도): 해당 단어가 전체 문서 집합에서 얼마나 드물게 나타나는지를 나타냅니다.
- : 전체 문서 수
- : 단어 가 등장하는 문서의 수
TF-IDF: 두 값을 곱하면 해당 단어의 문서 내 중요도가 결정됩니다.
"이다", "있다" 같이 거의 모든 문서에 나오는 단어는 TF는 높더라도 IDF가 낮아 최종 가중치가 작습니다. 반대로 "양자 얽힘"처럼 드물게 등장하는 단어는 TF가 낮더라도 IDF가 높아 점수에 크게 기여합니다.
NOTETF-IDF의 한계: TF 값은 단순 선형으로 증가합니다. 단어가 1번 등장한 문서보다 10번 등장한 문서의 점수가 정확히 10배 높아집니다. 그러나 실제로는 단어가 반복될수록 추가 정보량이 줄어드는 수익 체감(Diminishing Returns) 이 나타납니다. 또한 긴 문서는 짧은 문서보다 단순히 같은 단어가 더 많이 등장할 확률이 높은데, TF-IDF는 이 문서 길이 편향을 보정하지 않습니다. BM25는 두 가지 문제를 모두 포화 함수와 길이 정규화로 해결합니다.
BM25 — sparse 위에서의 랭킹
키워드 검색 엔진은 주로 BM25 알고리즘을 통해 점수를 매깁니다.
- : 쿼리 를 구성하는 단어의 수
- : 쿼리의 번째 단어
- : 문서 내 쿼리 단어 의 등장 횟수 (TF)
- : 단어 의 희소도 가중치 — 전체 문서 중 해당 단어가 드물수록 높음
- : TF 포화 계수. 단어 반복에 따른 점수 상승 폭을 제어합니다. 값이 클수록 반복 효과가 더 강하게 반영되며, 보통 범위를 사용합니다.
- : 문서 길이 정규화 계수 (). 이면 문서 길이가 점수에 100% 반영되고(길면 감점, 짧으면 가점), 이면 길이를 완전히 무시합니다. 기본값은 입니다.
- : 문서 의 단어 수 (이 문서 하나의 길이 — 전체 문서 개수와는 다른 값입니다)
- : 색인된 전체 문서의 평균 단어 수
NOTE
b는 "문서 개수"가 아니라 "문서 길이"를 봅니다 BM25에는 문서와 관련된 변수가 두 종류 있어 헷갈리기 쉽습니다.N(전체 문서 수)과df(t)(단어가 등장하는 문서 수)는 앞서 다룬 IDF 계산에만 쓰이고,b와는 무관합니다.b가 실제로 보는 건 , 즉 "이 문서가 평균적인 문서보다 몇 배 긴가" 하는 길이 비율뿐입니다.예를 들어 색인 전체의 평균 단어 수(
avgdl)가 100이라고 하면, 300단어짜리 긴 문서는 이 되어 일 때 분모가 3배 커지면서 점수가 깎이고, 50단어짜리 짧은 문서는 가 되어 분모가 줄어들면서 점수가 오릅니다. 이면 이 비율 자체가 사라져 문서가 길든 짧든 점수에 영향을 주지 않습니다.
IMPORTANTBM25의 두 가지 한계
- 점수 상한선이 없음 (Unbounded): 매 쿼리마다 최대 점수가 유동적으로 요동쳐 타 검색 스코어와 단순 합산이 어렵습니다.
- 어휘 미스매치 (Vocabulary Mismatch): 검색어가 문서 내에 존재하지 않으면 해당 단어 기여도는
0이 됩니다. (예: '노트북' 검색 시 '랩탑'만 적힌 문서 누락)
2. 벡터 공간에서 유사도를 재는 방법
밀집 벡터(dense vector) 검색은 쿼리 문장도 임베딩하여 다차원 공간상에서 문서 벡터 간의 유사도 거리를 측정하는 과정입니다.
OpenSearch의 space_type 설정을 통해 cosinesimil, innerproduct, l2 중 하나를 선택해 색인합니다.
WARNING반드시 사용하고자 하는 임베딩 모델이 학습될 때 기준으로 삼았던 거리 척도와 동일하게 매핑해야 합니다. 다르게 매핑할 경우 정렬 결과가 완전히 왜곡됩니다.
3. HNSW로 대규모 벡터에서 근사 최근접 이웃 찾기
HNSW(Hierarchical Navigable Small World)는 대규모 벡터 공간에서 근사 최근접 이웃(ANN)을 빠르게 찾기 위한 멀티레이어 그래프 구조를 말합니다.
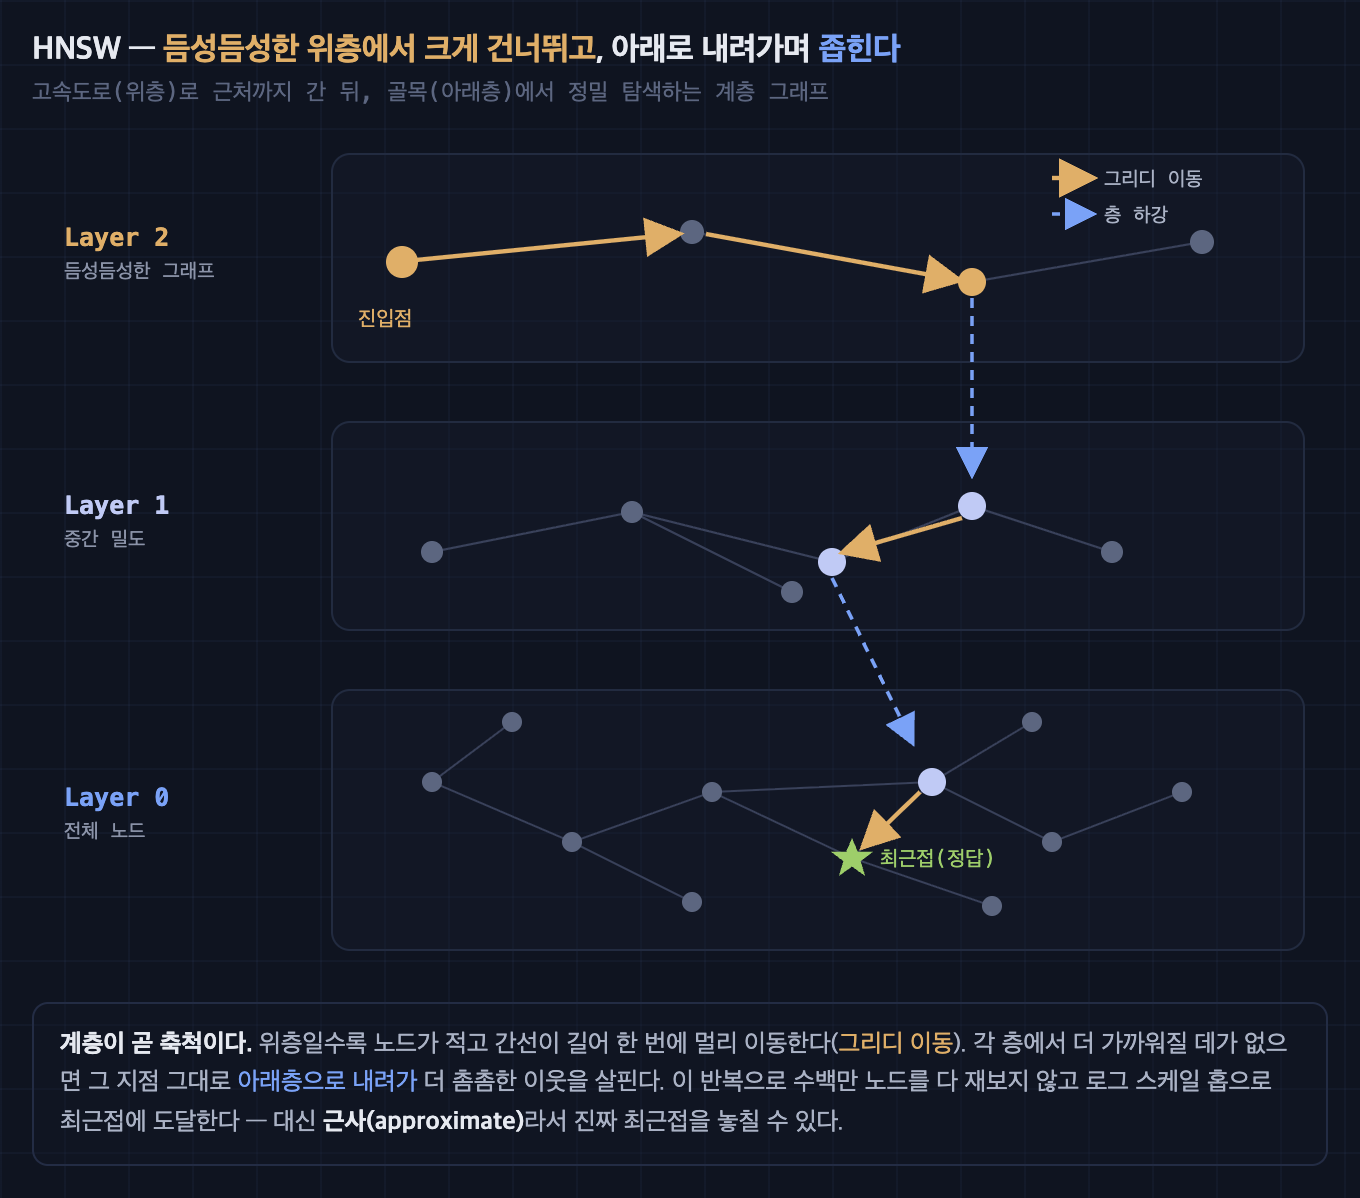
- 상위 레이어: 노드가 성기고 간선이 길어 공간을 크게 건너뜁니다. (고속도로)
- 하위 레이어: 바닥(Layer 0)으로 갈수록 노드가 빽빽해져 좁은 범위 내에서 미세 조정합니다. (골목길)
첫 번째 병목: HNSW 파라미터 튜닝
HNSW는 정확도(Recall), 지연시간(Latency), 메모리 사용량 간의 트레이드오프가 뚜렷합니다.
- 간선 수 (): 노드당 최대 연결 수. 값이 클수록 Recall은 오르나 인덱스가 항상 상주하는 램(RAM) 용량 압박이 커짐.
- 탐색 범위 (
ef_search): 검색 시 확인할 후보 노드 수. 값이 클수록 Recall은 상승하지만 연산이 지연됨.
실무 튜닝 팁:
- 기준 설정: Brute-force(
exactkNN)로 계산한 진짜 정답 셋 대비 HNSW의 교집합 비율을 측정하여 목표 Recall(예: 95%)을 먼저 고정하고, - 질의 타임 우선: 매번 인덱스를 재빌드해야 하는 이나
ef_construction보다는, 검색 쿼리에 즉시 적용할 수 있는ef_search값을 먼저 튜닝해 응답 속도를 최적화합니다.
4. 두 점수를 어떻게 섞을 것인가
BM25 결과와 kNN 결과 점수를 단순 합산하는 구조는 사용할 수 없습니다.
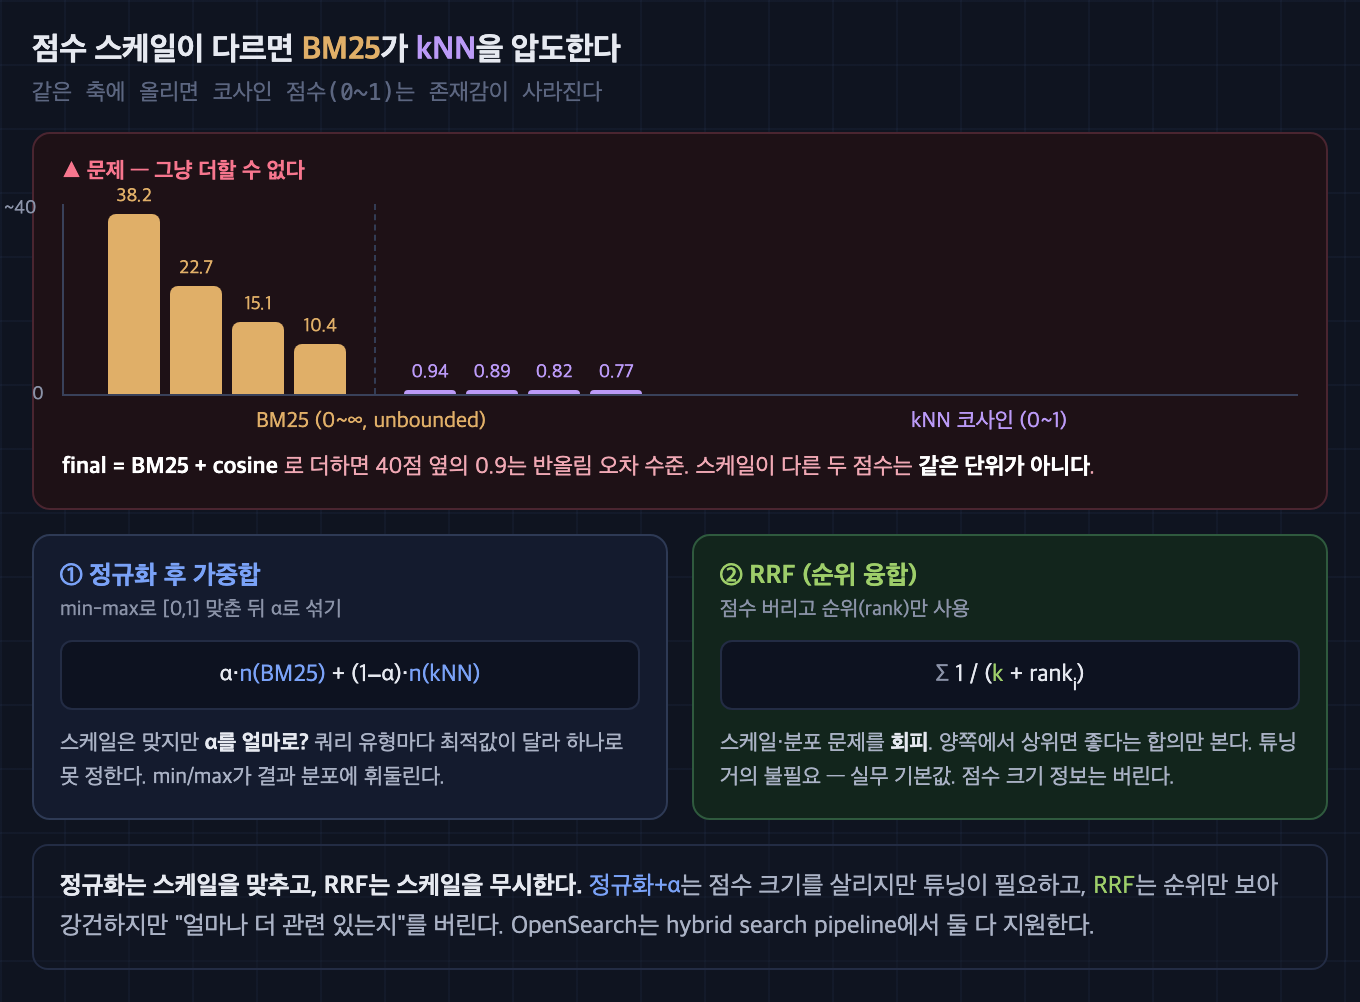
- 점수 스케일 격차: BM25는 수십 점 단위로 튀어오르는 반면, 코사인은 최대
1이하의 소수점 값을 가집니다. 단순 병합 시 코사인 점수는 완전히 묻힙니다. - 정규화 가중합의 한계: OpenSearch는 min-max 정규화와 가중합 파이프라인을 지원하지만, 쿼리 성격(고유명사 vs 자연어 질의)에 따라 최적 가중치가 상이하여 튜닝 리소스가 큽니다.
RRF — 점수 대신 순위만 쓰는 대안
점수의 절대 수치를 무시하고 반환된 순위(Rank) 정보만으로 융합하는 RRF(Reciprocal Rank Fusion)를 적용합니다.
| 문서 | BM25 순위 (역수) | kNN 순위 (역수) | RRF 최종 점수 계산 | 통합 순위 |
|---|---|---|---|---|
| 문서 A | 2등 () | 5등 () | 1위 | |
| 문서 C | 12등 () | 2등 () | 2위 | |
| 문서 B | 1등 () | 35등 () | 3위 |
- RRF의 강점: 점수 분포와 무관하게 작동하므로 가중치 유지보수 비용이 거의 들지 않아 실무상 가장 안정적인 기본값으로 기능합니다. 단, "얼마나 관련 있는지"에 대한 점수 크기 데이터는 소실됩니다.
5. 세 번째 병목: 필터를 걸면 kNN 결과가 줄어드는 문제
kNN 벡터 검색에 '재고 유무'나 '카테고리' 등 정형 필터(filter)를 걸면 탐색 방식에 따라 결과 누수가 생깁니다.
사후 필터 (post-filter) 방식
탐색 중 필터 (efficient filtering) 방식
- 사후 필터 (post-filter): HNSW로 먼저 개를 추출한 뒤 필터를 태우는 방식으로, 조건이 좁으면 결과 목록이 극단적으로 적어지거나 아예 없을 수 있습니다.
- 탐색 중 필터 (efficient filtering): 그래프를 홉(hop)하는 단계에서 필터 조건 노드만 선별해 최종 개를 보장합니다.
인프라 가이드:
OpenSearch의 engine으로 Lucene이나 최신 Faiss를 지정해 efficient filtering이 작동하도록 인프라 매핑을 구성해야 합니다. 필터를 통과하는 대상 문서 개수가 매우 적을 때는 엔진이 스스로 Exact Search(1:1 전수 비교)로 알아서 우회하여 효율을 챙길 수 있습니다.
정리
하이브리드 검색 구현 시 트렌디한 파라미터나 특정 도구 옵션에 매몰되기 쉽습니다. 핵심 메커니즘의 이해를 통해 진짜 문제를 식별할 수 있습니다.
- HNSW 튜닝: 무조건적인 파라미터 인상이 아니라, 기준 벤치마크 셋을 통한 목표 Recall 고정이 우선입니다.
- 점수 병합: 스케일 조율 리소스를 줄이려면 순위 기반인 RRF가 무난하고 단단한 기본 대안입니다.
- 필터 결합: 결과 개수 유실을 피하려면 반드시 탐색 중 필터(efficient filtering)를 보장하는 엔진 스펙을 파악하고 시작해야 합니다.
돌아보면 세 문제 모두 각 검색 방식이 내부적으로 어떻게 동작하는지 제대로 안 보고 파라미터나 옵션만 만졌을 때 헤맸던 경우였습니다.
부록. OpenSearch 버전별 Efficient Filtering 지원
efficient filtering은 OpenSearch의 kNN 엔진과 버전에 따라 지원 여부가 다릅니다.
| OpenSearch 버전 | Lucene (HNSW) | Faiss (HNSW) | Faiss (IVF) | NMSLIB |
|---|---|---|---|---|
| 2.3 이하 | ❌ | ❌ | ❌ | ❌ |
| 2.4 ~ 2.8 | ✅ | ❌ | ❌ | ❌ |
| 2.9 | ✅ | ✅ | ❌ | ❌ |
| 2.10 이상 | ✅ | ✅ | ✅ | ❌ |
NOTE
- Lucene는 OpenSearch 2.4부터 efficient filtering을 지원합니다.
- Faiss(HNSW) 는 OpenSearch 2.9부터 지원합니다.
- Faiss(IVF) 는 OpenSearch 2.10부터 지원합니다.
- NMSLIB는 efficient filtering을 지원하지 않으며, 현재는 신규 구축 시 Lucene 또는 Faiss 사용이 권장됩니다.
TIPefficient filtering은 knn 쿼리 내부에 filter를 함께 지정할 때 동작합니다. Lucene과 Faiss 엔진은 필터 선택도와 검색 대상 규모를 고려해 ANN 탐색과 Exact Search를 자동으로 선택하므로, 개발자가 직접 실행 방식을 결정할 필요는 없습니다.