
Apache Airflow를 처음 학습하면서 정리한 글입니다. Docker Compose로 환경을 띄우고 하루 동안 핵심 개념을 실습했는데, "Hello World는 쉬운데 본게임은 따로 있다"는 게 결론이었습니다. 이 글은 그 첫날치 — DAG의 개념, 구성요소 아키텍처, 파싱과 실행의 구분, XCom, Dynamic Task Mapping, Asset 기반 스케줄링, REST API 트리거까지를 다룹니다.
Airflow는 왜 필요한가
배치 작업 스케줄링이라면 cron이 이미 있습니다. Airflow의 존재 이유는 "의존성 있는 작업들" 을 다룰 때 드러납니다.
| cron | Airflow | |
|---|---|---|
| 순서 보장 | ❌ 시간차로 어림짐작 ("A는 2시, B는 2시 30분에") | ✅ A가 끝나야 B 시작 |
| A가 실패하면 | B는 모르고 그냥 돈다 | B는 실행되지 않음 |
| 재시도 | 직접 구현 | retries=3 한 줄 |
| 과거 날짜 재실행 | 직접 구현 | backfill 내장 |
| 실행 이력/로그 | 직접 구현 | UI에서 조회 |
한 줄로 정리하면, Airflow는 의존성 있는 배치 작업들의 스케줄러 + 실행 관리자입니다.
DAG — 파이프라인의 단위
DAG = Directed Acyclic Graph (방향성 비순환 그래프). 말은 어렵지만 실체는 "작업들을 어떤 순서로 실행할지 그린 그림"입니다.
- Directed (방향성): 화살표가 있다. extract가 끝나야 transform이 시작된다.
- Acyclic (비순환): 화살표가 뒤로 돌아가지 않는다. 고리가 있으면 무한루프가 되므로 금지.
- Graph: 점(task)과 선(의존성)의 집합.
그래서 DAG 하나 = 파이프라인 하나, task 하나 = 그 안의 작업 단위 하나입니다.
구성요소
공식 docker-compose.yaml로 환경을 띄우면 컨테이너가 7개나 올라옵니다.
$ docker compose ps --format 'table {{.Service}}\t{{.Status}}'
SERVICE                 STATUS
airflow-apiserver       Up (healthy)
airflow-dag-processor   Up (healthy)
airflow-scheduler       Up (healthy)
airflow-triggerer       Up (healthy)
airflow-worker          Up (healthy)
postgres                Up (healthy)
redis                   Up (healthy)
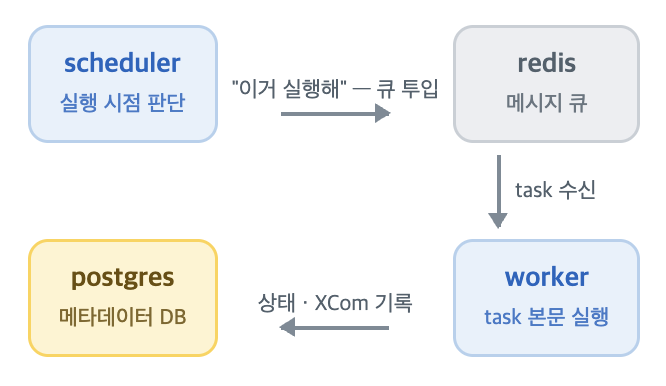
처음엔 "redis, postgres가 왜 같이 뜨지?" 싶었는데, 역할을 나눠 보면 명확해집니다. postgres는 메타데이터 DB로 DAG 구조·실행 이력·XCom을 전부 담고, redis는 scheduler와 worker 사이의 메시지 큐입니다.
| 컨테이너 | 역할 |
|---|---|
| dag-processor | dags/ 폴더의 파이썬 파일을 주기적으로 읽고 파싱 |
| scheduler | "지금 실행할 task가 뭐지?" 판단, 큐에 투입 |
| worker | task를 실제로 실행하는 일꾼 |
| apiserver | 웹 UI + REST API |
| triggerer | 비동기 대기 전담 (뒤에서 다시 등장) |
| postgres | 메타데이터 DB — Airflow의 "기억". DAG 구조, 실행 이력, 성공/실패 상태, XCom 전부 여기에 |
| redis | 메시지 큐 — scheduler → worker 사이의 "전달함" |
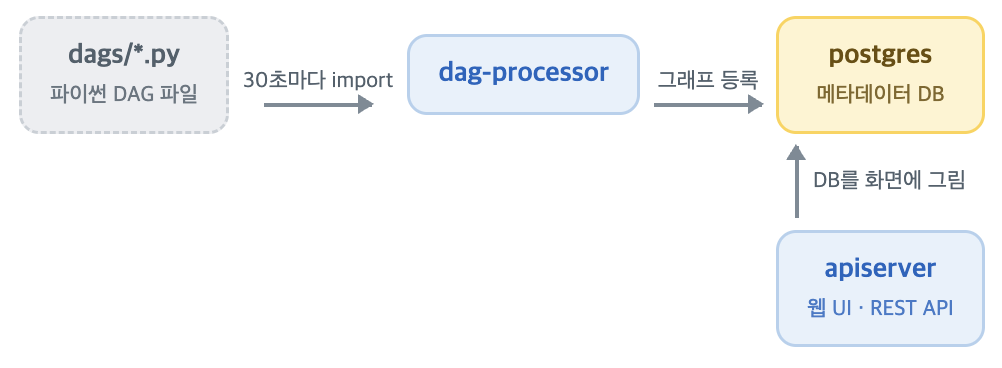
동작은 두 경로로 나뉩니다. 먼저 DAG 파일이 UI에 나타나기까지의 파싱 경로:
그리고 task가 실행되고 기록되기까지의 실행 경로:
세 가지 핵심 포인트:
- Airflow 컨테이너 5개는 전부 같은 이미지입니다. compose 파일을 보면
command:만 다릅니다(scheduler,celery worker, ...). 하나의 프로그램을 역할별로 5번 띄운 것. - Airflow는 상태를 자기 안에 갖지 않습니다. 모든 상태는 postgres에 있습니다. scheduler를 죽였다 살려도 이력이 안 날아가는 이유이고, 반대로 postgres 볼륨을 지우면 전부 초기화됩니다. UI에서 보는 모든 것(DAG 목록, 초록/빨강 격자)은 사실 postgres 테이블을 화면에 그린 것입니다.
- redis는 Airflow의 필수 요소가 아니라, 선택한 Executor 때문에 따라온 것입니다.
세 번째가 Executor 개념입니다. Executor는 "task를 어디서 어떻게 실행할 것인가"의 전략이에요.
| Executor | task 실행 위치 | Redis 필요? | 용도 |
|---|---|---|---|
| LocalExecutor | scheduler와 같은 머신의 프로세스 | ❌ | 소규모, 단일 서버 |
| CeleryExecutor | 별도 worker 머신들 (수평 확장 가능) | ✅ 큐로 분배 | 중규모 |
| KubernetesExecutor | task마다 k8s Pod 하나씩 생성 | ❌ | 대규모, k8s 환경 |
공식 compose가 CeleryExecutor 구성이라 redis가 포함된 것입니다. worker가 여러 대일 때 누가 어떤 task를 가져갈지 교통정리하는 역할을 합니다.
DAG는 UI가 아니라 코드로 작성한다
Airflow에서 DAG는 UI에서 만들 수 없습니다. 파이썬 파일로 직접 작성하는 것이 설계 철학(Workflows as Code)입니다.
흐름은 앞의 파싱 경로 그림 그대로입니다 — dags/에 파일을 저장하면 dag-processor가 파싱해 postgres에 등록하고, 약 30초 안에 UI에 나타납니다. 파일을 지우면 UI에서도 사라지고, 수정하면 반영됩니다. 진실의 원천(source of truth)은 항상 파이썬 파일입니다. 코드 방식의 장점은:
- 버전 관리 — git으로 추적, 리뷰, 롤백
- 동적 생성 — 테이블 100개면 UI 클릭 100번 대신 반복문 3줄
- 테스트 가능 — pytest로 "순환이 없는지, 파싱되는지" 자동 검증
- 재사용 — 공통 패턴을 함수/모듈로 공유
첫 DAG는 이렇게 생겼습니다. Airflow 3의 TaskFlow API(@dag/@task 데코레이터) 기준입니다.
from datetime import datetime
from airflow.sdk import dag, task


@dag(
    schedule="@daily",
    start_date=datetime(2026, 6, 1),
    catchup=False,
    tags=["learning"],
)
def hello_airflow():
    @task
    def extract() -> list[int]:
        return [1, 2, 3, 4, 5]

    @task
    def transform(numbers: list[int]) -> int:
        return sum(numbers)

    @task
    def load(total: int) -> None:
        print(f"결과 {total} 저장")

    load(transform(extract()))


hello_airflow()
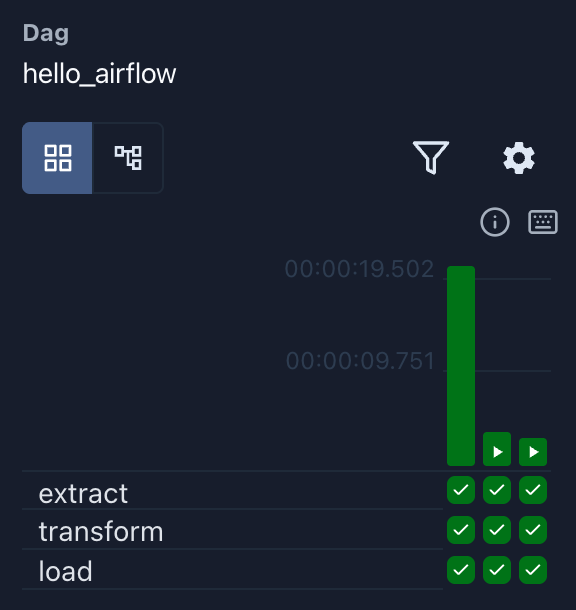
UI는 운영(Trigger, pause/unpause, 로그 조회, 실패 task 재실행)과 일부 입력(Variables, Connections, Trigger 시 파라미터)에만 쓰입니다. 구조 변경은 무조건 코드입니다.
파싱과 실행은 다르다
위 코드에서 가장 헷갈렸던 부분이 마지막의 load(transform(extract()))입니다. 함수를 실행하는 것처럼 보이지만, 실제로는 아무것도 실행되지 않습니다.
@task로 감싸진 함수는 호출해도 본문이 돌지 않습니다. 대신 "이 task가 미래에 만들 결과값"을 가리키는 자리표시자(XComArg)가 반환됩니다.
numbers = extract()          # "extract의 미래 결과" 티켓 발행 → task 등록
total = transform(numbers)   # extract → transform 의존성 생성
load(total)                  # transform → load 의존성 생성
즉 데이터를 처리하는 코드가 아니라 "누가 누구의 출력을 받는다"는 설계도를 그리는 코드입니다. 이 구분을 시점으로 정리하면:
- 파싱 시점: dag-processor가 30초마다 파일을 import → 최상위 코드가 실행되고,
@task호출은 그래프 등록만 → 구조가 postgres에 저장 - 실행 시점: 스케줄 도래 or Trigger → worker가 그제서야 task 본문을 진짜 실행
여기서 실무 베스트 프랙티스 1순위가 나옵니다. 최상위(top-level) 코드에는 무거운 작업을 넣으면 안 됩니다.
import requests

data = requests.get("https://api.example.com/config")  # 😱 30초마다 API 호출됨!

@dag(...)
def my_dag():
    @task
    def use_data():
        ...  # 본문은 실행 시점으로 미뤄지지만, 위의 최상위 코드는 파싱마다 돈다
파이썬에서 import는 곧 최상위 코드 실행이기 때문입니다. DB 조회, API 호출은 반드시 task 함수 안으로 넣어야 합니다.
리턴값이 필요 없는 순서 연결은 >> 연산자를 씁니다.
load(transform(extract())) >> notify() # load 끝나면 notify (데이터 전달 없음)
XCom
XCom(Cross-Communication)은 task끼리 작은 데이터를 주고받는 메커니즘입니다.
왜 필요할까요? task는 각각 별도 프로세스로, CeleryExecutor에서는 서로 다른 worker 머신에서 실행될 수 있습니다. 프로세스가 다르니 메모리 공유가 안 되고, 그래서 Airflow는 중간에 postgres를 경유시킵니다.
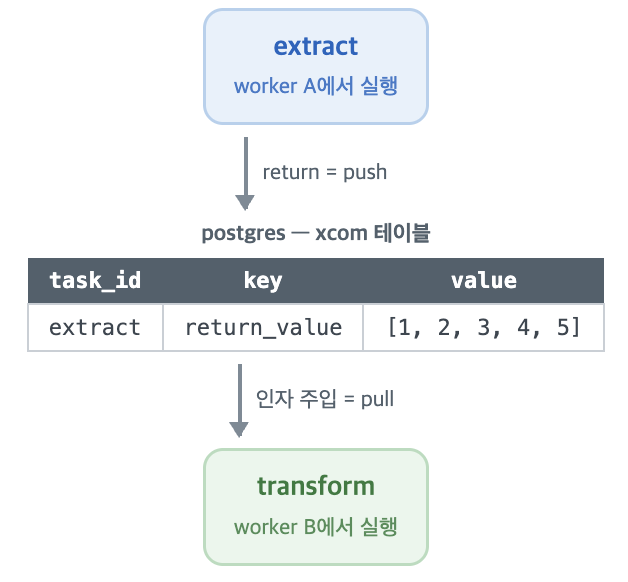
- task가 값을 리턴하면 → postgres의
xcom테이블에 저장 (push) - 다음 task가 그 값을 인자로 받으면 → 테이블에서 꺼내 줌 (pull)
TaskFlow API에서는 리턴/인자만으로 자동 처리됩니다. 직접 확인해 보면:
$ docker compose exec postgres psql -U airflow \
    -c "SELECT task_id, key, value FROM xcom WHERE dag_id='hello_airflow';"

  task_id  |     key      |      value
-----------+--------------+-----------------
 extract   | return_value | [1, 2, 3, 4, 5]
 transform | return_value | 15
재밌는 점: load의 행은 없습니다. UI에서 load task의 XCom 탭을 열면 "XCom을 찾을 수 없음"이 뜨는데, 오류가 아니라 "이 task는 아무것도 리턴하지 않았다"는 뜻입니다. 리턴 = push, 리턴 없음 = push 없음. 규칙은 그게 전부입니다.
원칙: 데이터는 스토리지로, XCom에는 위치만
XCom에는 중요한 제약이 있습니다. 큰 데이터를 넘기면 안 됩니다. DB 테이블에 직렬화되어 저장되는 구조라서, 큰 값을 넘기면 메타데이터 DB가 비대해지고 직렬화 비용으로 성능이 떨어집니다.
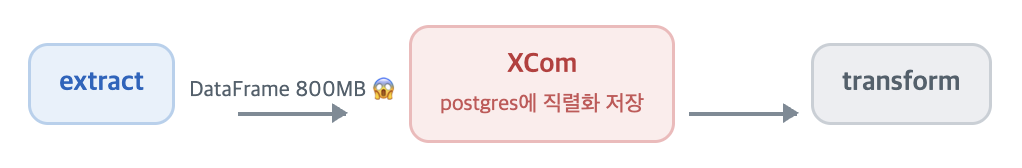
- ✅ 적합: 건수, 파일 경로, S3 키, 날짜, 작은 dict — "다음 task가 알아야 할 메타정보"
- ❌ 부적합: DataFrame, 수백 MB CSV 내용물
실무 패턴은 이렇습니다.
@task
def extract() -> str:
    df.to_parquet("/data/2026-06-04.parquet")   # 실제 데이터는 스토리지에
    return "/data/2026-06-04.parquet"            # XCom에는 경로만

@task
def transform(path: str):
    df = pd.read_parquet(path)                   # 경로 받아서 직접 로드
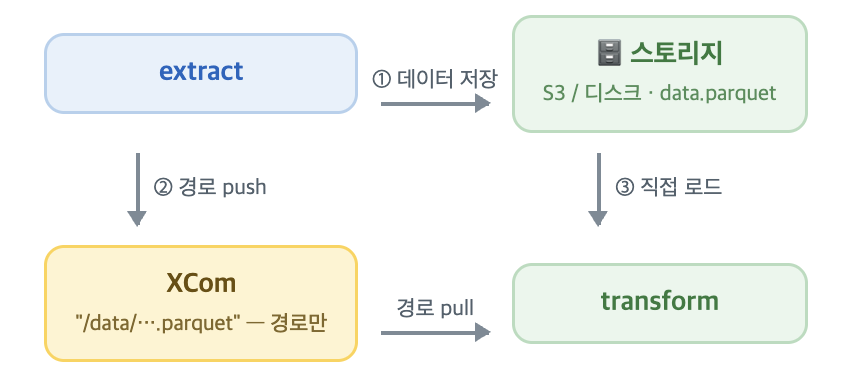
"데이터는 스토리지(S3, HDFS, DB)로, XCom에는 그 위치만." Airflow는 데이터를 나르는 도구가 아니라 작업을 지휘(orchestrate)하는 도구다.
이 철학은 task 설계 전반에 적용됩니다. 실무 task의 상당수는 worker가 직접 일하는 게 아니라 일하라고 시키고 기다리는 코드입니다 — SQL은 DB가, 대용량 처리는 Spark가, 컨테이너 작업은 k8s Pod이 하고, worker의 파이썬은 "요청 보내고, 끝났는지 확인하고, 성공/실패 기록"만 합니다.
op_args / op_kwargs — 과거의 유산
Airflow 자료를 검색하면 이런 코드가 정말 많이 나옵니다.
from airflow.providers.standard.operators.python import PythonOperator

def greet(name, count, lang="ko"):
    print(f"{name}님 안녕하세요 x{count} ({lang})")

t = PythonOperator(
    task_id="greet_task",
    python_callable=greet,        # 실행할 함수
    op_args=["민서", 3],           # → 위치 인자로 전달
    op_kwargs={"lang": "en"},     # → 키워드 인자로 전달
)
op_args/op_kwargs는 TaskFlow 이전의 고전 방식(PythonOperator)에서 함수에 인자를 꽂아주던 통로입니다. 내부적으로 python_callable(*op_args, **op_kwargs)로 호출해 주는 거죠. 함수 정의와 task 정의가 분리되어 있어서 인자를 넘길 별도 통로가 필요했던 겁니다.
TaskFlow에서는 함수 호출 자체가 인자 전달이라 이 통로가 필요 없어졌습니다.
| PythonOperator (고전) | TaskFlow (현재 권장) | |
|---|---|---|
| 인자 전달 | op_args, op_kwargs |
함수 호출 |
| XCom 전달 | ti.xcom_pull(task_ids="...") 수동 |
인자/리턴값 자동 |
| task_id | 직접 지정 | 함수명 자동 |
그럼에도 알아둬야 하는 이유는 둘입니다. 첫째, 검색되는 자료의 절반 이상이 아직 고전 방식이라 읽고 TaskFlow로 번역할 수 있어야 합니다. 둘째, op_kwargs={"date": "{{ ds }}"}처럼 Jinja 템플릿이 먹히는 자리라서 이 패턴이 계속 눈에 띕니다.
Dynamic Task Mapping — 실행 시점에 결정되는 그래프
"처리할 파일이 매일 3개~8개씩 다르게 들어온다"면 task를 몇 개 만들어야 할까요? 파싱 시점에는 파일 개수를 알 수 없는데요.
순진한 답은 "task 하나에서 루프 돌리기"인데, 잃는 게 많습니다.
| 한 task에서 루프 | Dynamic Task Mapping | |
|---|---|---|
| 병렬성 | N개 직렬 처리 | N개 동시 (worker들에 분산) |
| 재시도 | 1개 실패 → 전부 재실행 | 실패한 그것만 |
| 관측 | 로그 한 덩어리 | 파일별 성공/실패 |
Airflow의 답은 expand()입니다.
@task
def list_files() -> list[str]:
    return scan_directory()          # 매 실행마다 개수가 다름

@task
def process(path: str) -> int:
    ...

@task
def summarize(counts: list[int]):    # mapped task 전체 결과가 리스트로 모임
    ...

files = list_files()
results = process.expand(path=files)   # ← 런타임에 N개 task로 펼쳐짐
summarize(results)
"파싱 시점에 그래프가 고정된다"는 원칙의 공식 예외입니다 — 업스트림의 XCom을 보고 실행 시점에 task 개수가 결정됩니다. 실제로 돌려보면 Grid 뷰에 process [8]처럼 펼쳐진 개수가 표시되고, 같은 DAG인데 다음 실행에서는 [4]가 되는 걸 볼 수 있습니다.
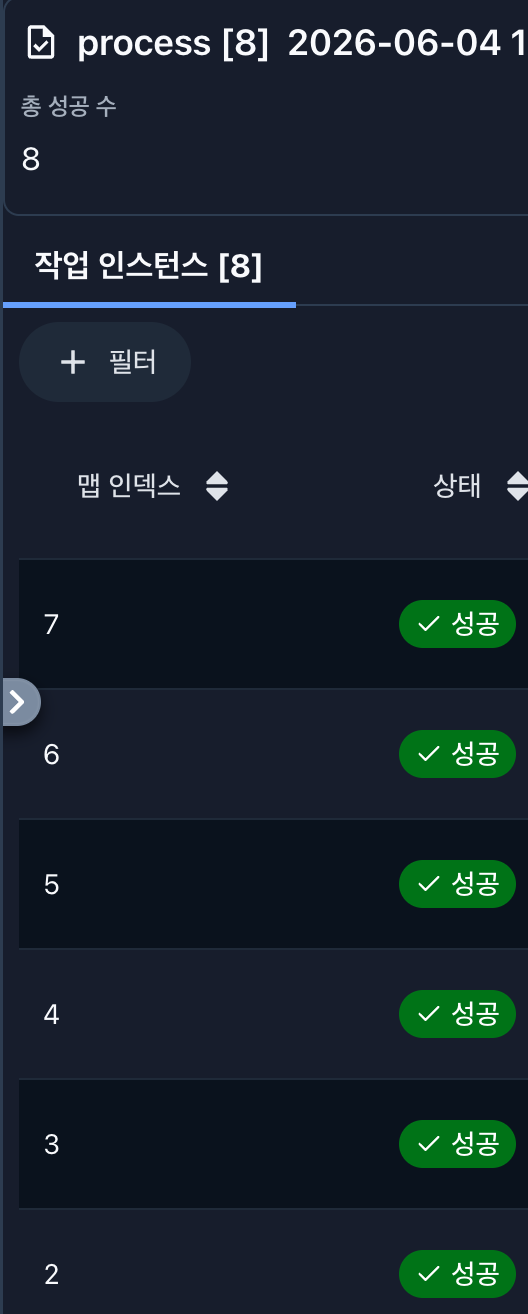
고정 인자는 partial()에, 변하는 인자만 expand()에 넣습니다.
process.partial(mode="fast").expand(path=files)
Asset — DAG 연결하기
"업스트림 팀의 DAG이 끝난 뒤에 내 DAG이 돌아야 한다"는 매우 흔한 요구사항입니다. cron 시절에는 "새벽 3시쯤이면 업스트림이 끝나 있겠지"라는 어림짐작으로 풀었는데, 업스트림이 늦어지는 날 바로 깨집니다.
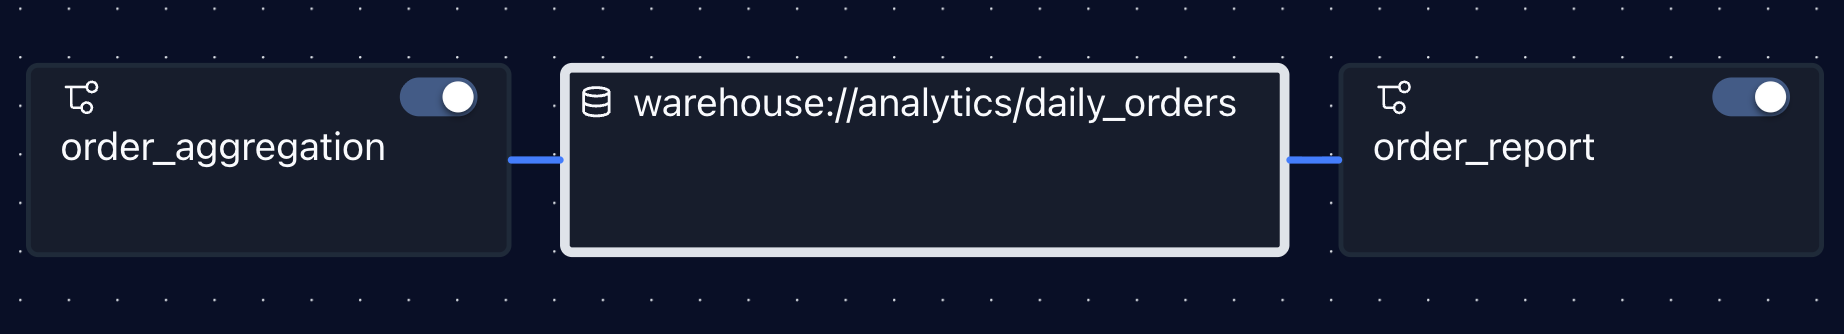
Airflow 3의 답은 Asset 기반 스케줄링입니다. "시간"이 아니라 "데이터 갱신"을 트리거로 씁니다.
# ── 업스트림 팀의 DAG ──
daily_orders = Asset("warehouse://analytics/daily_orders")

@dag(schedule="@daily", ...)
def order_aggregation():
    @task(outlets=[daily_orders])      # 성공 시 "이 Asset이 갱신됐다" 선언
    def aggregate_orders():
        ...
# ── 내 팀의 DAG (별도 파일) ──
daily_orders = Asset("warehouse://analytics/daily_orders")

@dag(schedule=[daily_orders], ...)     # 이 Asset이 갱신되면 실행
def order_report():
    @task
    def build_report():
        ...
두 DAG이 공유하는 것은 Asset URI 문자열 하나뿐이라 결합이 느슨합니다. 업스트림 팀은 다운스트림에 누가 구독 중인지 몰라도 되고, 내 팀은 업스트림 DAG 이름이 바뀌어도 영향이 없습니다.
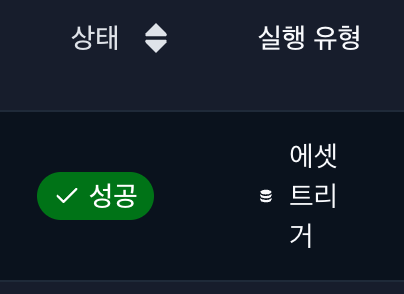
실제로 producer만 Trigger하면 consumer가 저절로 실행되고, run type이 manual이 아닌 asset_triggered로 기록됩니다.
UI의 Assets 메뉴에서 producer → Asset → consumer로 이어지는 의존 그래프도 볼 수 있습니다.
고전 방식: ExternalTaskSensor와 deferrable
Asset 이전의 답은 ExternalTaskSensor였습니다 — 남의 DAG 완료를 폴링하는 task입니다.
wait = ExternalTaskSensor(
    task_id="wait_for_upstream",
    external_dag_id="order_aggregation",   # 남의 DAG 이름을 직접 박음 (강한 결합)
    deferrable=True,                       # 대기를 worker가 아닌 triggerer에 맡김
)
기본 모드에서는 worker 프로세스 하나가 "끝났나?" 폴링하며 슬롯을 점유합니다. 이런 sensor가 30개면 worker가 일도 못 하고 꽉 차죠. deferrable=True를 주면 대기 중인 task를 worker에서 내려놓고 triggerer가 비동기로 감시합니다 — 컨테이너 7개 중 triggerer의 존재 이유가 이것입니다.
오늘 기준 선택 가이드: 팀 간 의존 → Asset, 같은 DAG 안 → >>, 외부 이벤트 대기(S3 파일 도착 등) → deferrable sensor.
schedule에는 무엇이 들어가는가
지금까지 "@daily", None, [Asset] 세 가지가 나왔는데, 전체 목록은 이렇습니다.
| 값 | 의미 | 예 |
|---|---|---|
| 크론 문자열 | 벽시계 기준 시각 | "0 3 * * *" |
| 프리셋 | 크론 별칭 | "@daily", "@hourly", "@once" |
None |
수동/API 전용 | — |
timedelta |
start_date 기준 등간격 | timedelta(hours=6) |
| Asset (목록/식) | 데이터 갱신 시 | [a, b](AND), a | b(OR), (a & b) | c |
| Timetable | 커스텀 규칙 | 영업일만, 공휴일 제외 등 |
조합도 됩니다.
# 크론 한 줄로 불가능한 시각 조합 (09:00와 14:30)
schedule=MultipleCronTriggerTimetable("0 9 * * *", "30 14 * * *", timezone="Asia/Seoul")

# "데이터 갱신되면 즉시, 무슨 일이 있어도 하루 한 번은" — 업스트림 장애 대비 안전망
schedule=AssetOrTimeSchedule(
    timetable=CronTriggerTimetable("0 0 * * *", timezone="Asia/Seoul"),
    assets=(orders | users),
)
크론과 timedelta의 차이가 미묘하게 중요합니다. 크론 0 */6 * * *는 벽시계 기준(0, 6, 12, 18시 정각)이고, timedelta(hours=6)는 start_date 기준 등간격입니다. "3일마다" 같은 주기는 timedelta로만 정확히 표현됩니다.
REST API로 트리거하기
schedule=None인 DAG의 주 용도가 이것입니다 — 다른 시스템이 REST API로 찔러주는 이벤트 드리븐 파이프라인. 두 단계면 됩니다.
# ① JWT 토큰 발급
TOKEN=$(curl -s -X POST http://localhost:8080/auth/token \
  -H "Content-Type: application/json" \
  -d '{"username": "airflow", "password": "airflow"}' | jq -r .access_token)

# ② DAG 트리거 (conf로 파라미터 전달)
curl -X POST http://localhost:8080/api/v2/dags/hello_airflow/dagRuns \
  -H "Authorization: Bearer $TOKEN" \
  -H "Content-Type: application/json" \
  -d '{"logical_date": null, "conf": {"batch_id": 12345}}'
응답을 보면 큐에 들어간 것과 API 경유 트리거임이 기록됩니다.
{
  "dag_run_id": "manual__2026-06-04T09:38:02...",
  "state": "queued",
  "triggered_by": "rest_api",
  "conf": { "batch_id": 12345 }
}
conf는 호출자가 DAG에게 건네는 파라미터이고, task 안에서 이렇게 받습니다.
@task
def process(**context):
    conf = context["dag_run"].conf      # {"batch_id": 12345}
    print(f"배치 {conf.get('batch_id')} 처리")
주문 시스템의 "정산 완료" 이벤트, S3/Kafka 이벤트 수신 프로세스, CI 파이프라인 등이 이 API의 호출자가 됩니다. 참고로 UI의 Trigger 버튼과 CLI도 결국 같은 API를 호출합니다 — Airflow 3에서 웹 UI 자체가 REST API의 클라이언트라서, 컨테이너 이름도 webserver가 아니라 apiserver입니다. 전체 API 문서는 http://localhost:8080/docs(Swagger UI)에서 볼 수 있습니다.
마치며
여기까지가 "Airflow에게 일 시키는 법"입니다. 문법은 단순합니다. 그런데 학습 중 이런 퀴즈에 부딪혔습니다.
schedule="@daily",start_date=datetime(2026, 6, 1)인 DAG에서, 6월 4일 자정에 실행된 run의logical_date는 며칠일까?
답은 6월 4일도, 6월 1일도 아닌 6월 3일입니다. "오늘 도는 DAG은 어제 데이터를 처리한다" — 이 시간 의미론(logical_date, data_interval, catchup, backfill)과 멱등성 설계가 Airflow의 진짜 학습 구간이고, 모든 팀이 한 번씩 사고 내는 지점이라고 합니다. 이 주제는 다음 글에서 다룹니다 — 그리고 이 퀴즈의 정답도 거기서 한 번 더 바뀝니다.