
지난 글을 이런 퀴즈로 마쳤습니다.
schedule="@daily",start_date=datetime(2026, 6, 1)인 DAG에서, 6월 4일 자정에 실행된 run의logical_date는 며칠일까?
당시 답은 "6월 3일"이라고 알고 있었는데, 직접 실습해 보니 정답이 달랐습니다. Airflow 3에서 기본 동작이 바뀌었기 때문입니다. 이 글은 Airflow 학습의 마지막 편으로, 그 변화를 포함한 시간 의미론 전체(logical_date, Timetable, catchup, 백필, 멱등성)와, 실습 중 실제로 겪은 사고를 계기로 정리한 시간 저장의 교과서와 현실(KST vs UTC)을 다룹니다.
logical_date — run에 붙는 이름표
Airflow에서 모든 run은 시각 형태의 이름표를 가집니다. Run ID에도 그대로 박혀 있습니다: scheduled__2026-06-03T00:00:00+00:00. 이 이름표가 logical_date이고, 이름표를 어떻게 붙일지 결정하는 정책이 Timetable입니다.
고전적인 규칙(Airflow 2.x 기본)은 이랬습니다.
run은 자기가 담당하는 데이터 구간(data interval)이 닫힌 뒤에 실행되고,
logical_date는 그 구간의 시작점이다.
@daily면 하루가 한 구간입니다. 6월 4일치 데이터는 6월 4일이 다 지나야 완성되므로, 6/4분 처리는 6/5 자정에 돌고 이름표는 6/4 — "오늘 도는 DAG은 어제 데이터를 처리한다"는 Airflow의 상징적 동작이죠. 위 퀴즈의 "6월 3일"이라는 답도 이 규칙에서 나온 것입니다.
실습: 같은 @daily, 다른 의미론
그런데 검증해 보니 달랐습니다. 같은 @daily 스케줄로 DAG 두 개를 만들어 비교했습니다. 하나는 문자열 그대로(schedule="@daily"), 하나는 고전 Timetable을 명시했습니다.
# DAG 1 — Airflow 3 기본 (문자열은 CronTriggerTimetable로 해석됨)
@dag(schedule="@daily", start_date=datetime(2026, 6, 1), catchup=True, ...)

# DAG 2 — 고전 의미론을 명시
from airflow.timetables.interval import CronDataIntervalTimetable

@dag(
    schedule=CronDataIntervalTimetable("@daily", timezone="UTC"),
    start_date=datetime(2026, 6, 1),
    catchup=True,
    ...
)
오늘이 6월 5일(UTC 00:15)인 시점에 unpause한 결과를 DB에서 직접 조회하면:
SELECT dag_id, logical_date, data_interval_start AS di_start, data_interval_end AS di_end
FROM dag_run WHERE run_type='scheduled' ORDER BY logical_date;

         dag_id         |      logical_date      |        di_start        |         di_end
------------------------+------------------------+------------------------+------------------------
 interval_semantics_lab | 2026-06-01 00:00:00+00 | 2026-06-01 00:00:00+00 | 2026-06-02 00:00:00+00
 time_semantics_lab     | 2026-06-01 00:00:00+00 | 2026-06-01 00:00:00+00 | 2026-06-01 00:00:00+00
 ...
 interval_semantics_lab | 2026-06-04 00:00:00+00 | 2026-06-04 00:00:00+00 | 2026-06-05 00:00:00+00
 time_semantics_lab     | 2026-06-04 00:00:00+00 | 2026-06-04 00:00:00+00 | 2026-06-04 00:00:00+00
 time_semantics_lab     | 2026-06-05 00:00:00+00 | 2026-06-05 00:00:00+00 | 2026-06-05 00:00:00+00
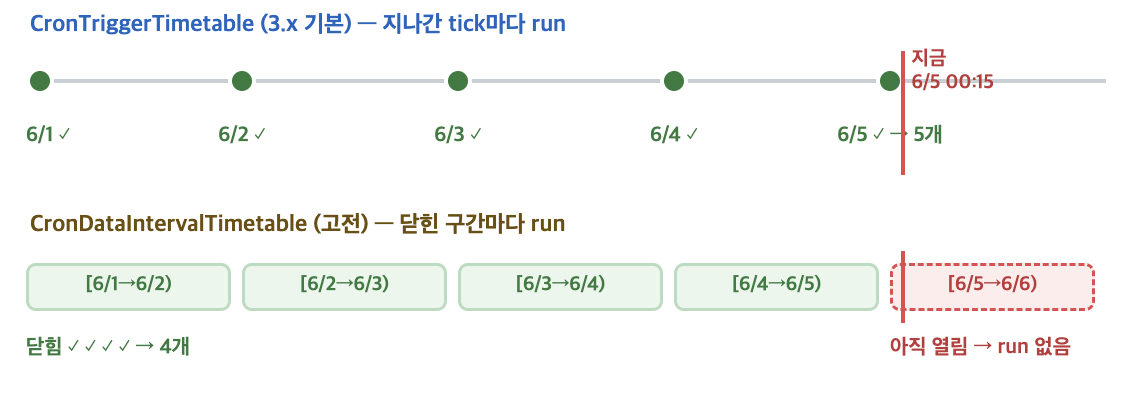
DAG 1은 run 5개, DAG 2는 4개입니다. 그리고 DAG 1은 구간 폭이 0(di_start = di_end), DAG 2는 24시간입니다.
| CronDataIntervalTimetable (2.x 기본) | CronTriggerTimetable (3.x 기본) | |
|---|---|---|
| run 생성 조건 | 구간이 닫혀야 | tick이 지나가면 |
logical_date |
지난 구간의 시작 (6/5 자정 실행 → 6/4) | tick 시각 그대로 (6/5 자정 실행 → 6/5) |
| data_interval | 폭 1일 | 폭 0 |
| 직관 | "어제 데이터를 처리하는 run" | "그 시각에 그냥 도는 run" (cron과 동일) |
run 개수가 다른 이유: trigger 방식은 지나간 tick을 셉니다(6/1~6/5 자정, 5번 — 6/5 tick은 15분 전에 지나감). interval 방식은 닫힌 구간을 셉니다(4개 — [6/5, 6/6) 구간은 아직 6월 5일이 진행 중이므로 열려 있고, 반쪽짜리 데이터를 처리하지 않도록 내일 자정까지 기다립니다).
같은 코드가 버전에 따라 다르게 동작
10년간 "logical_date가 왜 어제 날짜냐"는 혼란이 끊이지 않았고, Airflow 3는 결국 기본값을 바꿨습니다. 그 결과:
schedule="@daily"라는 같은 코드가 2.x에서는 interval 의미론, 3.x에서는 trigger 의미론으로 동작합니다- 검색되는 자료 대부분이 2.x 기준이므로, 읽기 전에 어느 의미론인지부터 확인해야 합니다 (서두 퀴즈의 정답이 바뀐 이유)
- Airflow 3에서 수동 run은
logical_date가 아예null일 수도 있습니다 (REST API로 트리거해 보면 보입니다)
선택 기준은 단순합니다. 시각 기반 작업(리포트 발송, 헬스체크)은 3.x 기본 그대로, 구간 데이터를 처리하는 ETL은 CronDataIntervalTimetable을 명시 — data_interval_start/end를 SQL의 WHERE ts >= ... AND ts < ...에 바로 꽂을 수 있어 경계 누락/중복이 원천 차단됩니다.
catchup — 과거를 소급 생성
위 실습에서 unpause하자마자 run 4~5개가 자동 생성된 것이 catchup=True의 동작입니다. start_date부터 현재까지, 지나간 tick(또는 닫힌 구간) 전부의 run을 만들어 줍니다. 과거 데이터를 날짜별로 채울 때는 유용하지만, start_date=datetime(2020, 1, 1) 같은 DAG에 무심코 켜면 run 수천 개가 쏟아지는 단골 사고가 됩니다. 그래서 기본값이자 평소 권장은 catchup=False이고, 과거 채우기는 뒤에 나올 backfill로 명시적으로 하는 쪽이 안전합니다.
"왜 자정 스케줄이 09:00에 돌지?"
실습 중 UI에서 이상한 점을 발견했습니다. 분명 @daily(자정) 스케줄인데 run들이 전부 09:00으로 표시되는 겁니다.
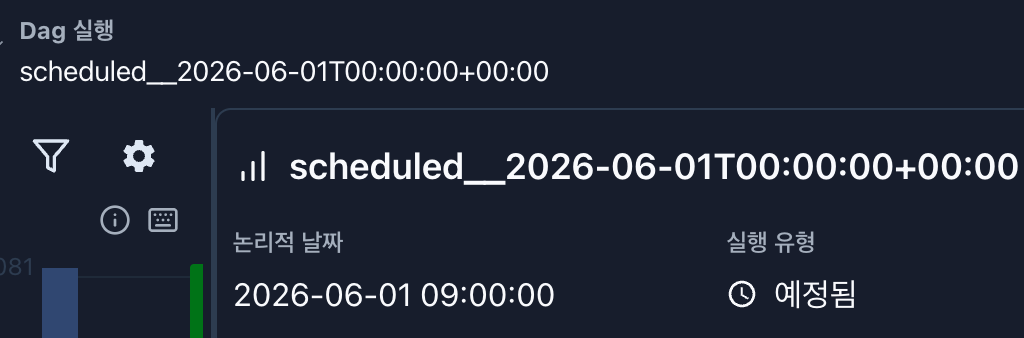
DB를 직접 보면 전부 00:00:00+00(UTC 자정)입니다. UI가 브라우저 timezone(KST)으로 변환해 보여줄 뿐이죠. UTC 자정 = KST 오전 9시. 층위별로 정리하면:
| 층위 | 기준 |
|---|---|
| DB 저장 (진실) | 항상 UTC — 절대 안 변함 |
| run의 이름표 (logical_date, ds) | 항상 UTC |
| 웹 UI 표시·입력 | UI에 설정된 timezone (보통 브라우저 로컬 = KST) |
| CLI, DAG 코드의 naive datetime | UTC로 해석 |
속은 전부 UTC, UI만 안경(KST)을 씌워 보여준다.
UI 우측 상단에서 표시 timezone을 UTC로 바꾸면 "보이는 값 = 저장된 값"이 되어 혼란이 사라집니다. 디버깅할 때 추천하는 설정입니다.
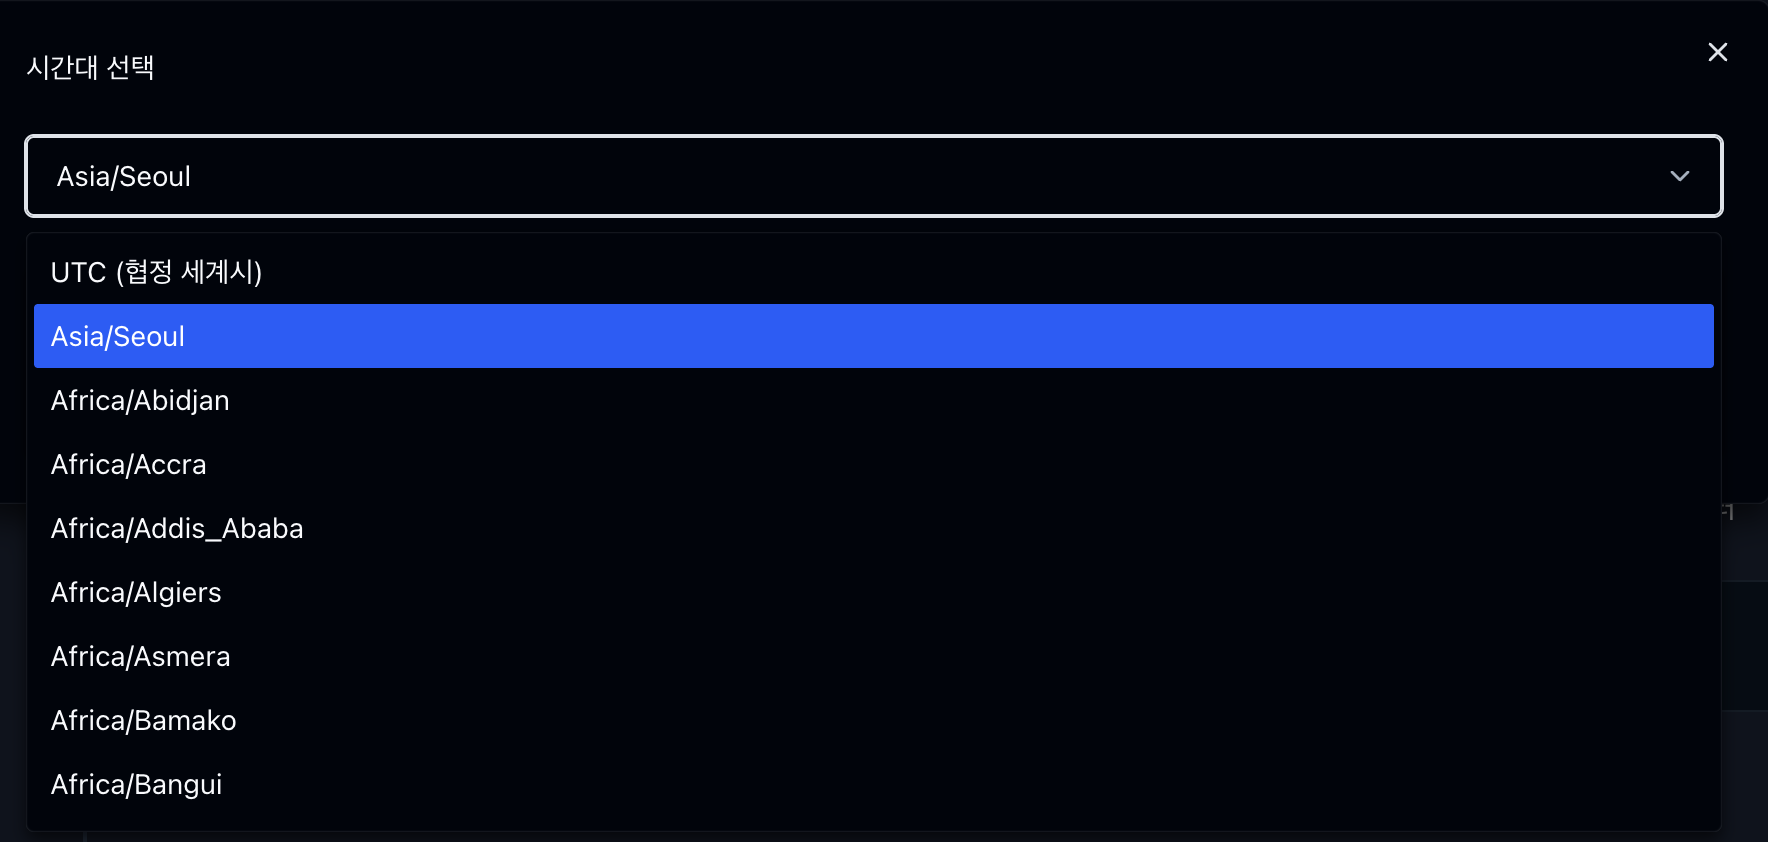
문제는 입력도 변환된다는 점인데 — 이게 실제 사고로 이어졌습니다. 사고 해부는 잠시 뒤에 하고, 먼저 이 모든 혼란의 뿌리부터 정리하겠습니다.
모든 혼란의 근원 — naive datetime
시간 관련 사고의 뿌리는 대부분 하나로 수렴합니다. timezone 정보가 없는 시각 값(naive datetime)입니다.
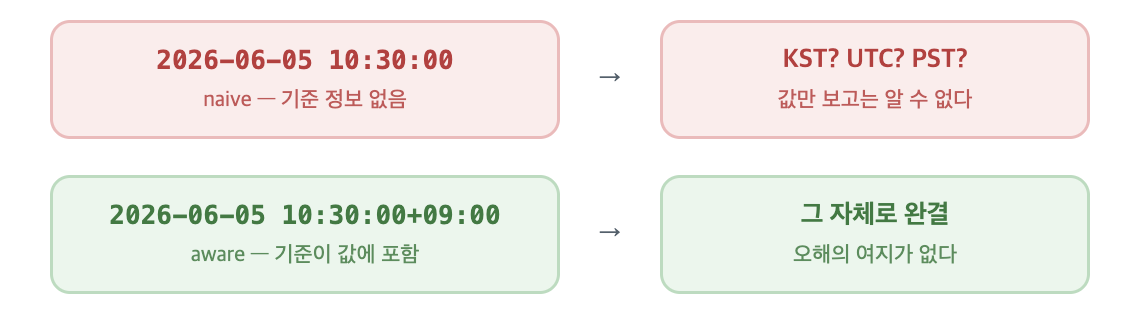
'2026-06-05 10:30:00'이라는 값만 보면 KST인지 UTC인지 아무도 알 수 없습니다. 값 자체에 기준이 없으니 "이 컬럼은 KST다"라는 암묵적 규약에 의존하게 되고, 그 규약은 담당자가 바뀌면 같이 사라집니다.
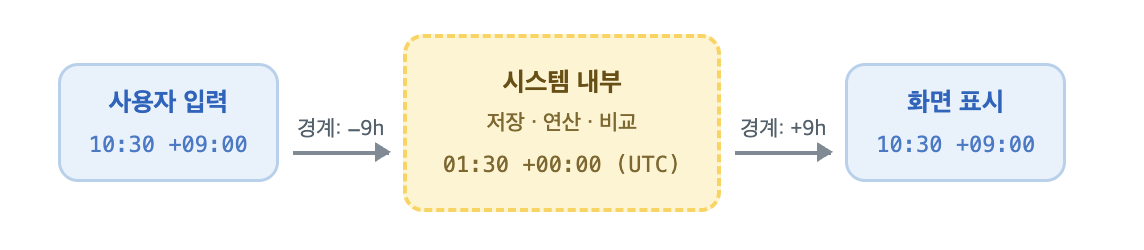
교과서적 처리는 세 문장으로 요약됩니다.
- naive datetime을 만들지 않는다 — 생성 시점부터 timezone 명시
- 저장·연산·비교는 UTC로 — 시스템 내부의 공용어
- 변환은 경계에서만 — 입력받을 때 KST→UTC, 보여줄 때 UTC→KST
from datetime import datetime, timezone
from zoneinfo import ZoneInfo

KST = ZoneInfo("Asia/Seoul")

now_kst = datetime.now(KST)                 # ✅ aware: 2026-06-05 10:30:00+09:00
now_utc = now_kst.astimezone(timezone.utc)  # 저장용: 2026-06-05 01:30:00+00:00
cur.execute("INSERT INTO events (occurred_at) VALUES (%s)", (now_utc,))

occurred_utc = cur.fetchone()[0]
print(occurred_utc.astimezone(KST))         # 표시할 때만 KST로
눈치채셨겠지만 Airflow가 정확히 이 패턴입니다. aware datetime으로 받고, DB엔 UTC로 저장하고, UI가 표시할 때만 변환 — 위에서 본 +00 저장값과 09:00 표시의 정체가 이 보편 패턴이에요.
교과서와 현실 — 한국 팀들의 세 가지 선택
여기까지가 교과서인데, 현장은 다릅니다. DB부터 보면, 같은 "시각 컬럼"이어도 timezone을 다뤄 주는 수준이 제각각입니다.
| DB | 타입 | 동작 |
|---|---|---|
| PostgreSQL | timestamptz |
aware 값을 주면 알아서 UTC로 정규화 저장 — 교과서 패턴의 든든한 짝 |
| PostgreSQL | timestamp |
주는 대로 저장. 아무것도 보장 안 함 |
| MySQL | DATETIME |
timezone 개념 자체가 없음. 규약은 전적으로 앱 책임 |
| MySQL | TIMESTAMP |
세션 time_zone 기준 UTC 변환 — 동작하지만 세션 설정 의존 |
그리고 한국 팀들의 실제 선택은 크게 셋으로 갈립니다.
패턴 A — KST 직저장 (국내 전통 다수파). 서버 TZ도 DB도 KST, MySQL DATETIME에 벽시계 값 그대로. 국내 한정 서비스의 역사 있는 시스템 대부분이 이렇습니다. 변환 레이어가 없어 단순하고 WHERE dt >= '2026-06-05'가 직관 그대로 동작하지만 — 값이 naive라 규약이 무너지면 복구 불가, 글로벌 진출 시 전면 마이그레이션, 그리고 UTC 기반 외부 시스템(클라우드, 로그 스택, Airflow)과 만날 때마다 경계 사고가 납니다.
패턴 B — UTC 저장 + 경계 변환 (교과서). 신규 설계, 글로벌 서비스, MSA의 표준.
패턴 C — epoch 직저장. BIGINT에 밀리초. timezone 논쟁 자체를 회피. 모바일 백엔드·대용량 이벤트 계열에서 흔합니다.
| 상황 | 통상 선택 |
|---|---|
| 국내 한정 + MySQL + 기존 시스템 | A 유지 (바꾸는 비용 > 이득) |
| 신규 설계 + 글로벌 가능성 조금이라도 | B (또는 C) |
| 서비스 간 통신, 이벤트, 로그 | B/C — 거의 이견 없음 |
무엇을 고르든 절대 규칙은 하나입니다.
최악은 KST도 UTC도 아닌 "혼재"입니다. 테이블 절반은 KST, 절반은 UTC, 컬럼 코멘트도 없는 시스템
그리고 Airflow는 패턴 B를 강제하는 시스템입니다. 그래서 패턴 A 조직이 Airflow를 도입하면 두 세계의 경계가 반드시 생깁니다. 그 경계에서 무슨 일이 벌어지는지, 직접 겪은 사고로 보겠습니다.
Clear와 backfill
사고 이야기 전에 도구 정리부터. run의 이름표를 배웠으니 "과거를 다시 돌린다"를 정확히 정의할 수 있습니다 — 같은 logical_date의 run을 다시 실행하는 것입니다.
- Clear: 이미 있는 run의 task 상태를 지워서 같은 이름표로 재실행. UI에서 run 상세 → Clear Run, 또는
airflow tasks clear - backfill: 없는 run도 만들어서 날짜 구간을 실행. catchup=False로 운영하던 DAG의 과거 채우기, 버그 수정 후 구간 재처리에 사용
Airflow 3의 backfill CLI에는 안전장치가 있습니다. 이미 성공한 run은 기본적으로 건드리지 않아요.
airflow backfill create --dag-id my_dag \
  --from-date 2026-06-01 --to-date 2026-06-03 \
  --reprocess-behavior completed
--reprocess-behavior |
의미 |
|---|---|
none (기본) |
없는 run만 생성 |
failed |
+ 실패한 run 재실행 |
completed |
성공한 run까지 전부 재실행 |
사례 연구: 백필에서 하루가 사라진 날
상황: 6월 1일~3일 데이터를 다시 처리하려고 UI에서 백필 범위를 "6/1 ~ 6/3"으로 입력했습니다. 결과는 6/1, 6/2만 재실행되고 6/3이 조용히 빠졌습니다.
원인은 timezone 층위 지도에 있습니다. UI는 표시만 KST로 바꾸는 게 아니라 입력도 KST로 해석해 9시간을 빼서 저장합니다. DB에 남은 증거:
SELECT id, dag_id, from_date, to_date FROM backfill;

 id |     dag_id      |       from_date        |        to_date
----+-----------------+------------------------+------------------------
  1 | idempotency_lab | 2026-05-31 15:00:00+00 | 2026-06-02 15:00:00+00  ← UI 입력 (KST 해석, −9h)
  2 | idempotency_lab | 2026-06-03 00:00:00+00 | 2026-06-03 00:00:00+00  ← CLI 입력 (UTC 그대로)
UI에 입력한 "6/1 00:00 ~ 6/3 00:00"이 UTC 5/31 15:00 ~ 6/2 15:00으로 저장됐고, run 이름표들은 UTC 자정에 박혀 있으니:
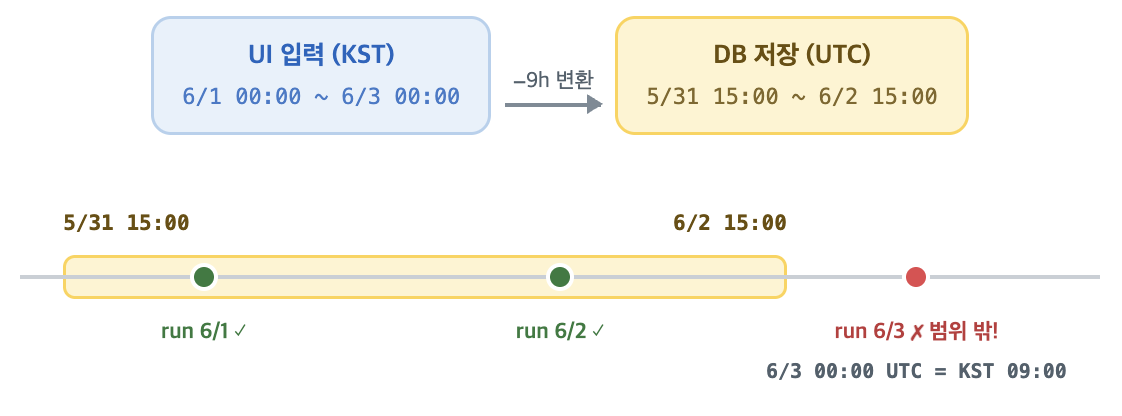
6/1, 6/2 이름표는 범위 안, 6/3 이름표(UTC 6/3 00:00 = KST 09:00)는 범위 밖입니다. 변환 자체는 일관되고 올바릅니다 — 위험한 건 변환이 아니라 두 세계의 "깔끔한 경계"(KST 자정 vs UTC 자정)가 서로 어긋나 있다는 사실입니다. 같은 작업을 CLI로 하면 UTC로 해석되어(id=2) 정확히 맞습니다. 날짜 범위를 입력하는 UI를 만나면 "이 입력은 어느 timezone으로 해석되는가"부터 묻는 습관이 필요합니다.
멱등성 — 재실행을 견디는 설계
Clear든 backfill이든 "재실행"이 일상 도구라는 건, task가 재실행을 견디도록 설계되어 있어야 한다는 뜻입니다. 같은 DAG에 두 가지 설계를 나란히 넣고 실험했습니다.
@task
def append_naive():
    """비멱등: 실행할 때마다 공유 파일에 한 줄 추가 (INSERT와 같은 구조)"""
    ds = get_current_context()["ds"]
    with open(OUT_DIR / "naive.csv", "a") as f:
        f.write(f"{ds},processed\n")

@task
def write_partitioned():
    """멱등: 이름표(ds)가 곧 파일명 → 재실행해도 같은 파일을 덮어쓸 뿐 (UPSERT와 같은 구조)"""
    ds = get_current_context()["ds"]
    (OUT_DIR / f"partitioned_{ds}.csv").write_text(f"{ds},processed\n")
catchup으로 5일치를 돌린 뒤, 6/3 run을 Clear로 1번, backfill로 1번 더 재실행한 최종 결과:
$ cat logs/lab_output/naive.csv
2026-06-01,processed
2026-06-02,processed
2026-06-03,processed     ← 최초 실행
2026-06-04,processed
2026-06-05,processed
2026-06-03,processed     ← Clear 재실행이 또 추가
2026-06-03,processed     ← backfill 재실행이 또 추가

$ cat logs/lab_output/partitioned_2026-06-03.csv
2026-06-03,processed     ← 세 번을 겪고도 한 줄
같은 세 번의 실행을 겪고 naive.csv는 6/3이 세 줄(실제 DB였으면 그날 매출이 세 배), partitioned는 한 줄입니다. task는 매번 "성공"으로 끝나므로 비멱등 설계의 중복은 아무도 모르게 쌓입니다.
원칙은 하나입니다.
같은 이름표(logical_date)로 N번 실행해도, 결과는 1번 실행과 같아야 한다.
파일이면 이름표 기반 경로에 덮어쓰기, DB면 UPSERT 또는 "해당 구간 DELETE 후 INSERT". 이게 보장되면 Clear도 backfill도 무서울 게 없고, 안 되면 재실행이 곧 장애입니다.
KST 스케줄로 바꾸면...
"애초에 스케줄을 KST 자정에 박으면 되지 않나?" — 됩니다. 그리고 국내 비즈니스 데이터를 다루는 팀이라면 그렇게 하는 쪽이 보통 맞습니다.
import pendulum

@dag(
    schedule="@daily",
    start_date=pendulum.datetime(2026, 6, 1, tz="Asia/Seoul"),  # tick이 KST 자정
    ...
)
단, 저장이 KST로 바뀌는 것은 아닙니다. KST 자정 tick은 UTC 15:00으로 변환되어 저장됩니다. 여기서 마지막 함정이 나옵니다 — 파티션 키로 흔히 쓰는 ds는 logical_date의 UTC 날짜입니다.
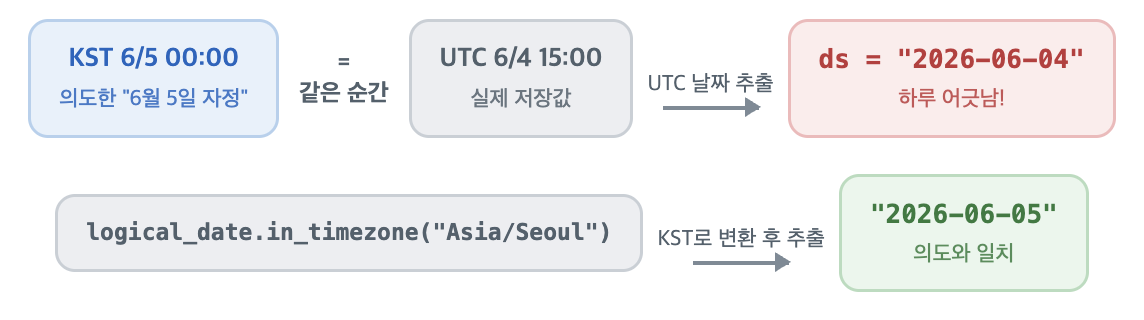
KST 6/5 자정에 도는 run의 logical_date는 UTC 6/4 15:00, 따라서 ds는 "2026-06-04"입니다. 6/5에 돌았는데 이름표 날짜는 6/4인 셈입니다. 멱등성 설계의 핵심이 이름표 기반 파티셔닝인데, 그 이름표 날짜가 직관과 하루 어긋나는 거죠. 해법은 변환을 한 번 거친 KST 기준 키를 쓰는 것:
ctx = get_current_context()
kst_ds = ctx["logical_date"].in_timezone("Asia/Seoul").strftime("%Y-%m-%d")
# 템플릿: {{ logical_date.in_timezone('Asia/Seoul') | ds }}
이 변환을 DAG마다 흩어 놓지 말고 팀 공통 유틸/매크로 하나로 모아 두는 것이, "UTC를 강제하는 시스템(Airflow)"과 "KST로 돌아가는 비즈니스" 사이 경계의 표준 처리법입니다.
마치며 — 체크리스트
Airflow 학습을 마무리하며, 시간에 관해 확인한 것들을 체크리스트로 남깁니다.
-
logical_date는 실행 시각이 아니라 run의 이름표다 — 그리고 이름표를 붙이는 정책(Timetable)이 Airflow 3에서 바뀌었다 - 2.x 기준 자료를 읽을 때는 의미론 차이(interval vs trigger)를 먼저 확인한다
- 구간 ETL은
CronDataIntervalTimetable명시 +data_interval_start/end를 쿼리에 직접 사용 - catchup은 기본 끄고, 과거 채우기는 backfill로 명시적으로
- 속은 전부 UTC, UI만 KST 안경 — 그리고 UI는 입력도 KST로 해석한다 (백필 범위 함정)
- naive datetime을 만들지 않는다. 저장 기준은 하나로 통일하고(UTC든 KST든), 혼재만은 금지
- MySQL
DATETIME은 DB가 아무것도 지켜주지 않는다 - 멱등성: 같은 이름표로 N번 실행 = 1번 실행. 이름표 기반 파티셔닝 + UPSERT/덮어쓰기
- KST 스케줄을 쓰면
ds가 하루 어긋난다 — KST 기준 파티션 키 유틸을 팀 공통으로