

Pod Security Standards, Linux capability, seccomp는 컨테이너 프로세스가 호스트 커널에 요청할 수 있는 범위를 줄입니다. runAsNonRoot를 적용하고 capability를 모두 내려놓더라도, 허용된 시스템 콜을 처리하는 주체는 여전히 호스트 커널 하나입니다.
gVisor는 이 경계를 다른 위치에 둡니다. 컨테이너의 시스템 콜을 호스트 커널에 바로 넘기지 않고, user-space에서 실행되는 별도 프로세스가 먼저 처리합니다. 이 글에서는 gVisor가 줄이려는 공격면과 Sentry·Gofer·systrap의 역할, 이 구조에서 생기는 호환성 및 성능 비용을 정리합니다.
1. 컨테이너 격리가 실제로 나누는 것
컨테이너는 하이퍼바이저 없이 도는 프로세스입니다. 격리는 커널이 제공하는 몇 가지 기능을 조합해서 만듭니다. namespace가 프로세스가 보는 자원 목록을 분리하고, cgroup이 CPU·메모리·I/O 사용량의 상한을 걸고, capability가 root 권한을 세분화해서 일부만 남기고, seccomp-bpf가 호출 가능한 시스템 콜 목록 자체를 제한합니다. AppArmor나 SELinux를 쓴다면 접근 대상별 정책이 하나 더 붙습니다.
컨테이너 안에서 /proc/self/ns를 읽으면 이 분리가 어떤 형태로 표현되는지 볼 수 있습니다.
$ readlink /proc/self/ns/*
cgroup:[4026531835]
ipc:[4026532280]
mnt:[4026532278]
net:[4026532283]
pid:[4026532281]
user:[4026531837]
uts:[4026532279]
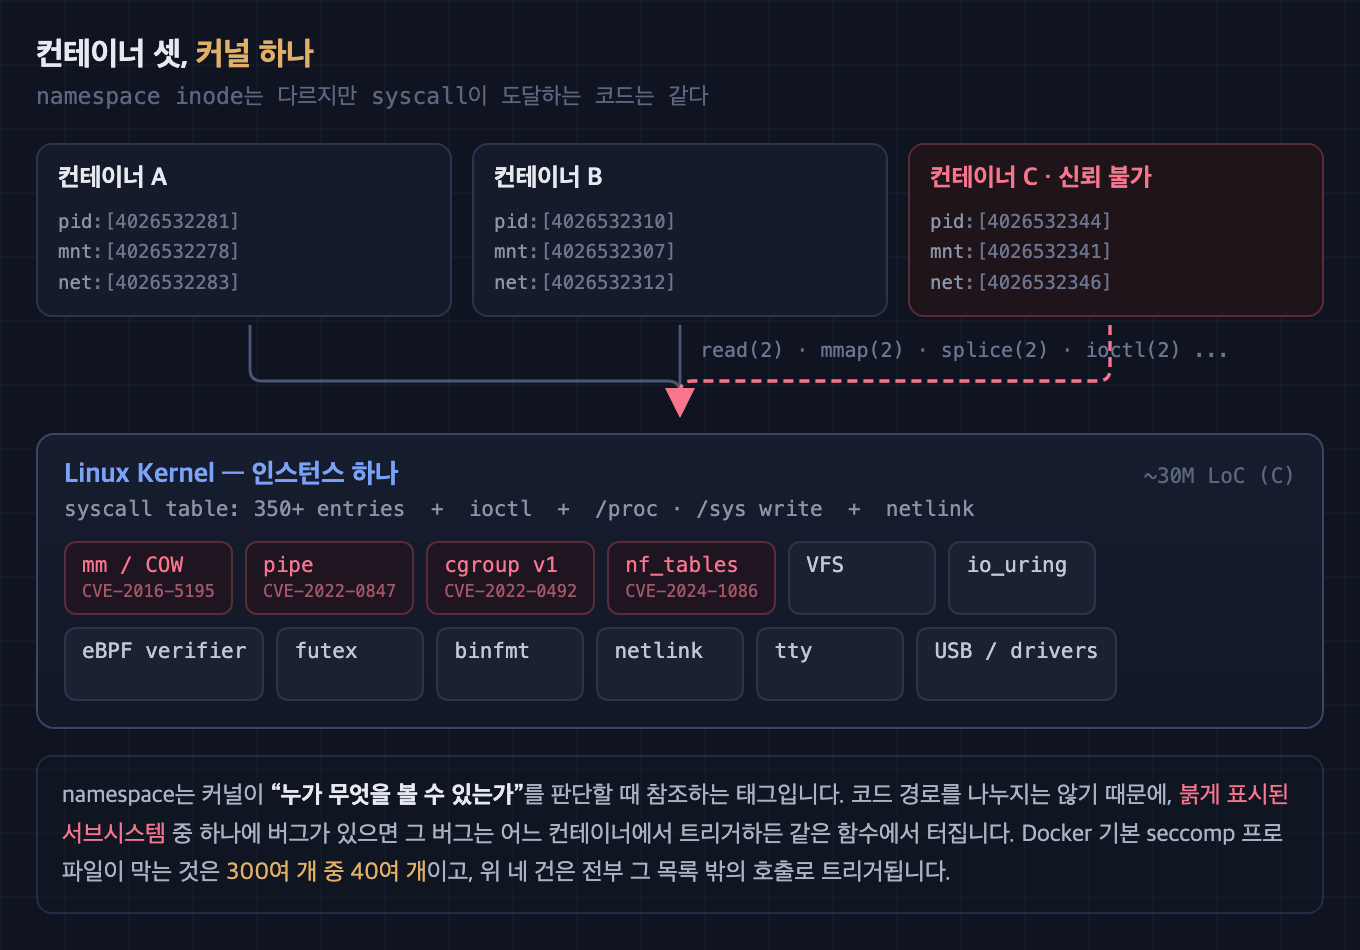
서로 다른 inode 번호는 각 프로세스가 다른 namespace에 속한다는 뜻입니다. 다만 이 namespace를 만들고 관리하는 주체는 모두 같은 호스트 커널입니다. 어느 컨테이너에서 read(2)를 호출하든 결국 호스트 커널의 같은 시스템 콜 구현으로 들어갑니다. namespace는 프로세스에 보이는 자원을 분리하지만 커널의 실행 코드까지 별도로 복제하지는 않습니다. 따라서 허용된 호출 경로에 커널 버그가 있다면 namespace 안에서도 이를 건드릴 수 있습니다.
2. 공격면은 시스템 콜 인터페이스 전체
x86-64 리눅스의 시스템 콜은 350개가 넘습니다. 여기에 ioctl(2) 하나가 드라이버마다 수백 개의 서로 다른 명령을 받고, /proc과 /sys의 파일 쓰기가 사실상 추가 인터페이스로 동작합니다. netlink 소켓, io_uring, eBPF 프로그램 로딩까지 세면 커널에 진입하는 경로는 더 넓어집니다.
이 인터페이스 뒤에는 방대한 커널 코드가 있습니다. 일반적인 컨테이너가 사용하지 않는 기능도 많지만, 접근 가능한 시스템 콜과 옵션은 공격면에 포함됩니다. 컨테이너 탈출이나 권한 상승에 활용된 취약점의 위치도 한 영역에 모여 있지 않습니다.
| CVE | 위치 | 요약 |
|---|---|---|
| CVE-2016-5195 (Dirty COW) | 메모리 관리 (copy-on-write) | race condition으로 read-only 매핑에 쓰기 |
| CVE-2022-0847 (Dirty Pipe) | pipe 버퍼 | 초기화되지 않은 플래그로 임의 파일 덮어쓰기 |
| CVE-2022-0492 | cgroup v1 release_agent |
user namespace 조합으로 호스트에서 명령 실행 |
| CVE-2024-1086 | netfilter nf_tables |
use-after-free를 통한 로컬 권한 상승 |
| CVE-2019-5736 | runc (/proc/self/exe) |
컨테이너에서 호스트의 runc 바이너리 덮어쓰기 |
앞의 네 건은 메모리 관리, 파이프, cgroup, 네트워크 필터처럼 서로 다른 서브시스템에서 발견됐습니다. 마지막 CVE-2019-5736은 커널이 아니라 컨테이너 런타임의 취약점입니다. 컨테이너 경계는 커널뿐 아니라 런타임과 설정까지 함께 살펴야 하는 이유입니다.
seccomp가 줄여주는 만큼
seccomp 프로파일은 이 표면을 좁히는 가장 직접적인 수단입니다. Docker의 기본 프로파일은 kexec_load, bpf, 커널 모듈 관련 호출처럼 일반 컨테이너에 필요하지 않으면서 위험도가 높은 시스템 콜을 막습니다. 그러나 write(2), splice(2), madvise(2)처럼 정상 동작에도 널리 쓰이는 호출까지 일괄 차단하기는 어렵습니다. Dirty Pipe와 Dirty COW는 이런 범용 인터페이스를 통해 트리거됐습니다.
애플리케이션별 allowlist를 만들면 더 줄일 수 있지만 유지 비용이 따라옵니다. 라이브러리나 런타임 버전이 바뀌면 필요한 호출도 달라질 수 있습니다. strace로 얻은 목록에는 실행 당시 거친 경로만 들어가므로, 예외 처리나 드물게 실행되는 기능에서 필요한 호출을 놓치기도 합니다.
같은 노드에 남의 코드가 있을 때
단일 팀이 쓰는 클러스터라면 컨테이너 탈출의 영향이 제한적일 수 있습니다. 신경 쓰이는 쪽은 신뢰할 수 없는 코드를 같은 노드에서 돌리는 환경입니다. 외부 기여자의 PR을 빌드하는 CI 러너, 사용자가 올린 코드를 실행하는 FaaS 플랫폼, 사용자별 노트북 커널을 띄우는 ML 플랫폼, 여러 고객의 워크로드가 같은 노드에 스케줄되는 SaaS 같은 것들입니다.
이런 곳에서는 커널 취약점 하나가 노드 전체와, 그 노드에 마운트된 서비스 어카운트 토큰·시크릿까지 닿습니다.
3. 경계를 다시 그리는 두 가지 방식
대응은 크게 두 갈래로 나뉩니다.
하나는 하드웨어 가상화 경계를 세우는 쪽입니다. Kata Containers, AWS Firecracker가 여기 속합니다. 컨테이너마다 경량 VM을 띄우고 그 안에 별도의 게스트 커널을 올립니다. 게스트 커널에 취약점이 있어도 호스트까지 가려면 VMM이나 CPU 가상화 계층을 한 번 더 뚫어야 합니다. 경계가 명확하고 오래 검증된 방식이지만, 게스트 커널 이미지와 rootfs가 컨테이너마다 붙고 부팅 절차가 생깁니다. Firecracker는 VMM 자체를 최소화해서 부팅 시간을 125ms 아래로 잡았다고 밝히고 있는데, 그래도 프로세스 하나 fork하는 비용과는 층이 다릅니다.
다른 하나는 시스템 콜 ABI를 다른 곳에서 구현하는 쪽입니다. gVisor가 여기 속합니다. 게스트 커널을 올리는 대신 리눅스 시스템 콜 인터페이스를 user-space 프로그램이 직접 구현합니다. 애플리케이션이 open(2)를 부르면 호스트 커널의 sys_open이 아니라 이 프로그램의 코드가 실행됩니다.
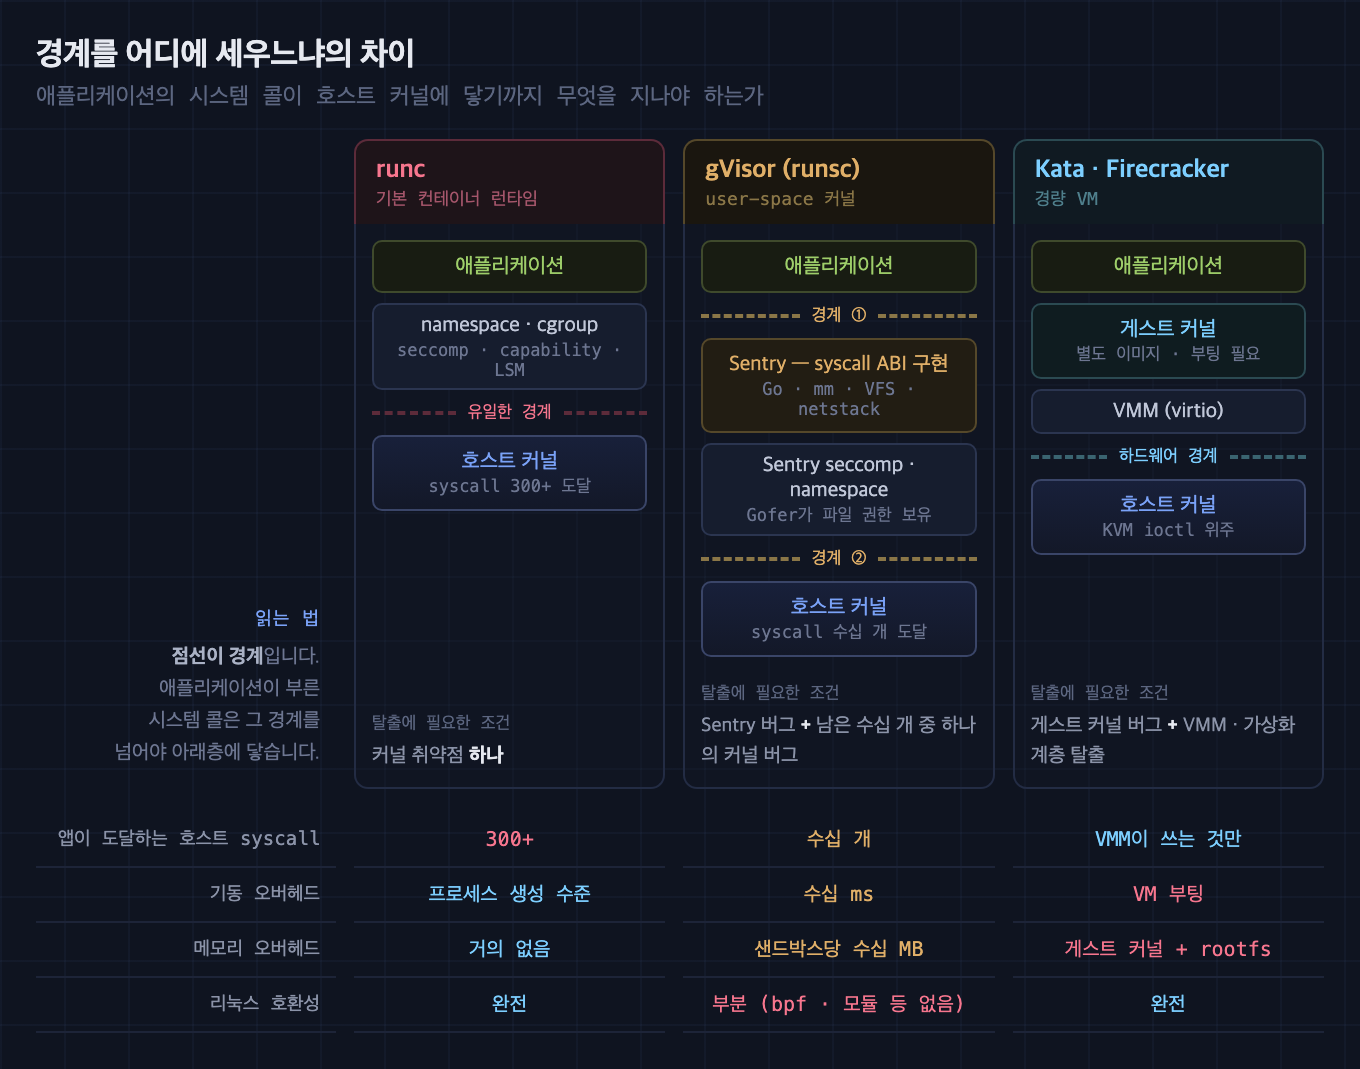
| runc | gVisor (runsc) | Kata / Firecracker | |
|---|---|---|---|
| 격리 경계 | namespace + seccomp | user-space 커널 + seccomp | 하드웨어 가상화 |
| 커널 | 호스트 커널 공유 | Sentry (Go로 구현) | 게스트 커널 (별도 이미지) |
| 앱이 도달하는 호스트 시스템 콜 | 300개 이상 | 수십 개 (Sentry가 쓰는 것만) | VMM이 쓰는 것만 |
| 기동 오버헤드 | 프로세스 생성 수준 | 수십 ms | VM 부팅 |
| 메모리 오버헤드 | 거의 없음 | 샌드박스당 수십 MB | 게스트 커널 + rootfs |
| 리눅스 호환성 | 완전 | 부분 | 완전 |
gVisor에서 달라지는 지점은 애플리케이션과 호스트 커널 사이의 인터페이스입니다. 애플리케이션의 시스템 콜은 Sentry가 처리하고, 호스트 커널에는 Sentry가 동작하는 데 필요한 제한된 호출만 전달됩니다.
4. Sentry와 Gofer
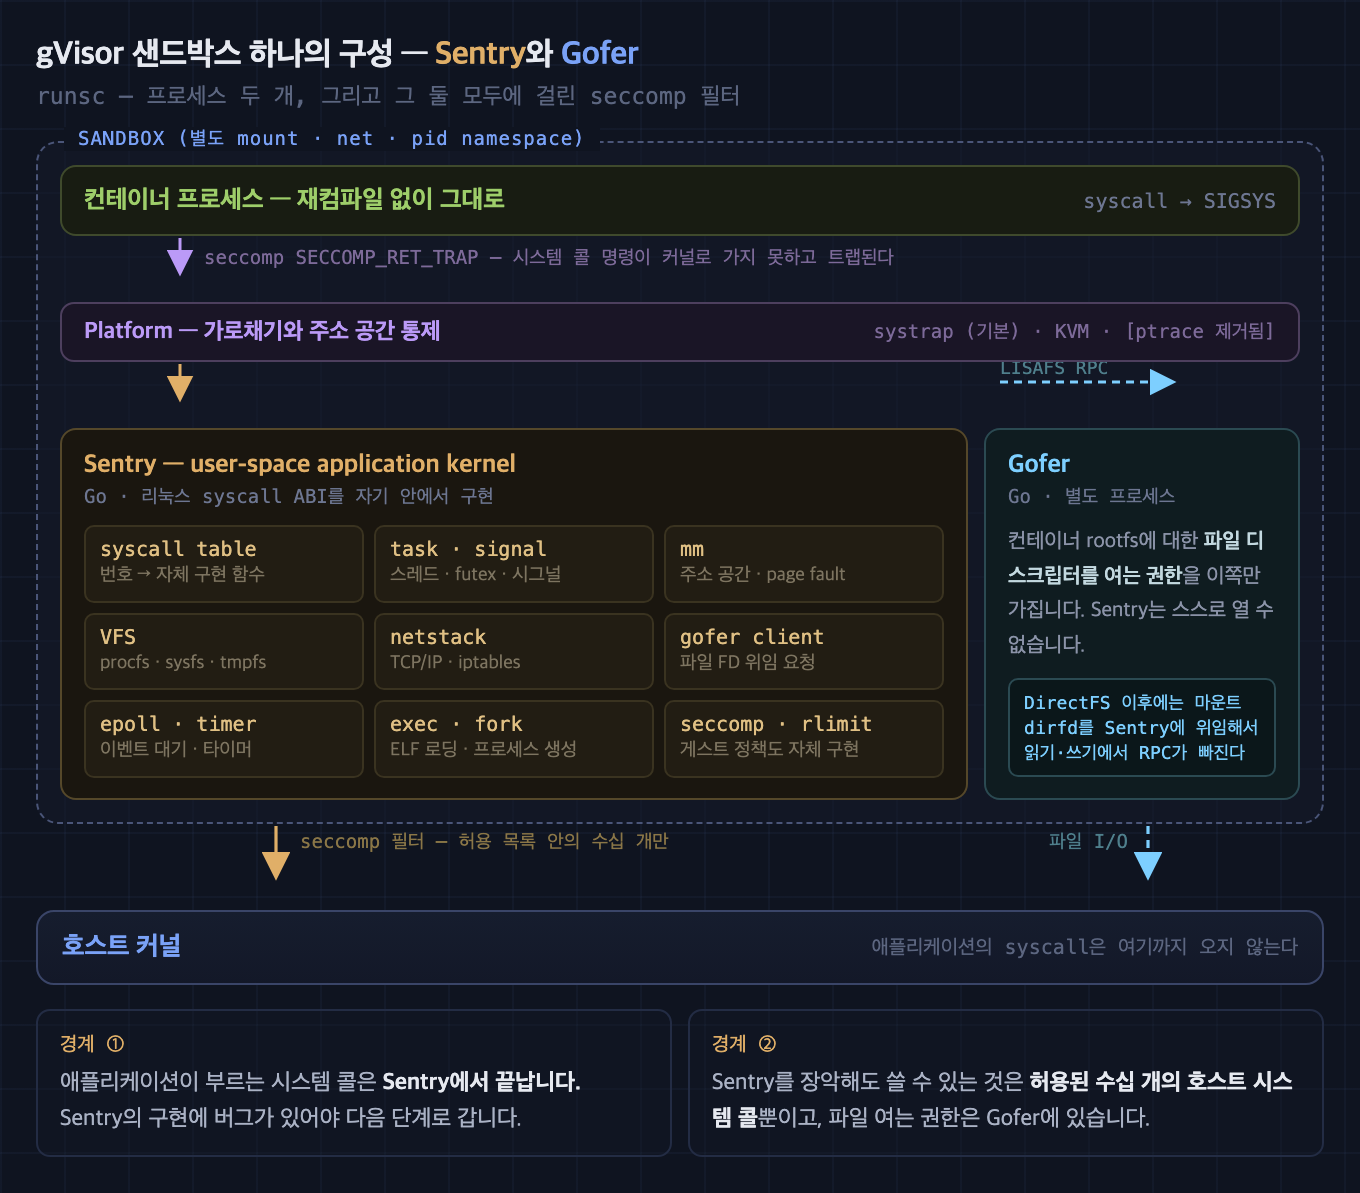
gVisor는 OCI 런타임 runsc로 패키징되어 있고, 샌드박스 하나는 프로세스 두 개로 구성됩니다.
Sentry
Go로 작성된 application kernel로, 리눅스 시스템 콜 인터페이스를 user-space에 구현합니다. 프로세스와 스레드 관리(task, 스케줄링, 시그널, futex), 메모리 관리(주소 공간, mmap, page fault 처리), VFS 계층과 여러 파일시스템(procfs, sysfs, tmpfs, overlay), TCP/IP 스택이 여기에 들어갑니다.
애플리케이션이 getpid(2)를 부르면 Sentry의 task 구조체에서 값을 읽어 반환합니다. 호스트 커널 쪽에서는 이 호출 자체가 관측되지 않습니다. mmap(2)은 Sentry의 메모리 관리자가 자기 주소 공간 안에서 처리합니다.
Gofer
Sentry는 컨테이너 rootfs에 직접 접근하지 않습니다. 파일 관련 요청은 별도 프로세스인 Gofer에게 RPC로 넘깁니다. 초기 구현은 9P2000.L을 썼고, 성능 문제로 LISAFS라는 전용 프로토콜로 교체됐습니다.
프로세스를 나눈 이유는 권한 분리입니다. Sentry가 공격당한 상황에서도 파일시스템 접근 권한이 곧바로 따라가지 않도록 역할을 나눴습니다. 파일을 여는 권한은 Gofer 쪽에 있고, Gofer에는 Sentry처럼 복잡한 시스템 콜 처리 로직이 없습니다.
Platform
Platform은 Sentry가 애플리케이션의 시스템 콜을 가로채고 주소 공간을 통제하는 방법을 추상화한 계층입니다. 호스트 환경과 실행 조건에 따라 구현을 선택할 수 있습니다.
| 플랫폼 | 방식 | 특징 |
|---|---|---|
| ptrace | PTRACE_SYSEMU로 시스템 콜마다 정지 |
어디서나 동작하지만 호출당 컨텍스트 스위치가 여러 번. 현재는 제거됨 |
| KVM | Sentry가 하이퍼바이저 역할, 애플리케이션은 게스트 ring 3에서 실행 | 시스템 콜 트랩이 빠름. /dev/kvm 필요, 중첩 가상화 환경에서 제약 |
| systrap | seccomp SECCOMP_RET_TRAP + 공유 메모리 큐 |
현재 기본값. /dev/kvm 없이 ptrace보다 빠름 |
5. 시스템 콜 하나가 지나가는 길
systrap 플랫폼에서 애플리케이션의 시스템 콜이 처리되는 순서입니다.
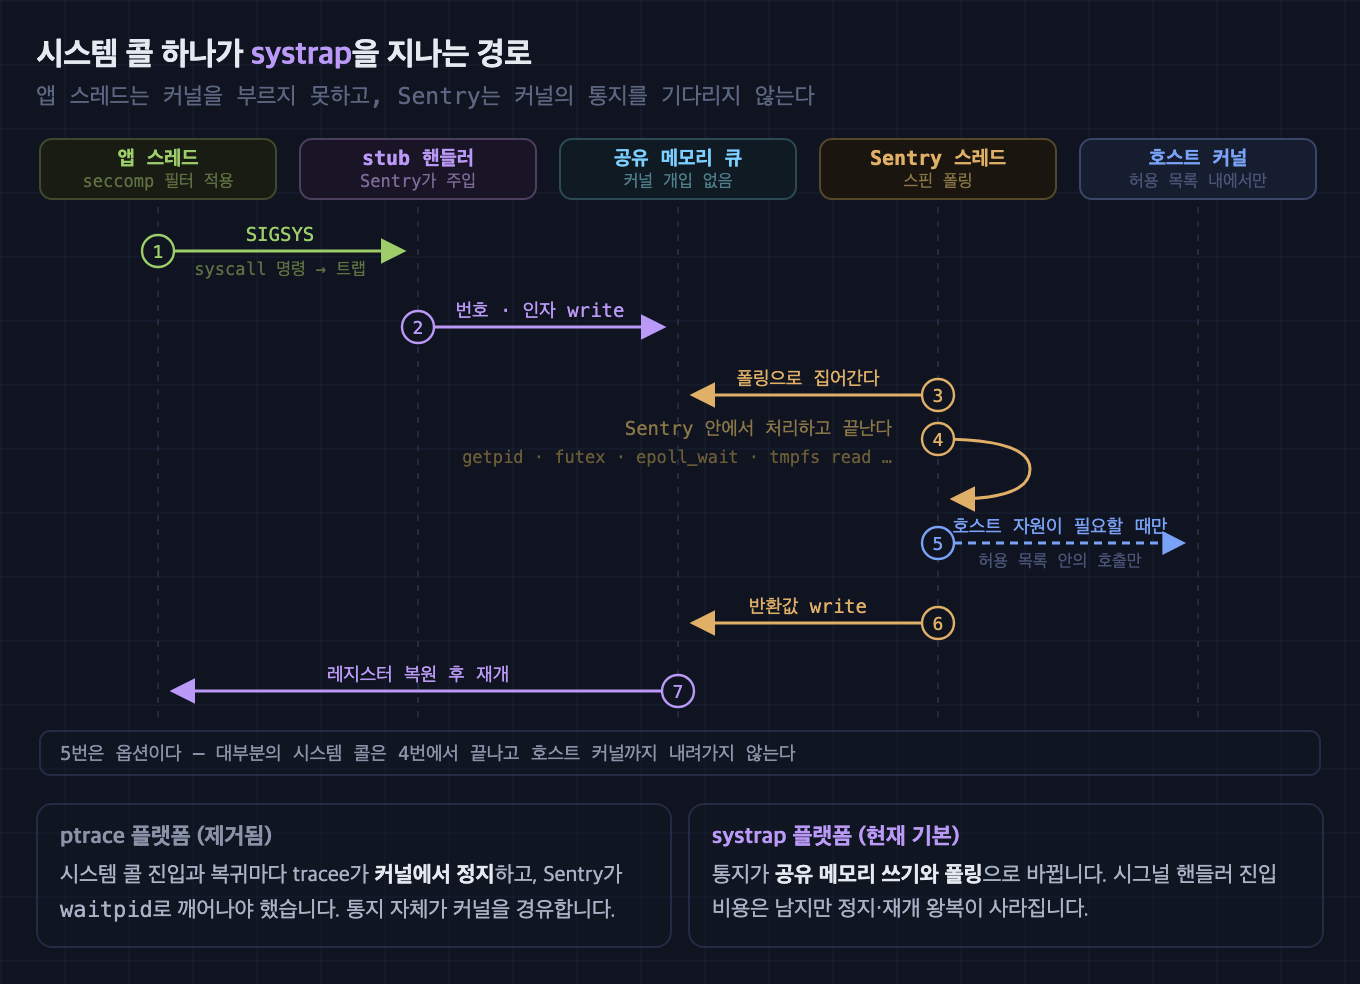
애플리케이션 프로세스에는 seccomp 필터가 걸려 있어서 시스템 콜 명령이 곧바로 SIGSYS로 바뀝니다. Sentry가 미리 주입해 둔 stub 코드가 이 시그널을 받아 요청 내용을 공유 메모리에 쓰고, Sentry 쪽 스레드가 그 영역을 폴링하다가 집어갑니다.
ptrace 방식과 비교하면 차이가 뚜렷합니다. ptrace는 시스템 콜 진입과 복귀 때마다 tracee가 정지하고 tracer가 waitpid로 깨어나는 왕복이 필요했습니다. systrap은 그 왕복을 공유 메모리 쓰기와 폴링으로 대체합니다. 시그널 핸들러 진입 비용은 남지만, 통지 단계에서 커널을 경유하지 않게 됩니다.
그림의 5번은 호스트 자원이 필요할 때만 발생합니다. getpid, gettid처럼 Sentry 내부 상태만으로 응답할 수 있는 호출은 그 안에서 끝납니다. 호스트 시스템 콜이 필요한 경우에도 Sentry에 적용된 seccomp 필터가 허용하는 범위 안에서만 호출합니다.
6. 파일 접근이 Gofer를 거치는 이유, 그리고 DirectFS
초기 gVisor는 파일 접근을 전부 Gofer RPC로 처리했습니다. read(2) 한 번마다 프로세스 간 통신이 끼면서 파일 I/O가 무거운 워크로드에서 병목이 됐습니다.
DirectFS는 이 경로를 줄인 최적화입니다. Gofer가 마운트 지점의 디렉토리 파일 디스크립터를 Sentry에게 넘겨주고, 이후 Sentry는 openat2(2)에 RESOLVE_BENEATH 플래그를 붙여서 그 FD 아래로만 경로를 해석하도록 커널에 강제합니다. ..이나 심볼릭 링크로 밖으로 나가려는 시도는 커널이 거부합니다.
# 개념적인 형태
openat2(mount_root_fd, "etc/nginx/nginx.conf", &how, sizeof(how))
  how.resolve = RESOLVE_BENEATH | RESOLVE_NO_MAGICLINKS
이 방식은 경로 이탈 방지를 openat2(2)의 제약에 맡기면서 Gofer RPC 횟수를 줄입니다. Gofer는 초기 설정과 일부 연산을 담당하고, 일반적인 읽기·쓰기 hot path에서는 빠집니다.
7. netstack
Sentry에는 Go로 작성된 TCP/IP 스택이 들어 있습니다. 애플리케이션이 만드는 소켓은 이 스택에서 관리하며, TCP 상태 머신, 재전송, 혼잡 제어가 모두 user-space에서 동작합니다. iptables 규칙도 netstack이 자체적으로 해석합니다.
덕분에 호스트의 네트워크 스택에 도달하는 경로가 크게 줄어듭니다. 2장에서 언급한 CVE-2024-1086은 nf_tables의 use-after-free인데, gVisor 위의 컨테이너가 iptables를 만져도 그 요청은 netstack에서 처리되고 호스트 nf_tables 코드는 실행되지 않습니다.
대가는 성능입니다. 커널 스택이 수십 년간 최적화한 경로를 Go 코드가 다시 구현한 것이므로, 처리량이 많은 워크로드에서는 차이가 납니다. gVisor는 --network=host로 호스트 네트워크를 그대로 쓰는 선택지도 제공하는데, 이 경우 네트워크 쪽 격리 이득은 포기하게 됩니다.
8. 격리 경계를 보강하는 방법
경계를 두 겹으로 둔다
Sentry는 애플리케이션의 시스템 콜을 받아 처리하지만, Sentry 하나만을 격리 경계로 삼지는 않습니다. Sentry가 공격당한 경우를 가정한 제한이 바깥에 한 번 더 적용됩니다.
Sentry 프로세스에는 자체 seccomp 필터가 걸려 있습니다. 시스템 콜 인터페이스를 구현하는 프로그램이 정작 자기가 쓸 수 있는 호스트 시스템 콜은 수십 개 수준으로 묶여 있습니다. 여기에 Sentry는 별도의 mount·network·PID namespace 안에서 돌고, 파일시스템 접근 권한은 Gofer가 갖고 있습니다.
공격자 입장에서 나열하면 이렇게 됩니다.
- Sentry의 시스템 콜 구현에서 메모리 손상 버그를 찾아 코드 실행을 얻는다
- 그 상태에서 쓸 수 있는 것은 Sentry에 허용된 수십 개의 호스트 시스템 콜뿐이다
- 파일시스템 접근은 없고, 네트워크는 자기 프로세스 안의 Go 코드다
- 여기서 다시 호스트 커널 취약점을 찾아야 한다
Sentry의 취약점으로 코드 실행을 얻는 것만으로는 호스트 접근이 끝나지 않습니다. 제한된 호스트 시스템 콜을 이용해 별도의 탈출 경로까지 찾아야 합니다.
Go로 쓴 이유
커널 취약점에는 use-after-free, buffer overflow, 초기화되지 않은 메모리 사용처럼 memory safety와 관련된 문제가 반복해서 등장합니다.
Sentry를 Go로 작성하면 이 범주의 결함을 줄이는 데 도움이 됩니다. 플랫폼 계층과 일부 저수준 코드에는 어셈블리와 unsafe 패키지가 들어가지만, 시스템 콜 구현부 대부분에는 런타임의 메모리 관리와 bounds check가 적용됩니다. 논리 오류나 권한 검사 누락처럼 언어가 막아주지 못하는 취약점은 여전히 남습니다.
VM을 흉내내지 않는다
gVisor에는 게스트 커널 이미지, 가상 디바이스 모델, virtio 드라이버가 없습니다. VM처럼 게스트 OS를 부팅하지 않고, 호스트에서는 runsc-sandbox 프로세스로 관찰됩니다. 하드웨어 가상화 대신 시스템 콜을 처리하는 위치를 user-space로 옮기는 접근입니다.
9. 포기하는 것
호환성
Sentry는 리눅스 시스템 콜의 대부분을 구현하지만 전부는 아닙니다. 빠진 것들은 대체로 "샌드박스 안에서 제공할 이유가 없다"고 판단된 기능입니다.
- eBPF 프로그램 로딩:
bpf(2)가 없습니다. 컨테이너 안에서 eBPF를 쓰는 관측 도구나 Cilium 계열 에이전트는 동작하지 않습니다. - 커널 모듈:
init_module계열 전부 없습니다. perf_event_open: 프로파일러가 하드웨어 카운터를 못 씁니다.- 임의 파일시스템 mount: 지원되는 타입이 제한적입니다.
- 일부
ioctl명령: 특히 장치 드라이버 관련. /proc,/sys의 일부 항목: Sentry가 구현한 것만 존재합니다.
GPU는 따로 처리됩니다. nvproxy가 NVIDIA 드라이버의 ioctl을 검증해서 호스트로 넘기는 방식으로 지원되는데, 이 경로는 드라이버 인터페이스가 그대로 노출되는 구간이라 다른 부분만큼 표면이 좁지는 않습니다.
시스템 데몬이나 저수준 도구가 아닌 일반적인 애플리케이션 서버, 배치 작업, 웹 워크로드는 대체로 그대로 동작합니다. 호환성 문제는 사이드카나 노드 에이전트에서 먼저 나타날 가능성이 높습니다.
성능
성능 특성은 워크로드에 따라 크게 갈립니다. CPU 바운드 연산은 차이가 거의 없습니다. 시스템 콜이 안 일어나면 Sentry가 개입할 일이 없기 때문입니다. 반대로 짧은 read/write를 반복하는 코드처럼 시스템 콜이 잦은 워크로드는 호출마다 트랩과 큐 왕복이 붙어 가장 불리합니다. 네트워크 처리량은 netstack이 커널 스택보다 느리고, 파일 I/O는 DirectFS 이후 많이 개선됐지만 여전히 오버헤드가 있습니다. 메모리는 샌드박스당 수십 MB가 추가로 드는데, VM 방식보다는 훨씬 적습니다.
사이드 채널
Spectre·Meltdown 계열의 CPU 사이드 채널에 대해서는 gVisor가 VM보다 유리하다고 보기 어렵습니다. 애플리케이션과 Sentry가 같은 CPU 코어를 공유하고, 하드웨어 수준의 격리 경계가 따로 없기 때문입니다. gVisor 문서도 이 부분은 별도의 완화 수단에 의존한다고 밝히고 있습니다. 이 위협 모델이 중요하다면 하드웨어 가상화 쪽을 봐야 합니다.
10. Kubernetes에 붙이기
노드에 runsc를 설치하고 containerd에 런타임 핸들러를 등록합니다.
# /etc/containerd/config.toml
[plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runsc]
  runtime_type = "io.containerd.runsc.v1"
클러스터에 RuntimeClass를 만듭니다.
apiVersion: node.k8s.io/v1
kind: RuntimeClass
metadata:
  name: gvisor
handler: runsc
Pod에서 지정합니다.
apiVersion: v1
kind: Pod
metadata:
  name: untrusted-job
spec:
  runtimeClassName: gvisor
  containers:
    - name: app
      image: python:3.12-slim
      command: ["python", "-c", "import os; print(os.uname())"]
기동한 뒤 커널 정보를 찍어보면 gVisor 위에 있다는 게 드러납니다.
$ kubectl exec untrusted-job -- uname -a
Linux untrusted-job 4.4.0 #1 SMP ... x86_64 GNU/Linux
Sentry가 보고하는 커널 버전은 호스트의 실제 버전과 무관합니다. 애플리케이션이 커널 버전으로 기능 분기를 한다면 여기서 예상과 다르게 동작할 수 있습니다.
GKE는 이 구성을 GKE Sandbox라는 이름으로 노드 풀 옵션으로 제공하고, Cloud Run과 App Engine도 gVisor 위에서 실행됩니다. 프로덕션 검증은 충분히 된 편입니다.
11. 어디에 쓸 만한가
모든 Pod를 gVisor로 옮기는 방식은 비용 대비 효과가 크지 않을 수 있습니다. 신뢰할 수 있는 코드만 실행하는 클러스터라면 호환성 확인과 성능 저하, 운영 복잡도가 추가되는 만큼 위협 모델부터 확인할 필요가 있습니다.
외부에서 들어온 코드(CI, 플러그인, 사용자 제출 코드)를 실행하거나 여러 고객의 워크로드를 같은 노드에 배치한다면 이야기가 달라집니다. 이 경우에는 추가 격리 경계가 주는 이점이 분명합니다. 다만 시스템 콜 빈도가 높은지, eBPF·커널 모듈·특수 디바이스에 의존하는지를 먼저 확인해야 합니다.
실무적으로는 RuntimeClass 단위로 붙일 수 있다는 점이 중요합니다. 클러스터 전체를 바꾸지 않고 신뢰 수준이 낮은 네임스페이스만 runtimeClassName: gvisor로 돌리는 부분 적용이 가능합니다. 노드 풀을 나누고 taint/toleration으로 스케줄링을 분리하면 성능 특성이 다른 두 종류의 노드를 함께 운영할 수 있습니다.
NOTEgVisor를 사용해도 컨테이너 보안 설정을 생략할 수는 없습니다.
runAsNonRoot,capabilities.drop: [ALL], read-only rootfs는 여전히 유효하며, gVisor는 이 정책을 Sentry 안에서 적용합니다.
TL;DR
- namespace, cgroup, capability, seccomp는 컨테이너의 권한과 자원 범위를 제한하지만 호스트 커널 자체를 분리하지는 않습니다.
- gVisor는 리눅스 시스템 콜 ABI를 Go로 작성된 Sentry에서 처리해 애플리케이션이 호스트 커널에 직접 닿는 경로를 줄입니다.
- 파일 접근은 Gofer와 DirectFS가, 네트워크는 netstack이 담당합니다. Sentry 바깥에도 seccomp와 namespace를 적용해 격리 경계를 한 번 더 둡니다.
- 이 구조에는 시스템 콜과 파일·네트워크 I/O 오버헤드가 있으며, eBPF나 일부
ioctl, 특수 장치처럼 지원하지 않는 인터페이스도 있습니다. - Kubernetes에서는 RuntimeClass로 일부 워크로드에만 적용할 수 있습니다. 외부 코드나 서로 신뢰하지 않는 tenant를 실행하는 환경에서 우선 검토할 만합니다.