
Pod 하드닝의 출발점은 보통 네임스페이스에 Pod Security Standards를 강제하는 일입니다.
kubectl label namespace capability-demo \
  pod-security.kubernetes.io/enforce=restricted \
  pod-security.kubernetes.io/enforce-version=latest
라벨 한 줄이지만, 이미 그 네임스페이스에서 돌고 있던 워크로드에는 파급이 큽니다. 저는 이 라벨을 걸고 기존 nginx Deployment를 그대로 다시 올렸다가 서로 다른 이유로 네 번 연속 실패했습니다. 원인은 admission 거부, 파일 권한, 그리고 Linux capability set과 커널의 execve 전이 규칙까지 네 층에 걸쳐 있었습니다.
각 실패마다 필요한 개념(runAsUser/runAsGroup/fsGroup, UID/GID 기반 파일 권한, capability의 다섯 가지 set)을 등장한 순서대로 정리합니다.
1. 라벨을 걸고 기존 Deployment를 올리다
restricted는 Pod Security Standards 세 프로파일(privileged, baseline, restricted) 중 가장 엄격한 단계입니다. 컨테이너가 root로 실행되는 것을 막고, capability를 전부 제거하며, privilege escalation과 seccomp 설정까지 함께 요구합니다.
컨테이너 내부의 root는 호스트의 root와 완전히 같지는 않지만, 컨테이너 탈출 취약점이나 잘못된 마운트 설정과 겹치면 위험한 권한 모델이 됩니다. restricted는 이 위험을 원천적으로 차단하기 위한 프로파일입니다.
문제는 대부분의 공개 이미지가 이 전제와 반대로 만들어져 있다는 점입니다. securityContext가 하나도 없는 평범한 Deployment를 그대로 올려보면 이렇게 됩니다.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-restricted
  namespace: capability-demo
spec:
  replicas: 1
  selector:
    matchLabels:
      app: nginx-restricted
  template:
    metadata:
      labels:
        app: nginx-restricted
    spec:
      containers:
        - name: app
          image: nginx:1.25-alpine
          ports:
            - containerPort: 80
# kubectl apply -f nginx-restricted.yaml
Warning: would violate PodSecurity "restricted:latest": allowPrivilegeEscalation != false
(container "app" must set securityContext.allowPrivilegeEscalation=false), unrestricted
capabilities (container "app" must set securityContext.capabilities.drop=["ALL"]),
runAsNonRoot != true (pod or container "app" must set securityContext.runAsNonRoot=true),
seccompProfile (pod or container "app" must set securityContext.seccompProfile.type to
"RuntimeDefault" or "Localhost")
deployment.apps/nginx-restricted created
Deployment는 생성됐지만 Pod는 하나도 없습니다.
# kubectl get deployment,pods -n capability-demo
NAME                               READY   UP-TO-DATE   AVAILABLE   AGE
deployment.apps/nginx-restricted   0/1     0            0           5s
kubectl apply가 뱉은 메시지는 경고일 뿐이고, Deployment 자체는 정상 생성됩니다. 실제 거부는 ReplicaSet이 Pod를 만들려는 순간에 일어나기 때문에, 원인은 Pod 로그가 아니라 이벤트에 남습니다.
# kubectl get events -n capability-demo --field-selector reason=FailedCreate \
    -o jsonpath='{.items[0].message}'
Error creating: pods "nginx-restricted-74c49f6d68-j87vz" is forbidden: violates
PodSecurity "restricted:latest": allowPrivilegeEscalation != false (...),
unrestricted capabilities (...), runAsNonRoot != true (...), seccompProfile (...)
메시지에 나열된 네 항목이 그대로 채워야 할 네 개의 필드입니다.
| 위반 항목 | 요구되는 설정 |
|---|---|
allowPrivilegeEscalation != false |
컨테이너에 allowPrivilegeEscalation: false |
unrestricted capabilities |
컨테이너에 capabilities.drop: ["ALL"] |
runAsNonRoot != true |
Pod 또는 컨테이너에 runAsNonRoot: true |
seccompProfile |
seccompProfile.type: RuntimeDefault |
2. runAsNonRoot만으로는 기동되지 않습니다
네 항목을 그대로 채워 다시 적용했습니다.
spec:
  securityContext:
    runAsNonRoot: true
  containers:
    - name: app
      image: nginx:1.25-alpine
      securityContext:
        allowPrivilegeEscalation: false
        seccompProfile:
          type: RuntimeDefault
        capabilities:
          drop: ["ALL"]
이번에는 admission을 통과해서 Pod가 생성됩니다. 그런데 컨테이너가 시작되지 못합니다.
# kubectl get pods -n capability-demo
NAME                               READY   STATUS                       RESTARTS   AGE
nginx-restricted-5f957f69c-kd96p   0/1     CreateContainerConfigError   0          8s
CreateContainerConfigError | container has runAsNonRoot and image will run as root
runAsNonRoot: true는 "이 컨테이너는 UID 0으로 실행되면 안 된다"는 제약 선언이지, 실행 UID를 지정하는 설정이 아닙니다. nginx 이미지에는 별도 USER 지시가 없어 기본 실행 UID가 0이고, kubelet은 "root로 실행되지 말라"는 요구와 "이 이미지는 root로 실행된다"는 사실이 충돌한다고 판단해 컨테이너 생성 자체를 거부합니다.
그래서 UID를 명시해야 합니다.
securityContext:
  runAsNonRoot: true
  runAsUser: 1000
  runAsGroup: 1000
3. 캐시 디렉토리에 mkdir을 못 합니다
UID를 명시하자 컨테이너는 시작됩니다. 대신 곧바로 죽습니다.
# kubectl logs -n capability-demo nginx-restricted-696845b447-x8mg6
...
nginx: [warn] the "user" directive makes sense only if the master process runs with
super-user privileges, ignored in /etc/nginx/nginx.conf:2
09:26:13 [emerg] 1#1: mkdir() "/var/cache/nginx/client_temp" failed
(13: Permission denied)
nginx: [emerg] mkdir() "/var/cache/nginx/client_temp" failed (13: Permission denied)
프로세스는 이제 UID 1000으로 실행되는데, 이미지 안의 /var/cache/nginx는 이미지 빌드 시점에 root 소유로 만들어져 있습니다. 프로세스의 UID와 디렉토리 소유자 UID가 어긋나면서 쓰기가 막힌 것입니다.
Linux 파일 권한이 결정되는 방식

지금 상황을 그대로 대입해 보겠습니다. 프로세스는 runAsUser: 1000, runAsGroup: 1000으로 실행되고 있고, 문제가 된 디렉토리는 이미지 빌드 시점에 만들어져 root 소유입니다.
# 프로세스              # 디렉토리
uid=1000 gid=1000       drwxr-xr-x  root(0)  root(0)  /var/cache/nginx
커널은 위에서부터 순서대로 판단합니다.
- 프로세스 UID가 owner와 같은가? →
1000 ≠ 0이므로 owner 권한(rwx) 해당 없음 - 프로세스 GID(또는 supplementary group)가 group과 같은가? →
1000 ≠ 0이므로 group 권한(r-x) 해당 없음 - 둘 다 아니므로 other 권한 적용 →
r-x, 쓰기 비트 없음
읽기와 실행은 되지만 쓰기가 없어서 mkdir이 막힙니다. 조금 전 로그에 찍힌 실패가 이 경로로 결정된 것입니다.
runAsUser와 runAsGroup의 역할
runAsUser는 컨테이너 프로세스의 UID를, runAsGroup은 기본 GID를 지정합니다.
$ id
uid=1000 gid=1000
두 설정은 프로세스의 신분만 바꾸고, 파일이나 디렉토리의 소유권은 그대로 둡니다. 그래서 위 판단 과정에서 디렉토리 쪽 값은 계속 root(0)으로 남아 있습니다.
fsGroup은 volume 쪽을 맞춘다
프로세스가 아니라 volume 쪽을 움직이는 설정이 fsGroup입니다.
securityContext:
  fsGroup: 1000
Pod가 사용하는 volume의 그룹 소유권을 지정한 GID로 맞추고, 동시에 프로세스의 supplementary group에도 그 GID를 추가합니다. 마운트된 volume은 대략 이런 형태가 됩니다.
# 적용 전
drwxr-xr-x  root  root  cache/

# fsGroup: 1000 적용 후
drwxrwsr-x  root  1000  cache/
owner(UID)는 root 그대로 두고 group(GID)만 바뀝니다. root:1000이 되는 것이지 1000:1000이 되는 게 아닙니다. 그룹에 쓰기 비트가 붙고 프로세스도 그 그룹에 속하게 되므로, 이제 2번 단계에서 group 권한으로 통과합니다. 디렉토리에 붙는 s는 setgid 비트로, 하위에 새로 만들어지는 파일도 같은 그룹을 상속하게 합니다.
/var/cache/nginx는 이미지에 이미 존재하는 경로라서 fsGroup만으로는 소유권이 바뀌지 않습니다. 그래서 이 경로에 emptyDir을 마운트해 새 volume으로 덮고, 거기에 fsGroup을 적용했습니다.
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 1000
    runAsGroup: 1000
    fsGroup: 1000
  containers:
    - name: app
      volumeMounts:
        - name: cache
          mountPath: /var/cache/nginx
  volumes:
    - name: cache
      emptyDir: {}
runAsGroup과 fsGroup을 다른 값으로 두는 경우
지금까지는 runAsUser, runAsGroup, fsGroup을 모두 1000으로 맞췄기 때문에 두 설정의 차이가 드러나지 않았습니다. runAsGroup은 프로세스의 기본 그룹이고 fsGroup은 volume 접근용 그룹이라 목적이 다른데, 아래처럼 두 값을 다르게 주면 그 차이를 확인할 수 있습니다.
아래는 지금까지의 실습과는 무관한 별도 시나리오이고, 각 값의 역할을 구분하기 위해 일부러 다른 숫자를 씁니다. 여러 서비스가 같은 PVC를 공유하는 상황입니다.
             PVC
              |
        GID=3000
              |
    +---------+---------+
    |                   |
 backend             worker
UID=1000             UID=2000
GID=2000             GID=4000
backend는 runAsGroup: 2000, worker는 runAsGroup: 4000으로 각자의 내부 파일 권한 체계를 유지합니다. 여기에 두 Pod 모두 fsGroup: 3000을 주면, 프로세스의 supplementary group에 3000이 추가되어 groups=2000,3000 / groups=4000,3000이 됩니다. 기본 그룹은 서로 다르지만 둘 다 3000 그룹에 속하므로 공유 볼륨에는 양쪽 다 접근할 수 있습니다.
fsGroup 없이 runAsGroup만으로 해결하려면 두 서비스가 같은 GID를 써야 하고, 그러면 서비스별 권한 구분이 사라집니다. fsGroup을 쓰면 이 구분을 유지하면서 공유 볼륨 접근권만 따로 부여할 수 있습니다.
WARNING
fsGroup은 컨테이너 내부에서만 보이는 가상 변경이 아닙니다. volume은 실제 파일시스템을 마운트한 것이라,hostPath를 쓰면 노드 파일시스템의 그룹 소유권이 실제로 바뀌고 NFS라면 NFS 서버 쪽 메타데이터까지 영향이 갑니다. 공유 스토리지에 적용하기 전에 같은 경로를 보고 있는 다른 워크로드가 없는지 확인하는 편이 안전합니다.
4. bind() to 0.0.0.0:80
캐시 문제를 해결하니 에러가 또 바뀝니다.
# kubectl logs -n capability-demo nginx-restricted-6f884ff9c-sv6lb
09:26:55 [emerg] 1#1: bind() to 0.0.0.0:80 failed (13: Permission denied)
nginx: [emerg] bind() to 0.0.0.0:80 failed (13: Permission denied)
Linux는 1024번 미만 포트(privileged port)를 여는 데 특별한 권한을 요구합니다. 예전에는 root만 가능했고, 이후 이 권한이 CAP_NET_BIND_SERVICE라는 capability로 분리됐습니다. runAsUser: 1000으로 root를 벗어난 데다 capabilities.drop: ["ALL"]까지 걸려 있으니, 80번 포트를 열 근거가 아무것도 남지 않은 상태입니다.
restricted 프로파일은 drop: ["ALL"]을 요구하면서도 NET_BIND_SERVICE 하나만은 add를 허용합니다. 정확히 이 상황을 위한 예외로 읽히고, 실제로 검색해도 대부분 이 답이 나옵니다.
securityContext:
  capabilities:
    drop: ["ALL"]
    add: ["NET_BIND_SERVICE"]
5. add를 했는데도 에러가 그대로입니다
위 설정을 넣고 다시 배포했습니다.
# kubectl get pods -n capability-demo
NAME                               READY   STATUS   RESTARTS      AGE
nginx-restricted-8fb9cfbfc-x2twh   0/1     Error    2 (16s ago)   16s
09:27:40 [emerg] 1#1: bind() to 0.0.0.0:80 failed (13: Permission denied)
nginx: [emerg] bind() to 0.0.0.0:80 failed (13: Permission denied)
에러 메시지가 한 글자도 달라지지 않았습니다. restricted가 요구하는 필드를 모두 채웠고 admission도 통과했는데, 정작 그 프로파일이 유일하게 허용한 capability가 런타임에서 아무 효과가 없습니다. 여기서부터는 매니페스트를 더 들여다봐도 답이 나오지 않아 커널 쪽으로 내려갔습니다.
6. capability는 하나가 아니라 다섯 개의 set이다
Linux는 프로세스의 capability를 단일 목록이 아니라 다섯 개의 서로 다른 set으로 관리합니다.
| Set | 의미 |
|---|---|
| Bounding | 이 프로세스가 앞으로 가질 수 있는 capability의 상한선 |
| Inheritable | execve()로 자식에게 물려줄 수 있는 capability |
| Permitted | 현재 프로세스가 활성화할 수 있는 capability |
| Effective | 지금 이 순간 커널이 실제 사용을 허용하는 capability |
| Ambient | non-root 프로세스가 execve() 이후에도 Permitted/Effective를 유지하기 위한 capability |
bind(2)가 privileged port를 열 때 커널이 확인하는 건 오직 Effective 하나입니다. Bounding이나 Permitted에 들어 있어도 Effective에 없으면 EACCES(13)이 그대로 반환됩니다.
7. Bounding에만 채워져 있습니다
같은 securityContext를 그대로 두고 /proc/1/status를 찍어보는 Pod를 하나 띄웠습니다.
apiVersion: v1
kind: Pod
metadata:
  name: cap-debug
  namespace: capability-demo
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 1000
    runAsGroup: 1000
  containers:
    - name: app
      image: nginx:1.25-alpine
      command: ["sh", "-c", "cat /proc/1/status | grep Cap; sleep 3600"]
      securityContext:
        allowPrivilegeEscalation: false
        seccompProfile:
          type: RuntimeDefault
        capabilities:
          drop: ["ALL"]
          add: ["NET_BIND_SERVICE"]
# kubectl logs -n capability-demo cap-debug
CapInh:	0000000000000000
CapPrm:	0000000000000000
CapEff:	0000000000000000
CapBnd:	0000000000000400
CapAmb:	0000000000000000
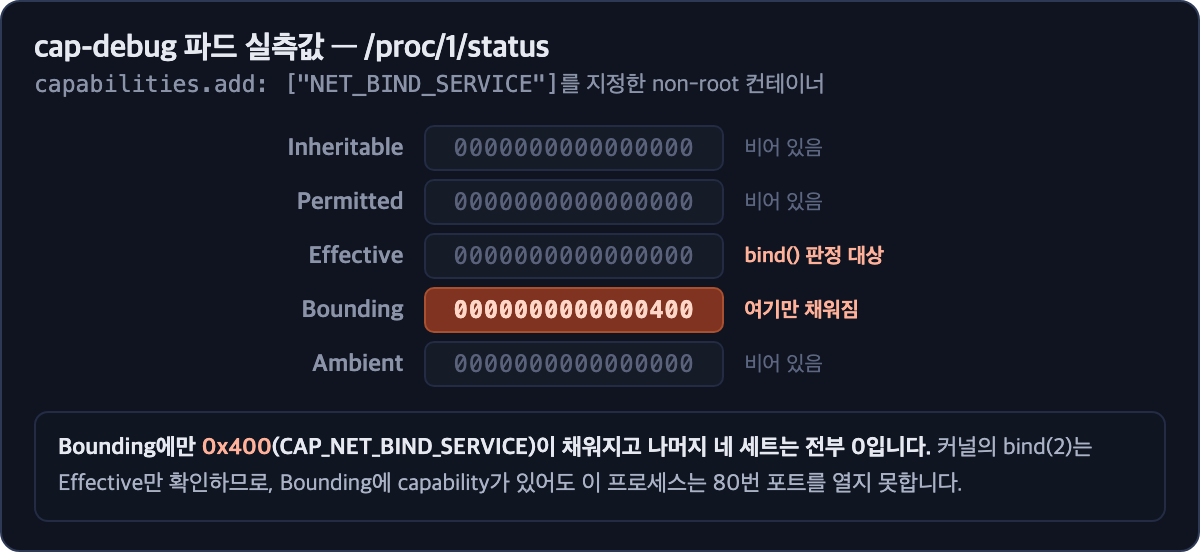
0x400은 CAP_NET_BIND_SERVICE에 해당하는 비트입니다. YAML에 적은 add가 Bounding까지는 정확히 도달했다는 뜻입니다. 그런데 bind()가 확인하는 Effective는 비어 있습니다. add 설정 자체는 무시되지 않고 Bounding까지 정확히 반영됐지만, bind()가 실제로 확인하는 Effective에는 반영되지 않은 것입니다.
8. execve 전이 공식으로 보는 Bounding 정지 이유
프로세스가 execve()를 거칠 때마다 커널은 새 Permitted를 이 공식으로 계산합니다.
두 번째 항은 대상 바이너리 자체에 file capability가 setcap으로 박혀 있을 때만 성립합니다. nginx 이미지가 그런지 확인해 보면 아닙니다. getcap이 설치된 임시 Pod를 띄워 바이너리를 직접 검사했습니다.
# kubectl run cap-check --image=nginx:1.25-alpine -n default --command \
    -- sh -c "apk add --no-cache libcap >/dev/null 2>&1 && getcap -v /usr/sbin/nginx; sleep 3600"
pod/cap-check created
# kubectl logs cap-check
/usr/sbin/nginx
getcap -v는 file capability가 있으면 파일명 뒤에 cap_net_bind_service=ep처럼 목록을 붙여 출력합니다. 파일명만 나왔다는 건 아무것도 박혀 있지 않다는 뜻입니다.
그러면 첫 번째 항(Inheritable 경유)만 남는데, 이건 Ambient set이 미리 채워져 있어야 성립합니다. 실측값에서 확인했듯 Ambient도 Inheritable도 처음부터 0이었으므로, execve를 거치며 Permitted로 넘어갈 수 있는 capability가 이 경로에도 없었습니다.
9. CRI의 flat capability 모델에서 정보가 사라지는 지점
Bounding만 채워지고 나머지가 비는 원인은 containerd 자체가 아니라, kubelet과 컨테이너 런타임이 통신하는 규격인 CRI(Container Runtime Interface)에 있습니다.
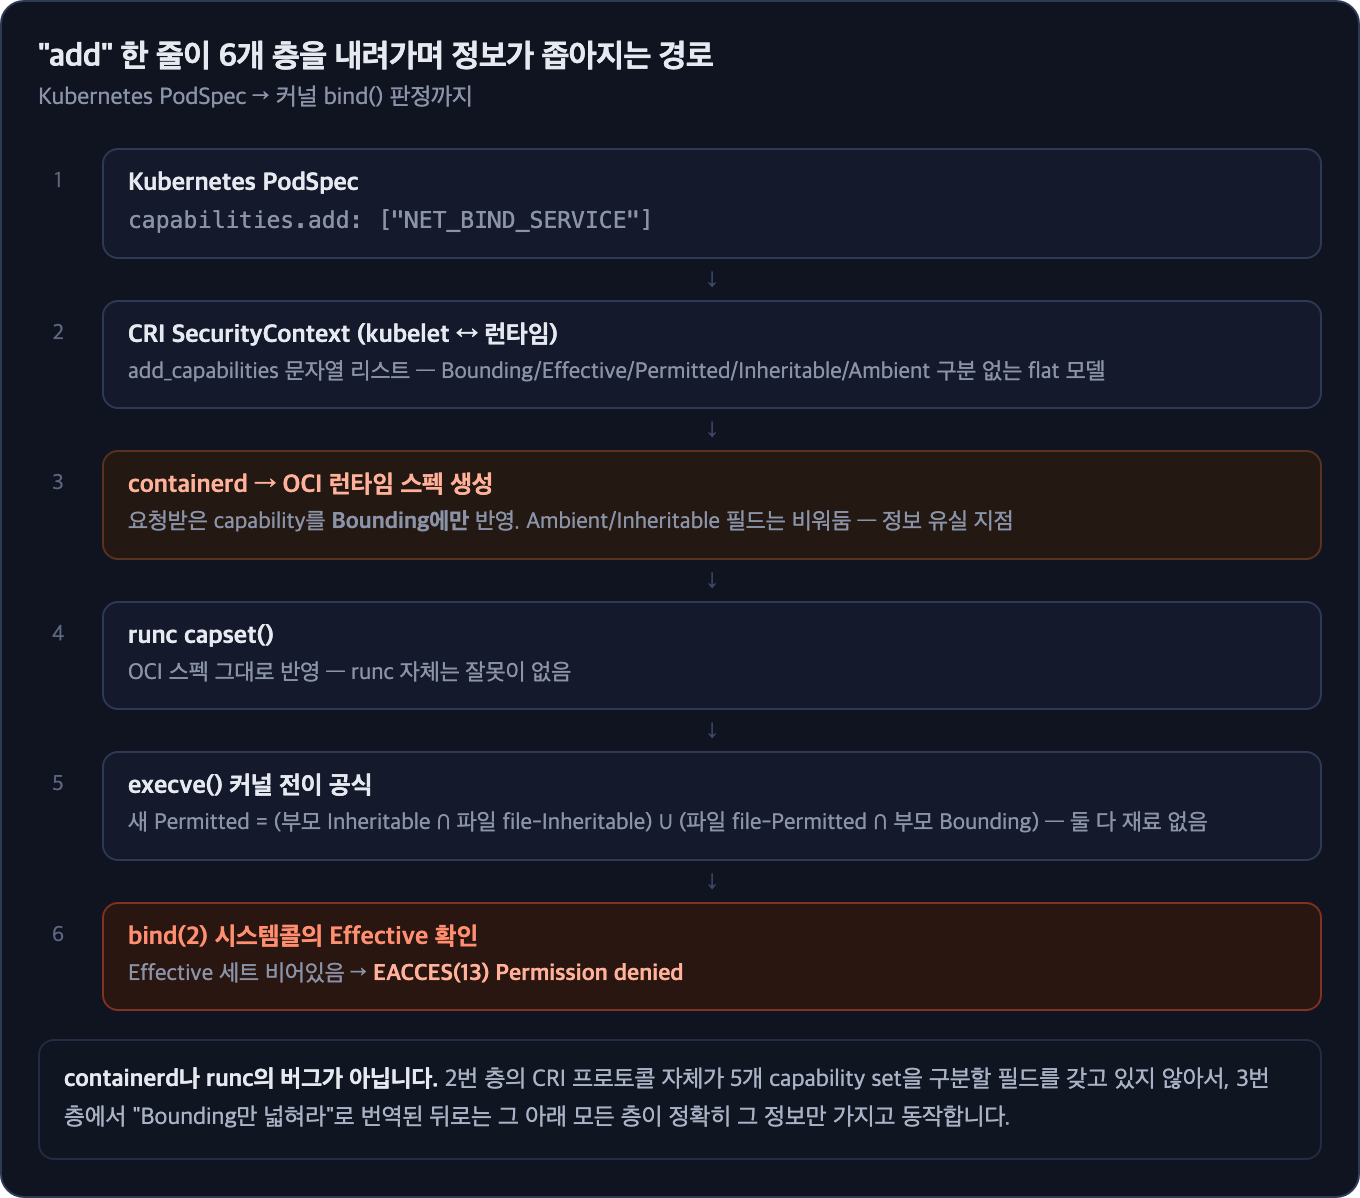
CRI의 SecurityContext 메시지는 add_capabilities라는 문자열 리스트 하나로 되어 있고, Linux가 실제로 구분하는 다섯 개 set에 대응하는 필드가 없습니다. containerd는 이 flat한 리스트를 OCI 런타임 스펙으로 옮기면서 Bounding만 채우고 Ambient/Inheritable은 비워서 runc에 넘깁니다. runc는 받은 스펙을 그대로 capset()으로 반영하니 runc 쪽에 잘못이 있는 것도 아닙니다.
결과적으로 add라는 요청은 CRI 계층을 지나는 순간부터 "Bounding을 넓혀라"로만 번역됩니다. "non-root 프로세스가 execve 이후에도 쓸 수 있게 하라"는 더 정밀한 요구는 그것을 담을 필드가 파이프라인 어디에도 없어서 전달되지 못합니다.
10. 버그일까, 의도된 동작일까
containerd 소스코드에는 ambient set을 비우는 이 동작에 대한 명시적인 코멘트가 있습니다.
Clear all ambient capabilities. The implication of non-root + caps is not clearly defined in Kubernetes.
실수로 빠뜨린 게 아니라, "non-root 프로세스에 capability를 준다는 것이 정확히 무엇을 의미하는지 Kubernetes 차원에서 아직 정의되지 않았다"는 이유로 의도적으로 택한 보수적 기본값입니다.
동시에 알려진 채로 남아 있는 gap이기도 합니다.
- kubernetes/kubernetes#56374 — 2017년에 열린 원 이슈
- KEP-2763 Ambient Capabilities — 이를 정식으로 메우려는 제안. 기존
add필드를 손보는 대신 ambient 전용 필드(ambient: []Capability)를 따로 추가하는 방향입니다.add(Bounding 확장)와 ambient(실제 사용 가능)를 서로 다른 무게의 보안 결정으로 보고 한데 묶지 않으려는 판단으로 읽힙니다. - containerd/containerd#5644 — 위 KEP을 구현하려던 containerd 쪽 추적 이슈인데 "not planned"로 종료되어 있습니다.
- CRI-O는 한때 유사한 옵션(
add_inheritable_capabilities)을 제공했지만, 그 경로에서 CVE-2022-27652가 발견된 뒤 1.24.0에서 제거했습니다.
지금 동작은 의도된 설계이면서, 이대로 유지하자는 합의가 있는 것도 아닌 상태입니다. 고쳐야 한다는 공감대는 KEP이 존재한다는 사실로 드러나는데 안전하게 고치는 방법에 대한 결론이 없어 수년째 멈춰 있는, known gap으로 보는 편이 정확하다고 생각합니다.
11. 특정 버전 문제가 아니라는 교차검증
containerd의 특정 버전 이슈일 가능성을 배제하기 위해, 서로 다른 두 클러스터에서 같은 실험을 반복했습니다.
# 로컬 (Docker Desktop 내장 클러스터)
desktop-control-plane   containerd://1.7.18
desktop-worker          containerd://1.7.18

# 원격 (kubeadm 6노드 클러스터)
# kubectl get nodes -o wide | awk '{print $1, $NF}'
NAME CONTAINER-RUNTIME
control-plane01 containerd://2.2.1
control-plane02 containerd://2.2.1
control-plane03 containerd://2.2.1
worker-node01 containerd://2.2.1
worker-node02 containerd://2.2.1
worker-node03 containerd://2.2.1
1.7.18과 2.2.1은 메이저 버전이 다른데도 /proc/1/status 실측 결과가 두 클러스터에서 동일했습니다. 특정 버전에서 수정되고 있는 문제라면 이렇게 나오지 않을 것입니다. CRI의 데이터 모델 자체를 원인으로 보는 근거로 삼았습니다.
12. 실제로 적용한 우회 방법
Ambient 경로가 막혀 있다는 전제에서 실제로 동작하는 방법은 넷입니다.
- 이미지 빌드 시점에 file capability를 박기 —
setcap cap_net_bind_service=+ep /usr/sbin/nginx.execve공식의 두 번째 항으로 성립하므로 Ambient와 무관하게 동작합니다. 대신 이미지를 직접 빌드해야 하고, 서드파티 이미지를 그대로 쓰는 경우에는 선택할 수 없습니다. - listen 포트를 1024번 이상으로 내리기 —
containerPort는 문서용 메타데이터라 이 값만 고쳐서는 실제 bind 포트가 바뀌지 않고,nginx.conf(또는conf.d/default.conf)의listen을 직접 바꿔야 합니다. 다만 여기서 끝나지 않는다는 점이 함정입니다. - unprivileged 이미지로 교체하기 —
nginxinc/nginx-unprivileged는 기본listen이 8080이고pid도/tmp/nginx.pid로 옮겨져 있습니다. - Service의 port와 targetPort를 분리하기 — 외부에는 80번으로 노출하고(
port: 80) 컨테이너 내부는 8080에서 listen하게 합니다(targetPort: 8080).
2번을 택할 때 주의할 점이 있습니다. listen만 8080으로 내리고 UID 1000으로 nginx:1.25-alpine을 띄우면 포트와 무관한 이유로 두 번 더 막힙니다.
# listen 8080으로 내린 직후
[emerg] mkdir() "/var/cache/nginx/client_temp" failed (13: Permission denied)

# /var/cache/nginx를 쓰기 가능하게 한 뒤
[emerg] open() "/var/run/nginx.pid" failed (13: Permission denied)
캐시 디렉토리와 PID 파일 경로가 둘 다 root 소유라서, 두 경로 모두에 쓰기 가능한 volume(Kubernetes라면 emptyDir)을 마운트해야 비로소 기동됩니다. 세 가지를 함께 적용하면 UID 1000으로 8080번에서 정상 응답합니다. 3번 이미지는 이 두 경로를 이미지 쪽에서 미리 정리해 둔 덕분에, 별도 설정 없이도 non-root로 바로 뜹니다.
저는 3번과 4번을 함께 택했습니다. capability를 어떻게든 살려내는 쪽보다, 컨테이너가 privileged port를 만질 필요 자체를 없애는 편이 restricted 프로파일의 취지에도 맞고 클러스터 런타임 구성에 덜 의존한다고 판단했습니다. 요즘 애플리케이션 이미지는 대부분 1024번 이상을 기본 포트로 쓰기 때문에, 이 문제를 만나는 쪽은 오래된 관행을 이어받은 웹서버 이미지에 가깝습니다.
트러블슈팅 체크리스트
같은 계열의 증상을 다시 만났을 때 확인하는 순서를 정리해 두었습니다.
| 증상 | 확인 | 조치 |
|---|---|---|
| Pod가 생성조차 안 됨 | kubectl get events의 FailedCreate |
admission 메시지가 요구하는 필드를 채움 |
CreateContainerConfigError |
runAsNonRoot만 있고 runAsUser가 없는지 |
실행 UID를 명시 |
파일·디렉토리 Permission denied |
kubectl exec -- id와 ls -ln 비교 |
owner가 필요하면 runAsUser, group이면 fsGroup |
| volume 경로만 권한 오류 | 해당 경로가 이미지 내장인지 volume인지 | 이미지 내장 경로는 emptyDir 등으로 덮고 fsGroup 적용 |
privileged port bind() 실패 |
/proc/1/status의 CapEff |
포트를 1024번 이상으로 옮기거나 이미지에 setcap |
| 포트를 옮겼는데도 기동 실패 | 로그에 찍힌 경로가 캐시인지 PID 파일인지 | /var/cache/nginx, /var/run 각각에 쓰기 가능한 volume 마운트 |
정리
restrictedadmission은 Deployment가 아니라 Pod 생성 시점에 거부하므로, 원인은FailedCreate이벤트에 남습니다.runAsNonRoot: true는 제약 선언일 뿐이어서, 이미지가 root로 실행되도록 만들어져 있으면runAsUser를 함께 지정해야 합니다.runAsUser/runAsGroup은 프로세스의 신분만 바꾸고 파일 소유권은 건드리지 않습니다. volume 쪽을 맞추는 설정이fsGroup이며, owner가 아니라 group만 변경합니다.- 커널의
bind(2)는 Bounding이 아니라 Effective capability set만 확인합니다. - Kubernetes의
capabilities.add는 non-root 컨테이너에서 Bounding까지만 채워주고 Effective/Ambient는 보장하지 않습니다. CRI의 SecurityContext 메시지가 다섯 개 set을 구분하지 못하는 flat한 구조이기 때문입니다. - containerd가 ambient set을 비우는 것은 의도된 보수적 설계이지만, 이를 메우려는 KEP-2763의 구현 이슈는 멈춰 있는 상태입니다.
- 바이너리에 file capability가 없다면, non-root +
capabilities.add조합만으로 privileged port를 여는 것은 이 구조상 불가능합니다. - 포트를 1024번 이상으로 내리는 우회를 택하더라도
listen한 줄로 끝나지 않습니다. nginx 기준으로 캐시 디렉토리와 PID 파일 경로가 root 소유라, 두 경로에 쓰기 가능한 volume을 함께 붙여야 non-root로 기동됩니다.