
"서버가 터졌습니다."
서버가 터졌다는 말은 대체 뭘 의미하는걸까요? 누가 서버가 왜 터졌냐고 물어보면, 단순히 "트래픽이 너무 많이 들어와서"라고 답변하는 것은 부족할지 모릅니다.
본 포스트에서는 서버가 터지는 과정을 low-level 네트워크부터 커널스페이스, 유저스페이스, 크게는 인프라 전체에 걸쳐서 바텀업 방식으로 살펴보고자 합니다.
물리 서버 4대가 있다고 합시다. 1대는 nginx로 reverse proxy 역할을 하고, 나머지 3대(A, B, C)가 각각 같은 웹 서비스를 구동하며 트래픽을 1/3씩 나눠 받습니다.
어느 순간 서버 A가 모종의 이유로 멈춥니다. 그리고 오래지 않아 B와 C도 차례로 멈추면서 시스템 전체가 불능 상태가 됩니다. A 한 대의 장애가 어떻게 나머지 두 대의 자원까지 끌고 내려가는지, 그리고 애초에 "자원이 부족하면 요청을 거부하면 되지 않나"라는 질문에 왜 실제 시스템들은 그렇게 하지 않는지를 커널부터 인프라까지 순서대로 따라가 보겠습니다.
이 글은 TCP를 기준으로 설명합니다. TCP가 연결을 어떻게 받아들이고, 그 큐가 어떻게 넘치고, 그 위에서 애플리케이션이 어떻게 무너지는지를 이해하고 나면 — 연결이라는 개념 자체가 없는 UDP가 왜 다른 방식으로 폭주에 대응하는지도 자연히 짐작할 수 있습니다. 순서는 커널의 큐 → 애플리케이션의 자원 → 장애 전파 시나리오 → 설계 원칙 → 인프라 확장(로드밸런서, CDN) 순으로, 기준이 되는 구조 하나를 두고 앞단에 계층을 한 겹씩 붙여나가는 방식으로 진행합니다.
기준 구조
이후 모든 설명은 이 구조를 기준으로 삼습니다. nginx 1대가 reverse proxy로 트래픽을 받아 A, B, C 세 대의 백엔드에 라운드로빈으로 분배합니다.

여기서 A가 죽고, 이어서 B와 C도 죽습니다. 왜 그런 일이 일어나는지 보려면 가장 밑바닥, 즉 연결 하나가 커널 안에서 어떻게 처리되는지부터 봐야 합니다.
바닥부터: TCP 연결과 두 개의 커널 큐
클라이언트가 서버에 접속하면 3-way handshake가 일어납니다. SYN을 보내고, 서버가 SYN+ACK로 응답하고, 클라이언트가 ACK로 확인하는 세 번의 교환입니다. 이 과정은 전적으로 커널 스페이스에서 처리됩니다. 애플리케이션(nginx, WAS 등)은 socket(), listen(), accept() 같은 시스템 콜로 커널에 위임할 뿐, handshake 자체에는 관여하지 않습니다.
3-way handshake는 왜 유저 스페이스가 아니라 커널 스페이스에서 처리될까?
TCP/IP 스택 자체가 커널에 구현되어 있어서, NIC에 도착한 패킷은 인터럽트를 거쳐 곧바로 커널의 네트워크 스택으로 들어갑니다. 유저 프로세스는 이 경로에 개입할 방법이 없고, listen() 이후로는 커널이 알아서 SYN에 SYN+ACK로 응답하고 handshake를 완성시킵니다. 그래서 nginx worker가 잠시 멈춰 있어도, accept()를 못 부르고 있을 뿐 handshake 자체는 커널이 계속 처리하고 있을 수 있습니다. 이 분리 덕분에 "커널 레벨 거부"와 "애플리케이션 레벨 거부"가 서로 다른 계층에서, 서로 다른 비용으로 일어나게 됩니다.
서버 입장에서 연결은 두 개의 큐를 순서대로 거칩니다.
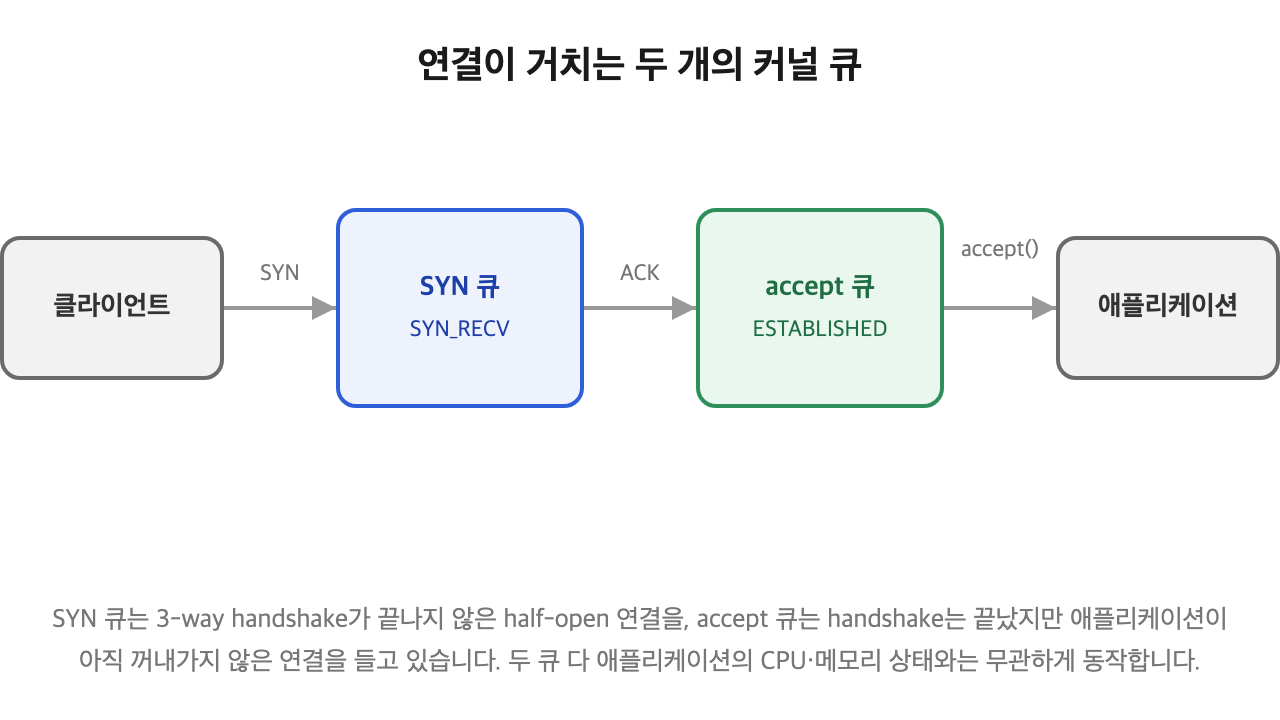
- SYN 큐: SYN을 받고 SYN+ACK를 보낸 뒤, 클라이언트의 ACK를 기다리는
SYN_RECV상태의 연결이 대기합니다. - accept 큐: ACK까지 받아
ESTABLISHED가 된 연결이, 애플리케이션의accept()호출을 기다리며 대기합니다.
그럼 accept()는 정확히 무슨 일을 할까?
연결은 accept()가 불리기 이전에 이미 커널 안에서 ESTABLISHED 상태로 완성되어 있습니다. accept()는 handshake를 끝내는 함수가 아니라, accept 큐 맨 앞의 완성된 연결 하나를 큐에서 꺼내고 그 자리에 새 파일 디스크립터를 만들어 유저 스페이스로 인도하는 함수입니다. 이 제거가 일어나야 그 슬롯에 다음 연결이 들어갈 자리가 생깁니다. 애플리케이션이 accept()를 계속 못 부르면 accept 큐는 계속 가득 찬 채로 남습니다. 실제로 지금 이 순간의 큐 상태는 ss -lnt로 확인할 수 있고, Recv-Q가 accept 큐에 쌓인 연결 수, Send-Q가 큐의 최대 길이(min(somaxconn, backlog))를 가리킵니다.
큐가 가득 찼을 때 실제로 벌어지는 일
이 두 큐는 "여기까지만 받는다"는 상한선이 아닙니다. 큐가 가득 찼을 때 벌어지는 일은 실제로는 이렇습니다.
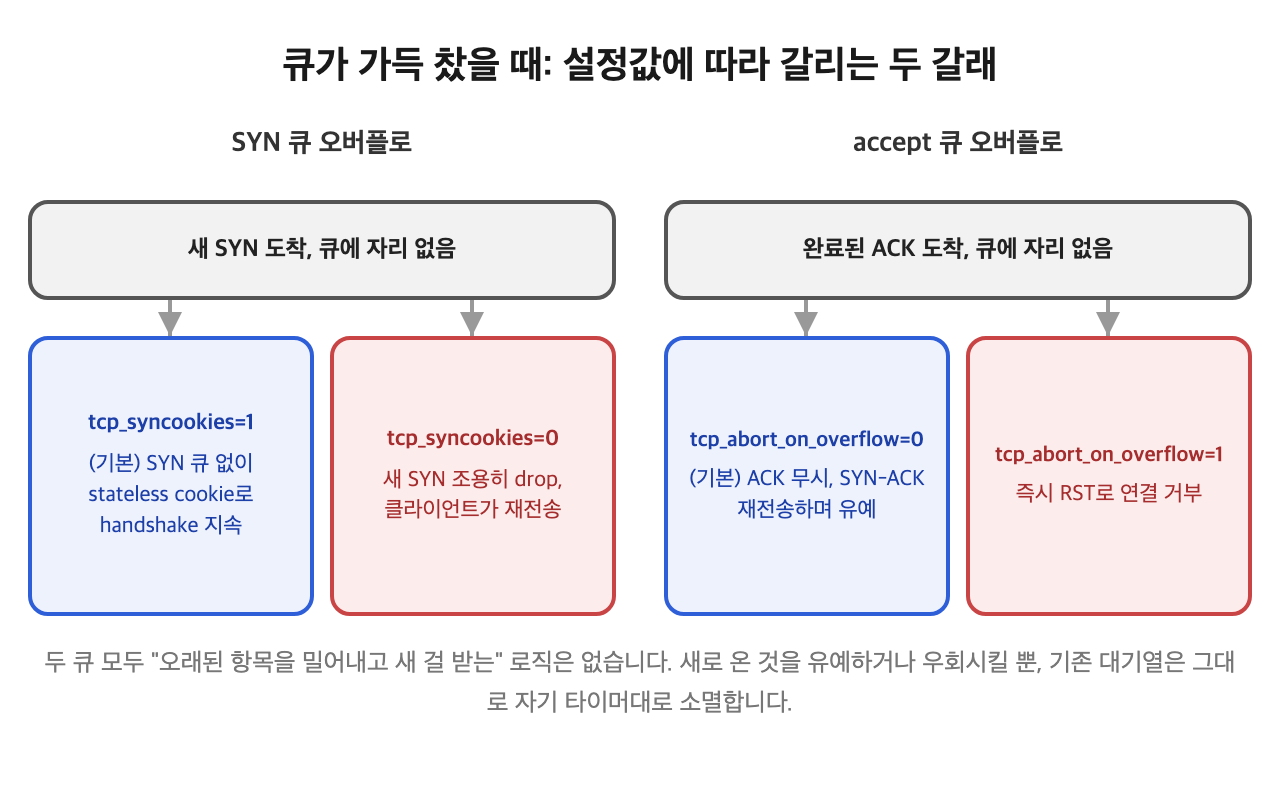
두 경우 다 "영원히 거부"가 아니라 "지금 당장은 안 되니 잠시 후 다시 시도해"에 가깝습니다. tcp_syncookies=1(기본값)이면 SYN 큐는 넘치는 대신 상태를 저장하지 않는 syncookie로 전환되어 handshake를 이어가고, accept 큐가 가득 차도 기본값(tcp_abort_on_overflow=0)은 ACK를 무시하고 SYN+ACK를 재전송하며 애플리케이션이 따라잡을 시간을 벌어줍니다. 애플리케이션이 accept()를 계속 호출해서 큐를 계속 비워주는 한, 연결은 계속 쌓여 들어갈 수 있습니다.
즉 커널 큐는 거부 장치가 아니라 완충재입니다. 진짜 천장은 커널 큐가 아니라 그 뒤에 있는 애플리케이션의 처리 능력에 있고, 그 천장은 미리 설계되어 있다기보다 애플리케이션 자원이 실제로 바닥나야만 비로소 드러나는 경우가 많습니다. (SYN flooding 공격과 syncookie의 정확한 동작, 큐 크기 계산식, ss/netstat 진단법은 이전에 정리한 SYN flooding 공격과 syncookie 방어에서 더 깊이 다뤘습니다.)
왜 커널은 처음부터 syncookie만 쓰지 않을까?
tcp_syncookies=2(항상 사용)도 있지만 디버그 용도일 뿐 프로덕션 기본값은 아닙니다. 이유는 두 가지입니다. 첫째, syncookie는 상태를 32비트 시퀀스 번호에 암호학적으로 욱여넣는 방식이라 매 SYN·ACK마다 해시 연산이 필요합니다. 큐가 여유로운 평소에는 구조체 하나 큐에 넣고 빼는 게 해시 계산보다 훨씬 쌉니다. 둘째, 좁은 32비트 공간에는 window scaling, SACK 같은 TCP 옵션을 담을 자리가 없어서 정상적으로 큐에 저장했을 때보다 연결 품질이 떨어집니다. 그래서 syncookie는 "평소엔 꺼져 있다가 큐가 실제로 넘칠 때만 발동하는 안전판"으로 남겨두는 쪽이 더 낫습니다.
진짜 천장은 애플리케이션에 있다
accept()를 부르는 것도, 그 이후 요청을 처리하는 것도 결국 애플리케이션의 일입니다. 여기서 동시성 모델에 따라 부딪히는 지점이 갈립니다.
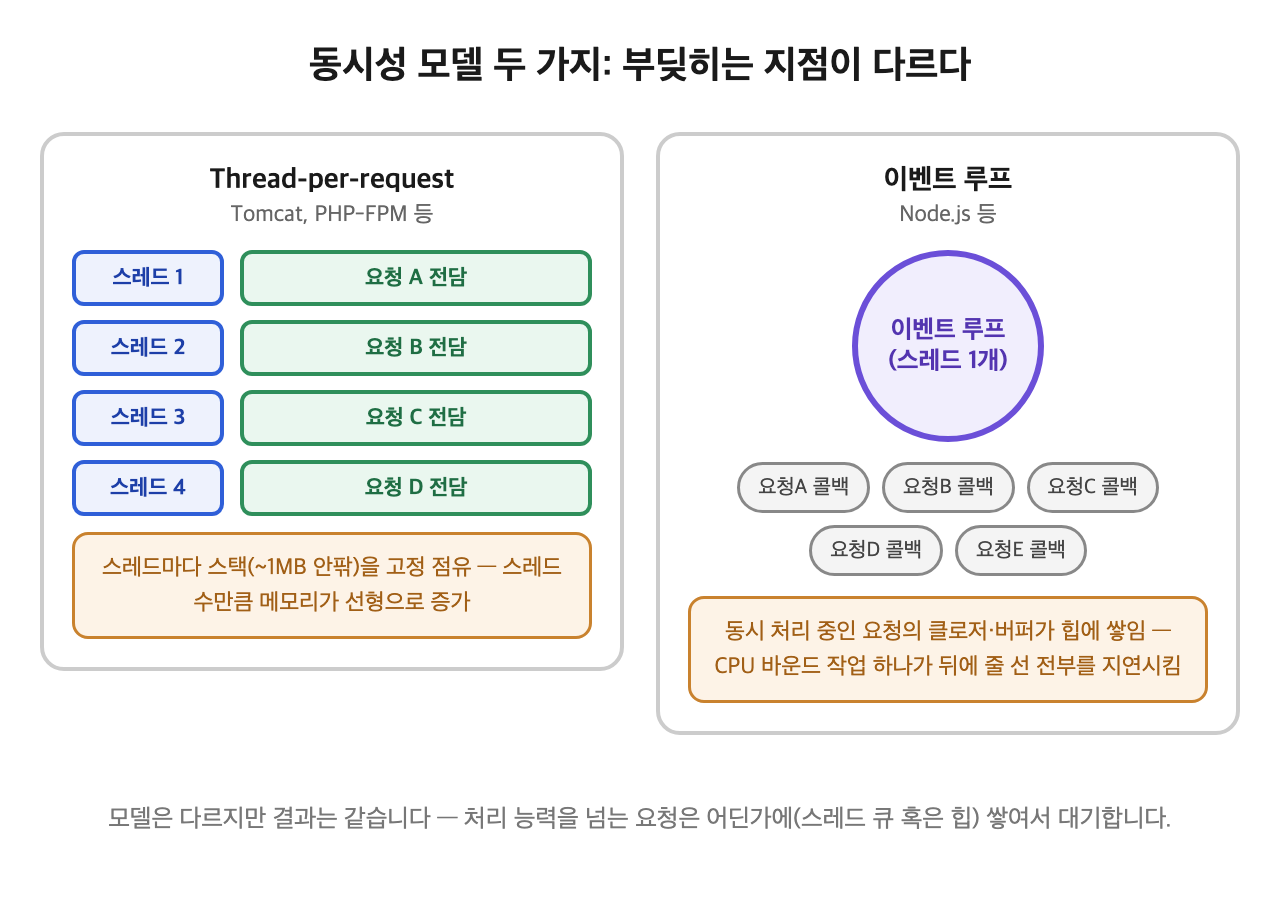
Thread-per-request 모델(Tomcat, PHP-FPM 등)은 요청마다 스레드를 하나 점유하고, 스레드마다 고정된 스택 메모리를 물고 있어 스레드 수만큼 메모리가 선형으로 늘어납니다. 이벤트 루프 모델(Node.js 등)은 스레드는 적지만, 동시에 처리 중인 요청들의 콜백과 버퍼가 힙에 쌓입니다. 모델은 다르지만 결과는 같습니다 — 처리 능력을 넘는 요청은 어딘가에 쌓여서 대기합니다.
fd 예산: 리버스 프록시는 슬롯을 두 배로 쓴다
nginx 같은 리버스 프록시에서는 여기에 한 가지가 더 붙습니다. worker_connections는 클라이언트와의 연결만 세지 않고, 프록시 대상(백엔드)과의 연결도 같은 예산에서 함께 셉니다.
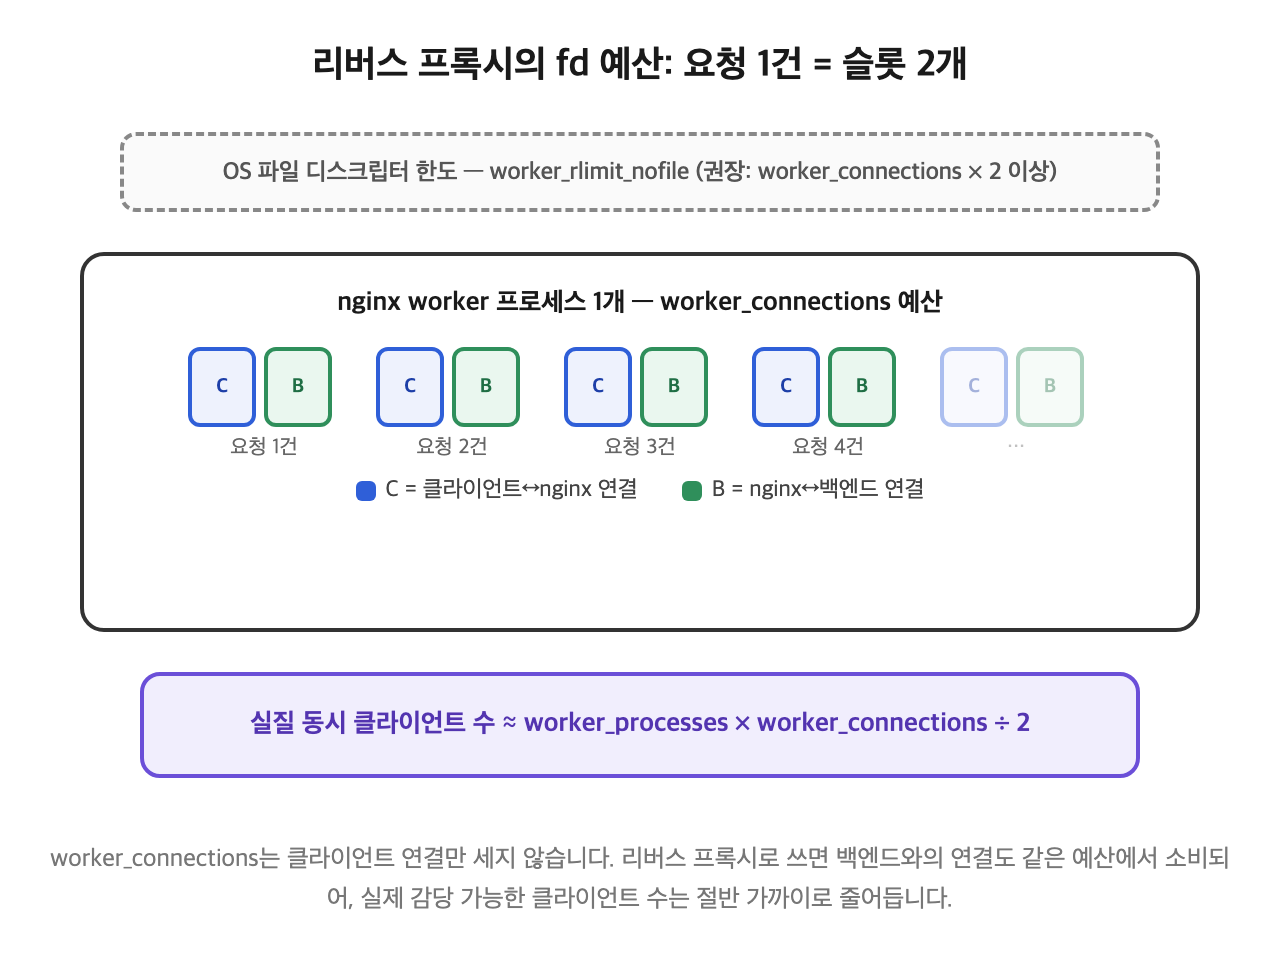
클라이언트 요청 하나를 프록시하려면 클라이언트↔nginx 연결 1개와 nginx↔백엔드 연결 1개, 총 2개의 슬롯이 필요하기 때문입니다. 그리고 이 연결이 얼마나 오래 슬롯을 붙잡고 있는지는 연결이 어떤 성격인지에 따라 크게 갈립니다. 이 글의 예시는 HTTP keep-alive를 기준으로 합니다 — 같은 TCP 연결 위에서 여러 요청-응답을 순차적으로 재사용하다가, keepalive_timeout(nginx 기본 75초) 동안 새 요청이 없으면 자동으로 닫혀 슬롯을 반납하는 방식입니다. 즉 연결이 열려있는 이유는 다음 요청을 위한 유예일 뿐, 실제로 아무것도 안 하고 있으면 자원을 놓아줍니다.
worker_connections=1024면 정말 1024명만 처리 가능한가?
세 가지를 놓치면 오해가 생깁니다. 첫째, worker_connections는 worker 프로세스 하나의 한도라 전체 한도는 worker_processes × worker_connections입니다. 둘째, 리버스 프록시로 쓰면 위 공식대로 실질 동시 클라이언트 수는 그 절반 가까이입니다. 셋째, 이 숫자는 "지금 열려있는" 동시 연결 수 한도지 누적 처리량이 아니라서, 연결이 빠르게 열렸다 닫히면 초당 처리량은 이 숫자보다 훨씬 클 수 있습니다. 문제는 연결이 오래 붙잡혀 있을 때(느린 백엔드, 타임아웃 대기 등) 슬롯 회전율이 떨어져 한도에 더 빨리 부딪힌다는 점입니다. 그리고 이 값은 결국 OS 파일 디스크립터 한도(worker_rlimit_nofile) 안에서만 유효합니다.
WebSocket은 keep-alive와 뭐가 다를까?
Keep-alive는 "idle = 정상"입니다. 다음 요청이 없으면 아무것도 안 보내고, 타임아웃이 지나면 커넥션이 자연히 정리되며 자원이 회수됩니다. WebSocket은 다릅니다. 시작은 HTTP handshake(Upgrade: websocket)를 빌리지만, 101 응답이 오는 순간 그 TCP 연결은 HTTP를 완전히 벗어나 독자적인 바이너리 프레이밍 프로토콜로 전환됩니다. 이후로는 클라이언트가 세션을 유지하는 동안(수 분~수 시간) 연결이 계속 열려 있는 게 정상 동작이고, nginx는 세션이 끝날 때까지 클라이언트·백엔드 양쪽 연결을 계속 물고 있어야 합니다. 중간 인프라(NAT, 방화벽, 클라우드 LB)의 idle timeout에 걸려 조용히 끊기는 걸 막기 위해 RFC 6455가 정의한 Ping/Pong 제어 프레임(순수 바이너리 프레임이지 HTTP 메시지가 아닙니다)을 주기적으로 주고받는데, 이게 오히려 그 연결을 "항상 트래픽이 흐르는 상태"로 유지시켜 자연스러운 자원 회수를 막습니다. 그래서 WebSocket 비중이 큰 서비스는 동시 접속자 수가 곧 점유 중인 fd 슬롯 수와 거의 같아지고, worker_connections와 시스템 fd 한도를 훨씬 공격적으로 올려야 합니다.
장애 전파: A가 죽는다
A가 멈추는 방식은 한 가지가 아닙니다. 그리고 어떻게 죽었는지에 따라 nginx가 그 사실을 알아채는 데 걸리는 시간과 비용이 크게 달라집니다.
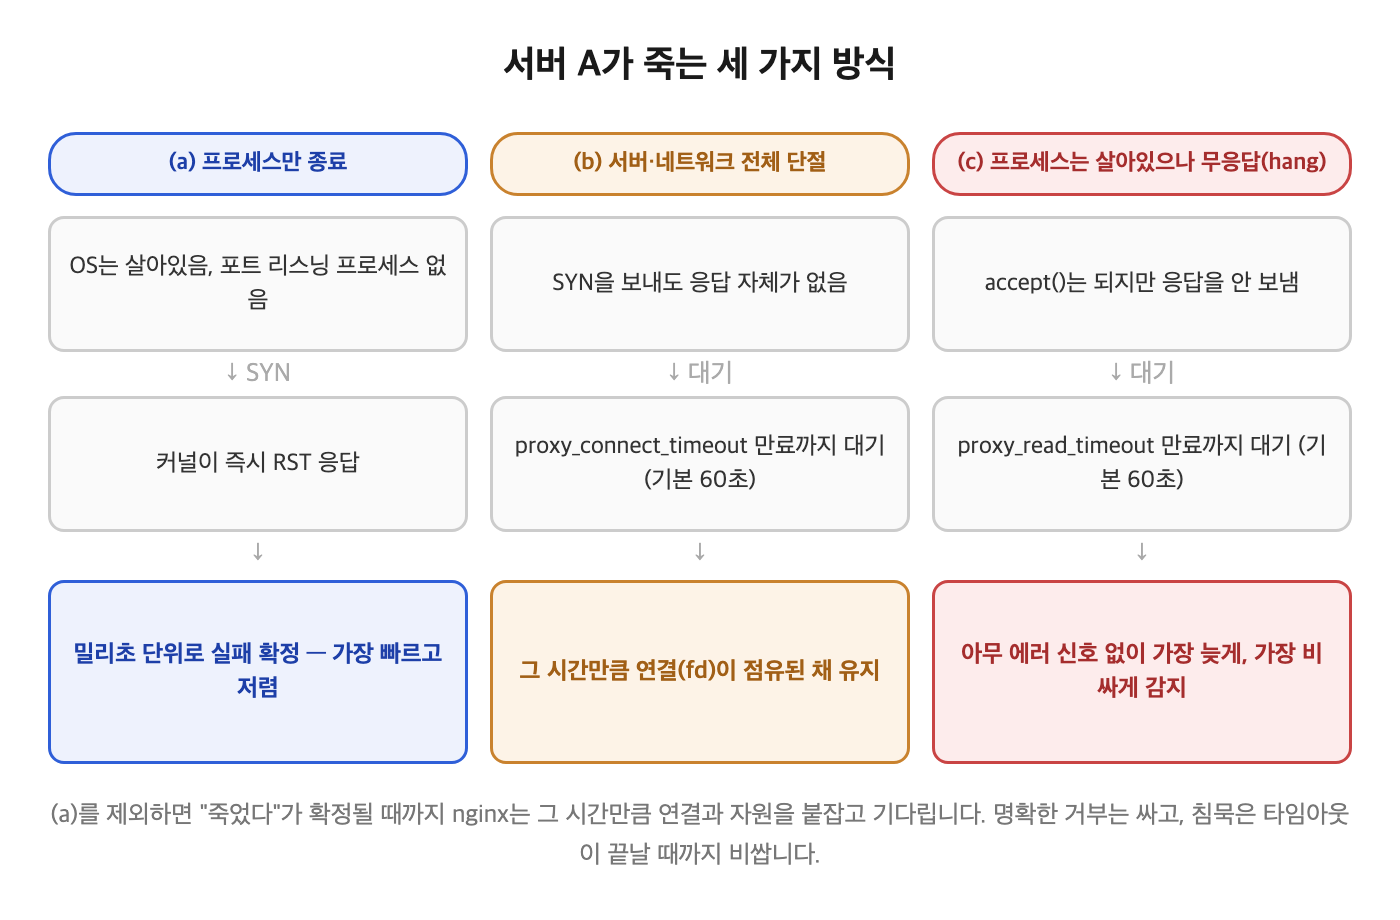
(a)를 제외하면 "죽었다"가 확정될 때까지 nginx는 그 시간만큼 연결과 자원을 붙잡고 기다립니다. 명확한 거부(RST)는 싸고 빠르지만, 침묵은 타임아웃이 끝날 때까지 비쌉니다.
오픈소스 nginx는 능동적으로 헬스체크를 폴링하지 않고, 실제 요청이 실패하는 걸 관찰해서 배우는 passive health check 방식입니다(max_fails, 기본 1회 / fail_timeout, 기본 10초). 게다가 proxy_next_upstream 기본 설정 때문에, A가 아직 upstream 풀에서 제외되기 전까지는 A로 갔다 실패한 요청이 B나 C로 자동 재시도됩니다. 클라이언트 입장에서는 투명한 장애 극복이지만, 그 감지 전 과도기 동안에는 실질적으로 요청이 이중으로 처리됩니다.
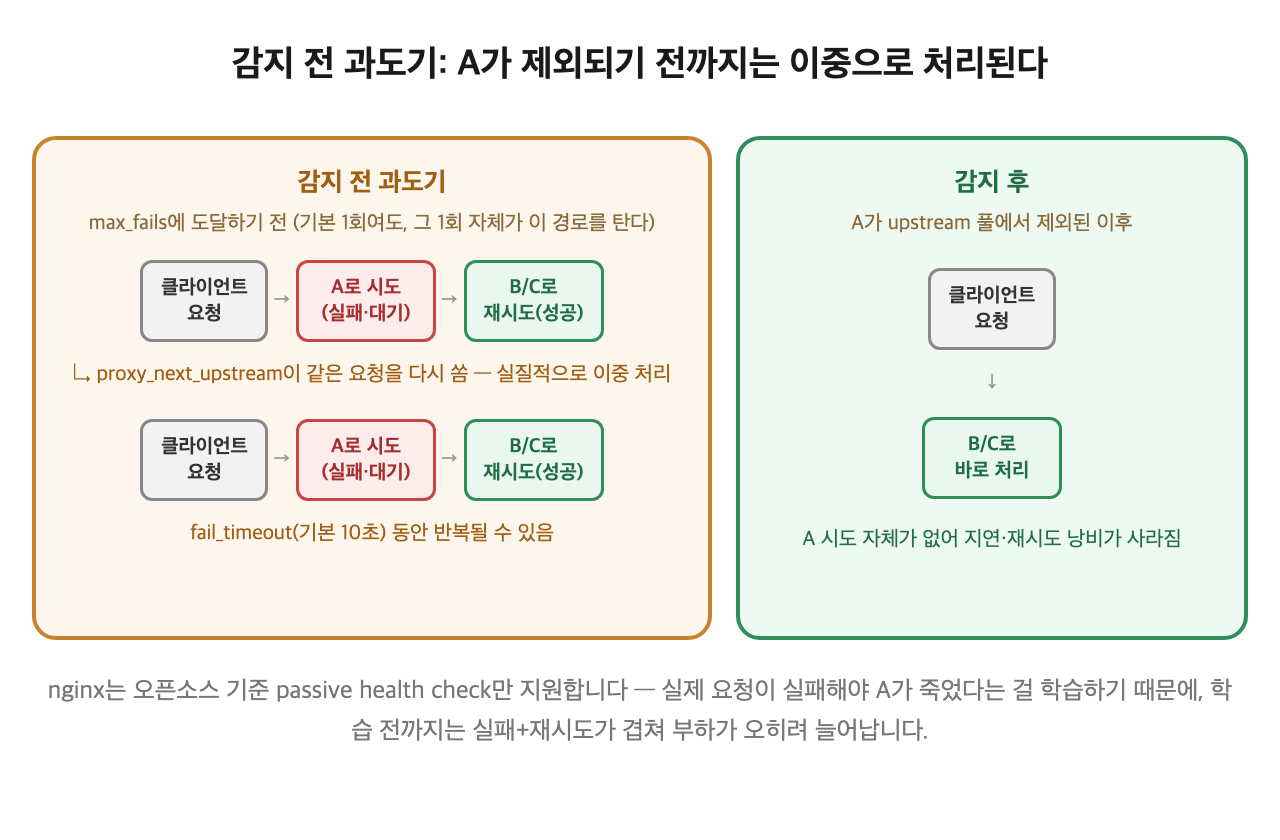
A가 정식으로 제외되고 나면 round-robin이든 least_conn이든 B와 C 두 대가 A 몫까지 나눠 받습니다. 원래 각자 1/3씩 처리하던 게 1/2씩(약 1.5배)이 되고, 이 1.5배는 앞선 이중 처리 비용을 이미 한 번 치른 뒤에 도달한 상태입니다.
B, C 내부에서 자원이 고갈되는 순서
"느려짐"이 왜 저절로 "더 큰 부하"로 바뀌는지를 보여주는 피드백 루프가 여기서 시작됩니다.
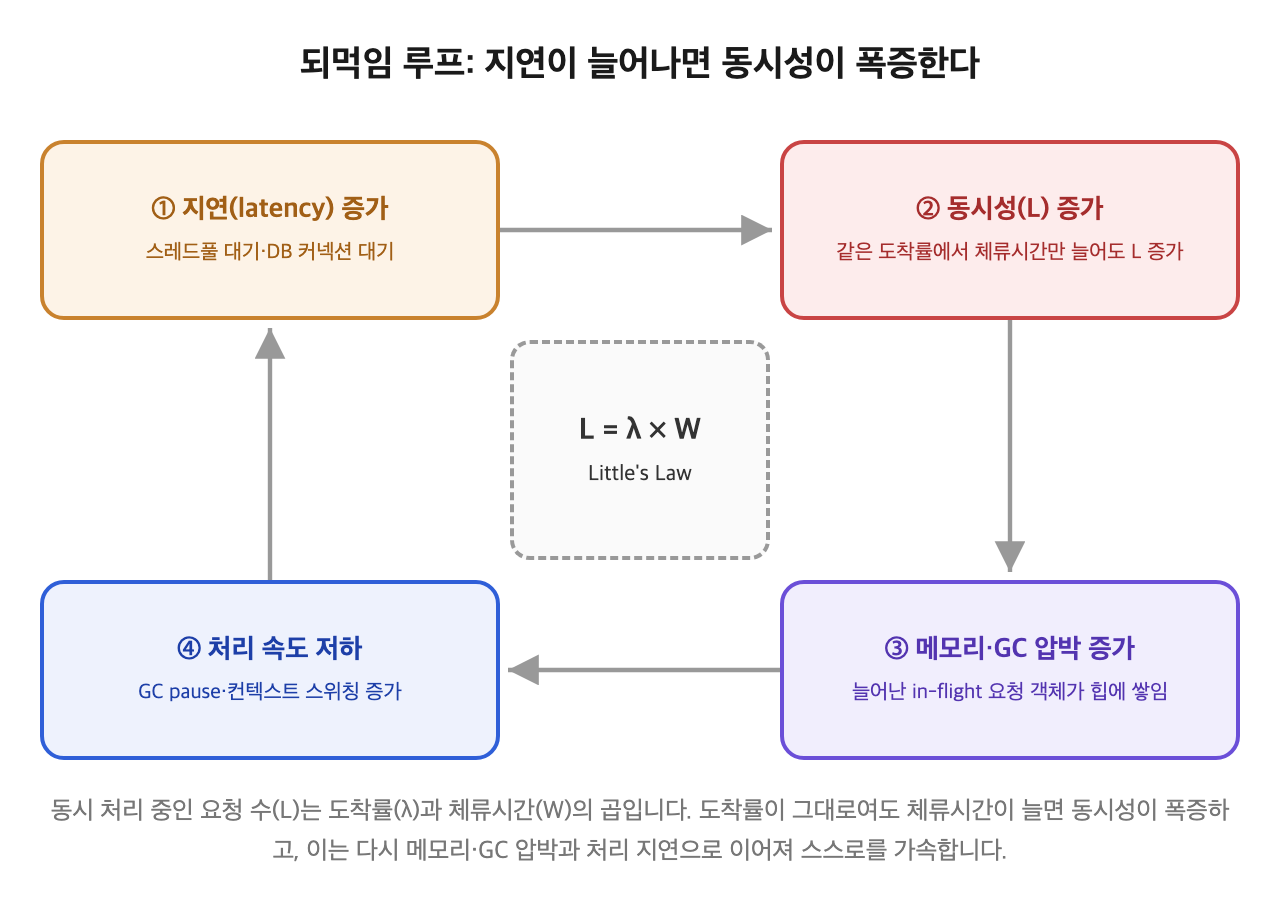
대기 이론의 Little's Law(L = λ × W)에 따르면, 동시에 처리 중인 요청 수(L)는 도착률(λ)과 요청 하나가 시스템에 머무는 시간(W)의 곱입니다. 평소 요청이 50ms 만에 끝나고 초당 1000건이 들어오면 동시 처리 요청 수는 50개 정도지만, 부하가 몰려 응답 시간이 2초로 늘어나면 도착률이 그대로여도 동시 처리 요청 수는 2000개로 폭증합니다. 지연 증가가 저절로 동시성 증가로 변환되는 것이고, 이건 스레드풀·fd·메모리 예산을 순식간에 넘어섭니다.
동시 처리 중인 요청이 늘어나면 힙에 살아있는 요청 객체와 버퍼도 늘어나 GC 압박이 커지고, GC pause가 길어질수록 대기 시간(W)이 다시 늘어나 동시성(L)이 더 늘어나는 악순환에 들어갑니다. 여기에 실패한 요청이 여러 경로에서 중복 재시도되며 돌아오면 상황은 더 나빠집니다.
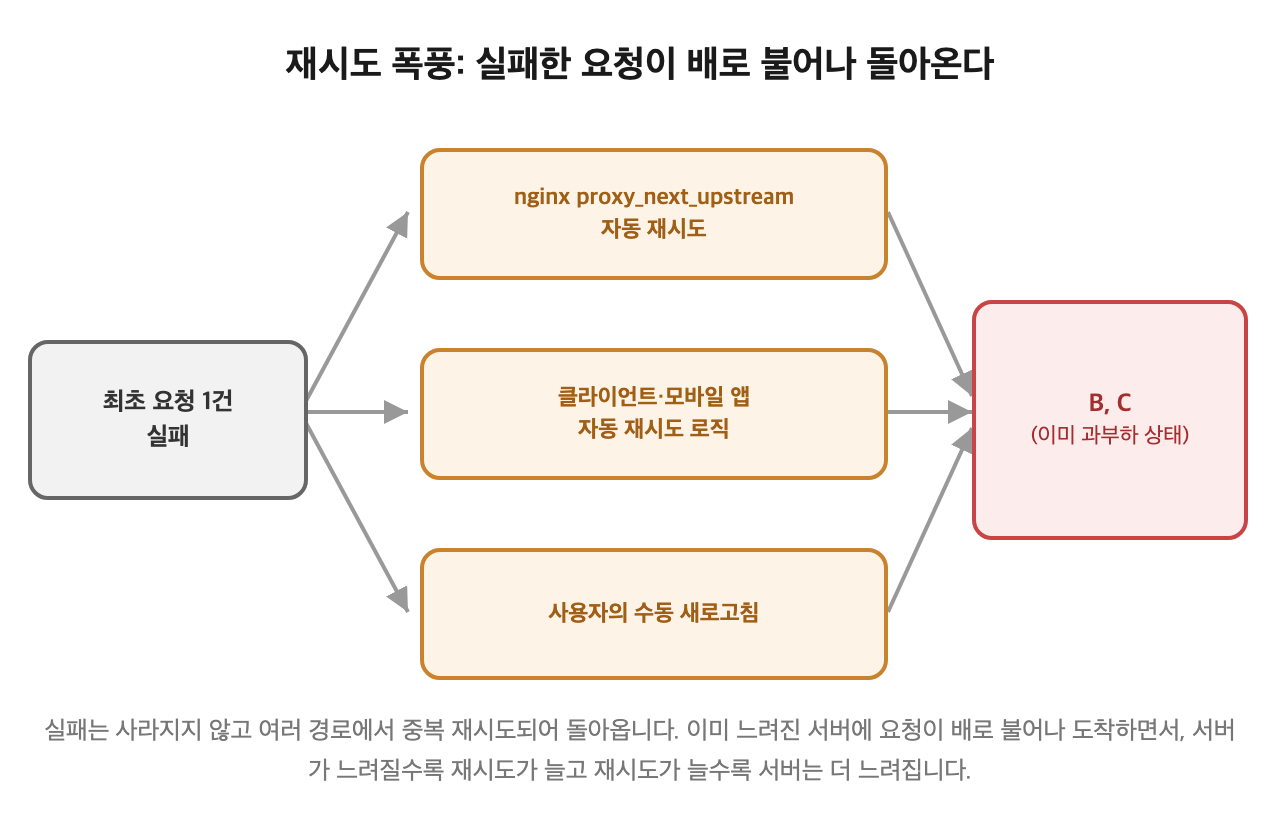
nginx의 자동 재시도, 클라이언트·모바일 앱의 재시도 로직, 사용자가 누르는 새로고침까지 — 실패는 사라지지 않고 이미 과부하 상태인 서버로 배가되어 돌아옵니다. 이 피드백 루프들이 계속 돌면 결국 스레드풀이 무한정 늘어나거나, 메모리가 바닥나 OOM killer가 개입하거나, GC pause가 너무 길어져 사실상 응답 불능 상태가 됩니다. 이 시점의 B, C는 앞서 A가 처했던 것과 같은 상태이고, nginx는 같은 passive health check로 B, C도 결국 down으로 판정합니다. 세 대 다 죽었으니 시스템 전체가 마비됩니다.
왜 앞단에서 거부하는 게 맞는가
"자원이 부족하면 패킷을 거부하면 될 텐데, 왜 굳이 트래픽을 받아들여 자원을 소비하는가"라는 앞의 질문에 이제 답할 수 있습니다.
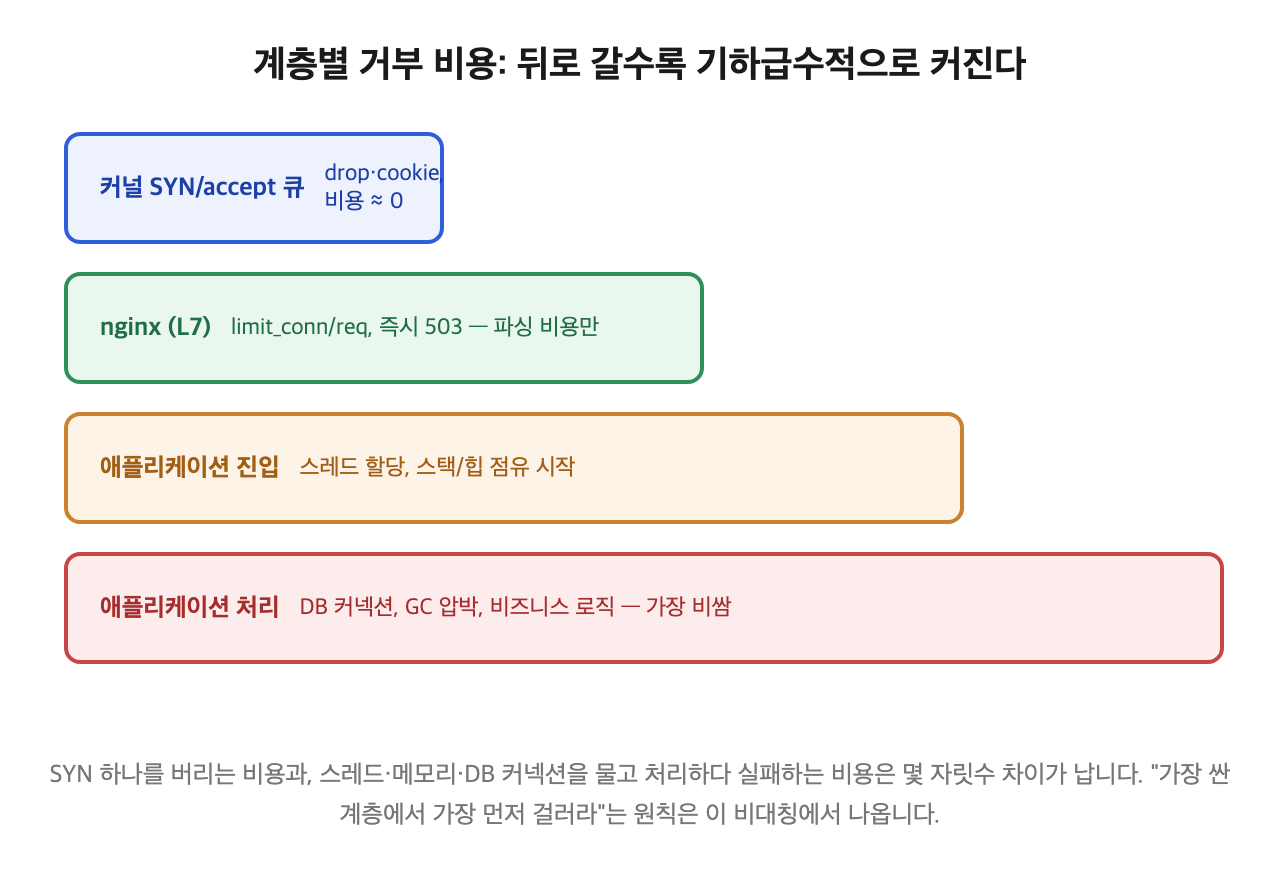
앞서 본 죽음의 소용돌이는 전부 이 그림의 맨 아래 칸(애플리케이션 처리)에서 벌어진 일입니다. SYN 하나를 커널이 버리는 비용은 거의 0에 가깝지만, 스레드를 할당하고 DB 커넥션을 물고 GC 압박까지 겪은 뒤에 실패하는 비용은 몇 자릿수 차이가 납니다. "CPU·메모리 사용률로 거부하자"는 발상은, 이미 이 표의 가장 비싼 칸까지 요청을 들여보낸 뒤에야 판단하겠다는 뜻입니다.
여기에 더해 CPU·메모리 사용률은 후행지표입니다. Little's Law의 피드백 루프가 상당히 진행된 뒤에야 관측되는 결과일 뿐이고, 그 지표를 확인하는 로직 자체도 CPU를 씁니다 — 정확히 자원이 궁할 때 판단 로직이 추가 부담이 되는 역설이 생깁니다. 게다가 CPU 사용률은 서버 전체의 총합이라, 지금 들어오려는 특정 연결과 인과관계가 있는지 알 수 없습니다. 반면 동시 연결 수, 스레드풀 대기열 길이 같은 지표는 선행지표입니다. 실제로 처리해보지 않고도, 그리고 이 트래픽과 인과관계가 명확한 채로 "이 요청까지 받으면 감당 범위를 넘어선다"는 걸 미리 압니다.
그래서 실제 시스템은 커널의 SYN/accept 큐 → nginx의 limit_conn/limit_req(503 즉시 응답) → 애플리케이션의 circuit breaker와 bounded 큐 순서로, 가능한 한 싼 계층에서 먼저 걸러내도록 설계됩니다. 503은 애플리케이션이 응답하다 실패한 게 아니라, 가장 앞단이 "지금은 못 받는다"고 저비용으로 명시적으로 선언하는 것에 가깝습니다.
인프라 확장: 앞단에 한 겹씩 붙인다
지금까지 본 문제 — nginx의 passive-only 헬스체크, fd 예산의 한계 — 를 실제 인프라 컴포넌트로 옮기면 이렇게 됩니다.
1단계: 전용 로드밸런서가 백엔드 라우팅을 넘겨받는다
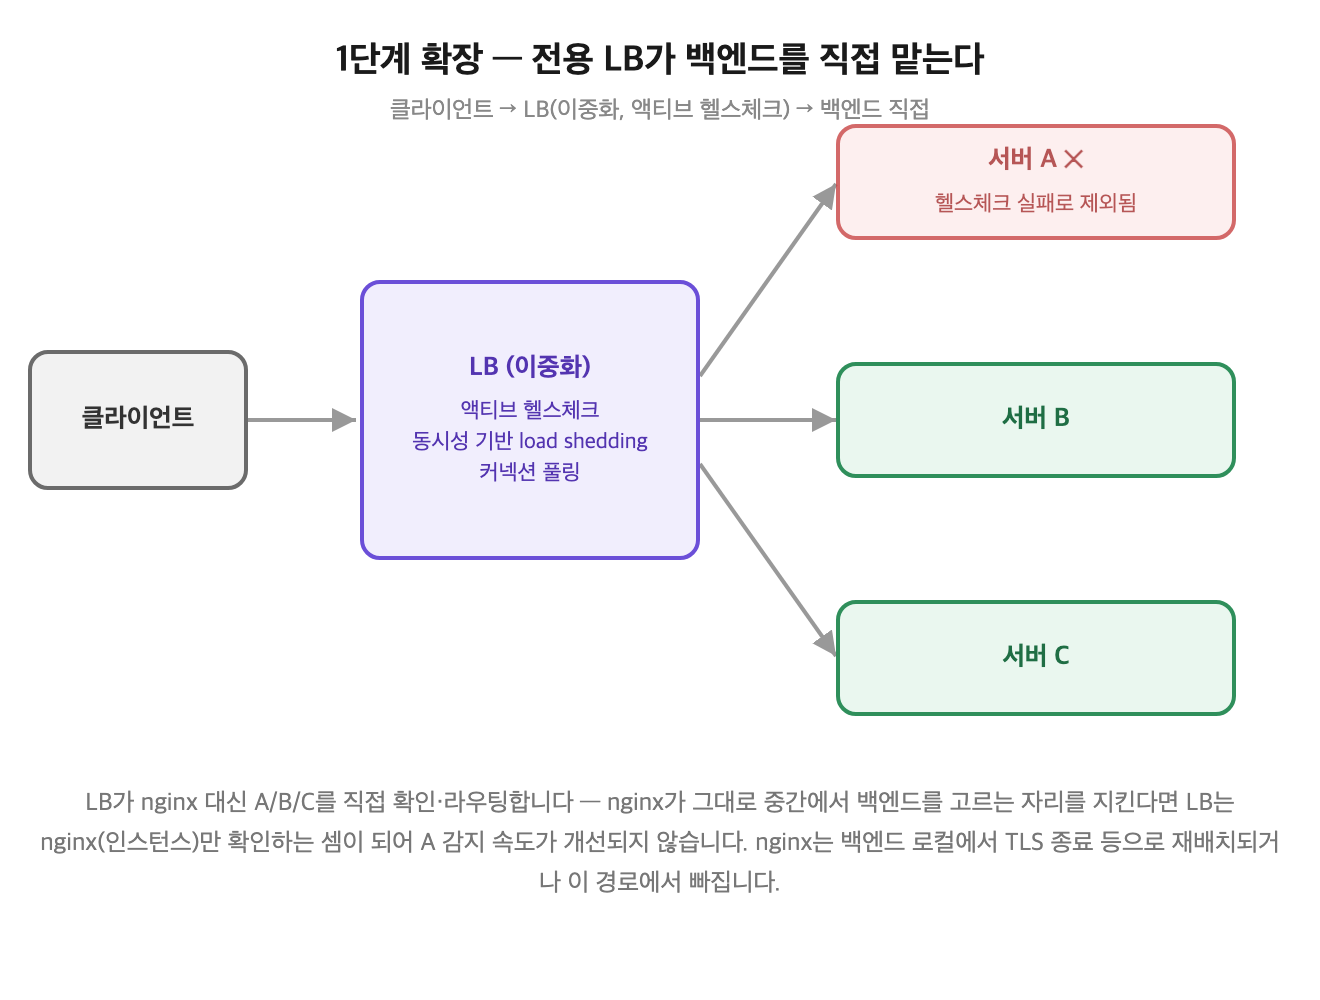
여기서 짚어야 할 게 있습니다. HAProxy, 클라우드 LB 같은 전용 LB를 "nginx 앞에 얹기만" 하면 아무것도 나아지지 않습니다. LB가 확인하는 대상이 nginx(또는 nginx 인스턴스들)라면, 그건 nginx 자체가 죽는 것에 대한 이중화일 뿐 A의 죽음과는 무관합니다 — A에 대한 헬스체크는 여전히 nginx의 upstream 모듈이 하고 있고, 오픈소스 nginx라면 여전히 passive-only이기 때문입니다.
실제로 뭔가 나아지려면 백엔드를 누구에게 보낼지 결정하는 역할 자체가 nginx에서 LB로 넘어가야 합니다. LB가 A, B, C를 직접 주기적으로(예: 2초마다) 확인하고 라우팅하면, 실제 트래픽이 실패하는 걸 기다릴 필요 없이 다음 헬스체크 실패만으로(연속 2~3회 정도, 짧으면 몇 초 안에) A를 풀에서 제외할 수 있어 앞서 본 감지 전 과도기의 이중 처리 문제가 크게 줄어듭니다. 이 경우 nginx는 백엔드를 고르는 자리에서 내려오고, 완전히 빠지거나 각 백엔드 로컬에서 TLS 종료·정적 자원 서빙 같은 국지적인 역할로 재배치되는 게 자연스럽습니다.
또한 LB 레벨에서 백엔드별 최대 동시 연결 수를 제한해두면, B·C가 감당 범위를 넘는 순간 초과분을 즉시 503으로 거부할 수 있습니다 — 죽음의 소용돌이가 아예 시작되지 않게 막는 셈입니다. LB와 백엔드 사이 연결을 keep-alive로 풀링해두면 백엔드의 fd 소비도 클라이언트 동시 접속 수가 아니라 풀 크기에 의해 상한이 걸립니다.
2단계: CDN/엣지(Cloudflare)까지 더한다
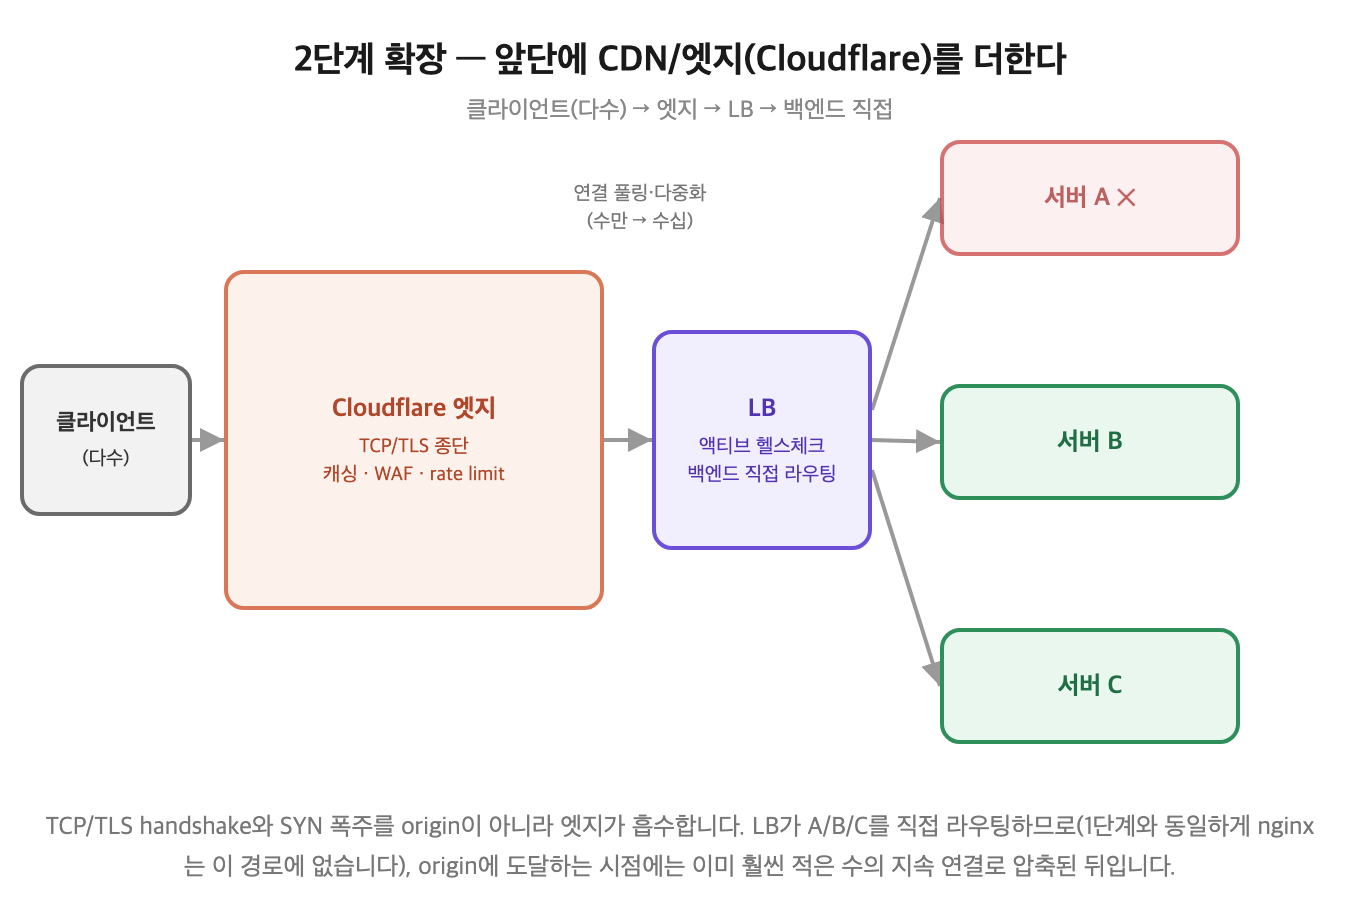
Cloudflare 같은 엣지는 클라이언트의 TCP·TLS handshake 자체를 origin이 아니라 전 세계에 분산된 엣지에서 종단합니다. 대량의 SYN 폭주가 와도 그걸 처음 받아내는 건 4대 서버가 아니라 엣지의 훨씬 큰 용량입니다. 클라이언트 수만 개의 연결도 엣지-오리진 구간에서는 HTTP/2 멀티플렉싱과 커넥션 풀로 훨씬 적은 수의 지속 연결로 압축되고, 정적 콘텐츠는 캐시에서 응답해 origin에 요청 자체가 가지 않습니다. 엣지 레벨 rate limit와 WAF는 악성·과도 트래픽을 origin 네트워크에 도달하기도 전에 차단합니다.
다만 이 계층들이 B, C의 실제 처리 용량 자체를 늘려주지는 않습니다. 이들이 하는 일은 거부·감지를 더 싸고 빠른 지점으로 옮기는 것이지, 처리 능력을 창조하는 게 아닙니다. A가 빠진 상태에서 B, C만으로 원래 트래픽 전부를 감당하는 게 애초에 불가능한 용량이라면, 아무리 앞단에서 잘 걸러내도 결국 스케일 아웃이나 우선순위 기반의 의도적인 저하 정책이 필요합니다.
정리
- TCP 서버는 연결을 SYN 큐 → accept 큐 순서로 받고, 두 큐 모두 거부 장치가 아니라 애플리케이션이 따라잡을 시간을 버는 완충재입니다. 진짜 천장은 애플리케이션의 스레드풀·fd·메모리에 있고, 이 천장은 대개 자원이 실제로 바닥나야 사후적으로 드러납니다.
- 서버 한 대가 죽으면 남은 서버들은 재분배된 부하를 받는데, 그 지연 증가가 Little's Law에 의해 동시성 폭증으로 이어지고, 메모리·GC 압박과 재시도 폭풍이 겹치며 스스로를 가속하는 피드백 루프에 들어갑니다.
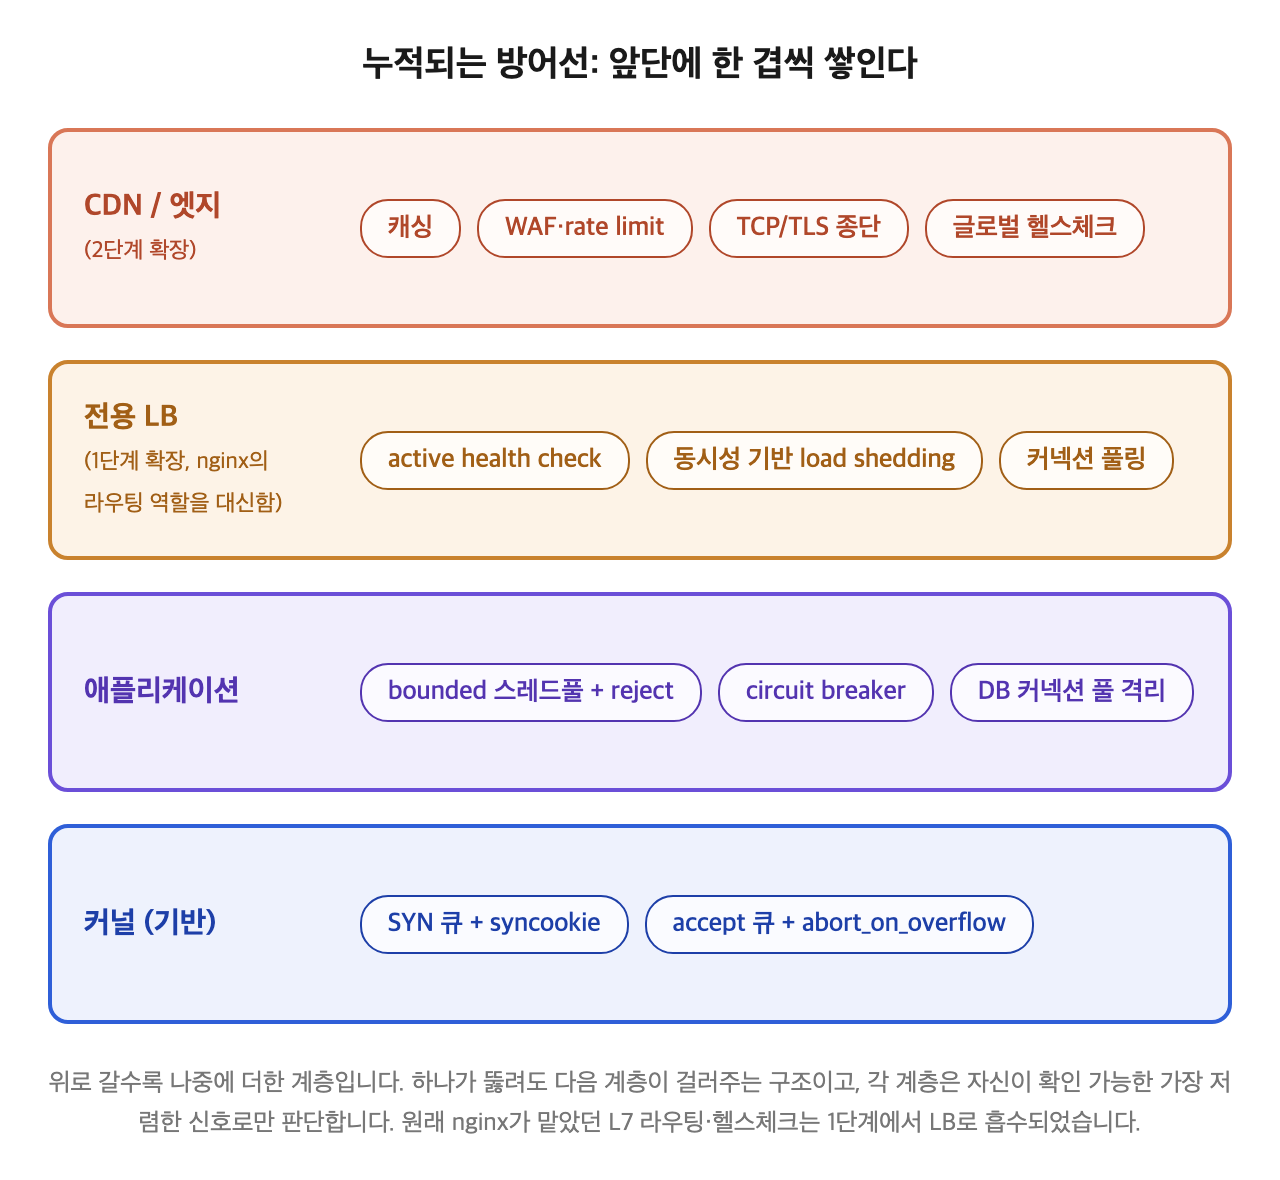
- CPU·메모리 사용률로 거부하는 방안이 널리 쓰이지 않는 이유는, 그 판단이 내려지는 시점에는 이미 비싼 자원을 소비한 뒤이고(비용 비대칭), 그 지표 자체가 후행지표라 대응이 항상 한발 늦기 때문입니다. 대신 큐 길이·동시 연결 수 같은 선행지표로, 가능한 한 싼 계층(커널 → nginx → circuit breaker)에서 먼저 거부합니다.
- 전용 로드밸런서와 CDN/엣지를 앞단에 추가하면 헬스체크가 능동적으로 바뀌고, 거부와 캐싱이 origin보다 훨씬 앞에서 일어나 방어선이 누적됩니다. 다만 이 계층들은 처리 용량을 늘려주는 게 아니라 거부·감지 지점을 옮겨줄 뿐이라, 근본적인 스케일 문제는 별개로 남습니다.
여기서 다룬 SYN 큐, handshake, 재전송 타이머는 전부 연결(connection)이라는 개념이 있기 때문에 존재하는 것들입니다. UDP에는 그 연결도, 큐도, 재전송도 없습니다. 그래서 UDP 기반 서비스의 폭주 대응은 이 글의 커널 부분과는 다른 이야기가 되지만, 애플리케이션 이후의 이야기 — 동시성 모델, Little's Law, 앞단에서 거부하는 게 싸다는 원칙 — 은 그대로 적용됩니다.