
지난 글에서 OpenSearch 하이브리드 검색을 다루면서 유클리드 거리, 코사인 유사도, 내적이라는 세 가지 공식을 짧게 소개하고 넘어갔습니다. 실무에서 space_type을 하나 골라 넣으면 동작은 하지만, 왜 세 가지나 존재하고 무엇을 기준으로 골라야 하는지는 다루지 못했습니다.
이 글에서는 그 질문을 처음부터 다시 짚어봅니다.
- 임베딩을 "점"이 아니라 "벡터"라고 부르는 이유
- 유사도를 판단할 때 실제로 보게 되는 세 가지 속성
- 세 척도가 각각 그중 무엇을 반영하는지, 그리고 서로 어떤 관계인지
- 정규화 여부에 따라 실무에서 척도를 고르는 기준
1. 점이 아니라 벡터라고 부르는 이유
임베딩 모델이 뱉어내는 결과물은 그냥 숫자 n개로 이루어진 좌표입니다. 수학적으로만 보면 이건 "점"이라고 불러도 전혀 틀리지 않습니다. 그런데 실무에서는 거의 예외 없이 "벡터"라는 단어를 씁니다.
점과 벡터는 좌표 표현은 똑같지만 허용되는 연산이 다릅니다. 점 하나만으로는 다른 점과의 거리를 재는 것 말고 할 수 있는 일이 없습니다. 반면 벡터는 원점을 기준으로 삼기 때문에 방향과 크기를 갖고, 덧셈·뺄셈·스칼라 곱 같은 대수 연산이 자연스럽게 정의됩니다.
이 차이가 단순한 용어 문제가 아니라는 걸 가장 잘 보여주는 예시가 word2vec의 그 유명한 연산입니다.
이 연산이 성립하려면 임베딩이 뺄셈과 덧셈이 정의된 벡터여야 합니다. 좌표를 그냥 "점"으로만 취급했다면 두 점 사이의 거리 말고는 의미 있게 할 수 있는 연산이 없어서, 애초에 이런 유추 자체가 성립할 수 없습니다. 임베딩 공간이 선형 연산(행렬 곱, 가중합)으로 구성되어 원점이 "아무 신호 없음"에 가까운 기준점 역할을 하기 때문에, 원점에서 뻗어나간 방향 자체가 의미를 담게 됩니다. 좌표계의 원점이 딱히 의미를 갖지 않는 데이터(예: GPS 위경도)에서는 이런 방향 비교가 성립하지 않는 것과 대비됩니다.
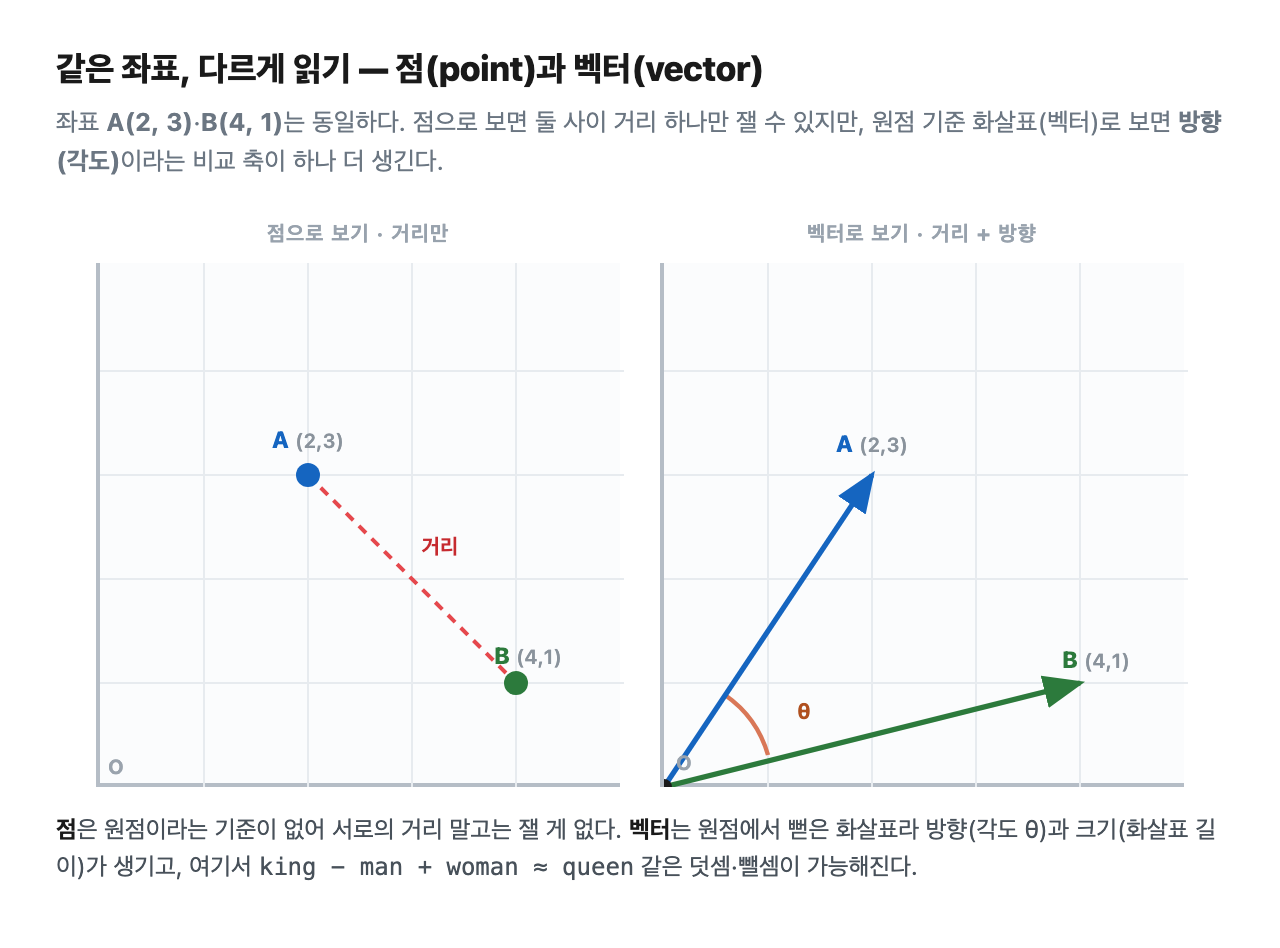
점으로만 보면 두 좌표 사이의 거리 하나만 잴 수 있지만, 원점을 기준으로 한 화살표(벡터)로 보면 거리 외에 "방향이 얼마나 비슷한가"라는 완전히 다른 축의 비교가 하나 더 생깁니다. 유사도 척도가 세 가지로 나뉘는 이유는 결국 이 추가된 축을 어떻게 다루느냐의 차이라고 생각합니다.
2. 유사도를 판단할 때 실제로 보는 세 가지 속성
두 임베딩을 비교할 때 볼 수 있는 속성은 사실 세 가지로 정리됩니다.
| 속성 | 의미 | 대응하는 척도 |
|---|---|---|
| 방향(direction) | 원점에서 봤을 때 두 벡터가 가리키는 각도가 얼마나 가까운가 | 코사인 유사도 |
| 방향 + 크기 | 각도뿐 아니라 벡터의 길이(norm)까지 반영하는가 | 내적 |
| 변위(displacement) | 두 벡터 끝점을 잇는 차 벡터()의 크기 자체 | 유클리드 거리 |
여기서 유클리드 거리도 사실은 벡터 연산이라는 점이 흥미롭습니다. 와 두 점의 거리는 라는 새로운 벡터를 만든 뒤 그 벡터의 크기(norm)를 재는 것과 같습니다. 즉 세 척도 모두 "벡터의 크기 또는 각도를 잰다"는 동일한 틀 안에 있고, 그중 무엇을 보느냐만 다릅니다.
3. 세 척도 뜯어보기
같은 두 벡터 , 를 grid 위에 올려두면, 세 척도가 각각 grid의 무엇을 읽어내는지가 눈에 보입니다.
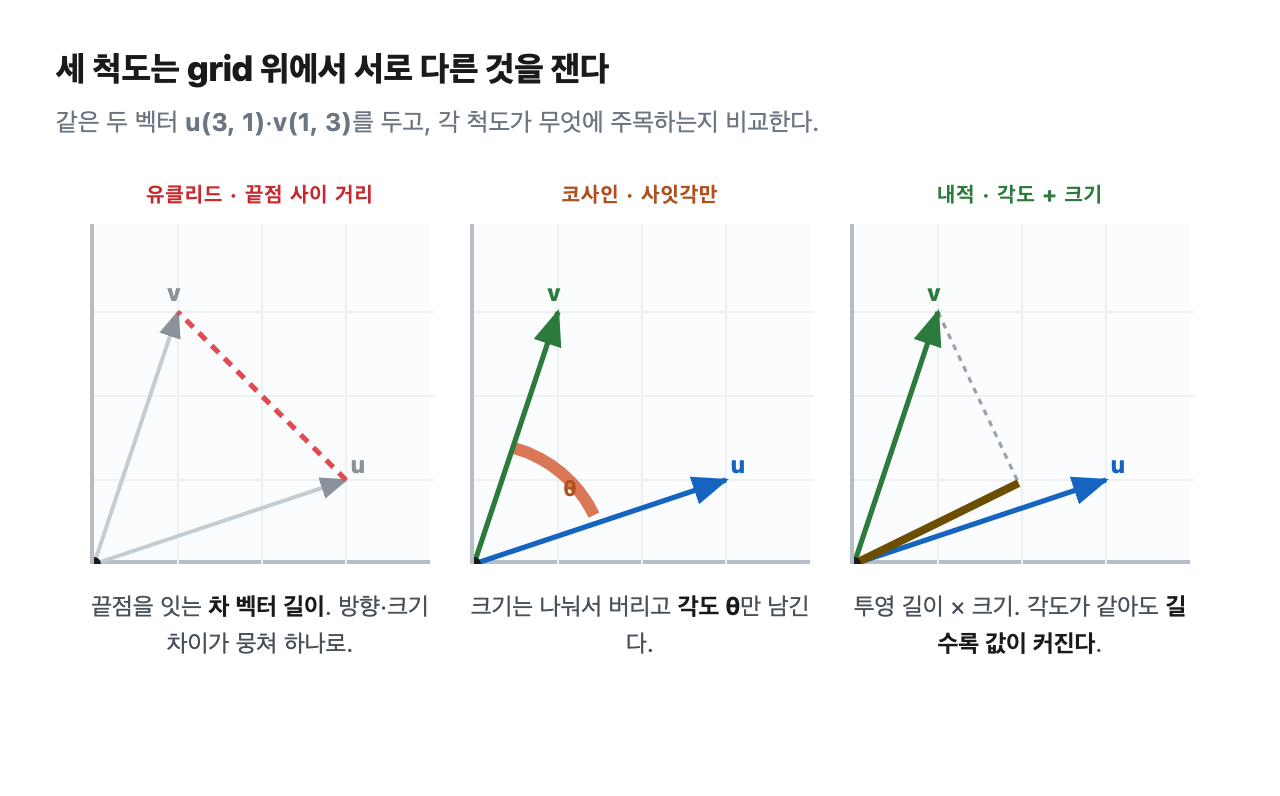
3-1. 유클리드 거리 — 방향과 크기 차이를 한꺼번에
차 벡터의 크기이므로 방향이 다른지, 크기가 다른지를 구분하지 않고 둘을 합쳐서 하나의 숫자로 냅니다. 두 벡터가 같은 방향이라도 크기가 다르면 거리는 0이 아닙니다.
3-2. 코사인 유사도 — 크기를 버리고 방향만
분모에서 두 벡터의 크기로 나눠버리기 때문에 크기 정보는 계산 과정에서 사라지고, 순수하게 각도만 남습니다. 범위는 (정반대) ~ (완전히 같은 방향)입니다.
3-3. 내적 — 방향과 크기를 둘 다
코사인 공식의 분모(정규화 항)를 제거한 형태라고 보면 됩니다. 그래서 값 자체에 두 벡터의 크기가 그대로 곱해져 들어갑니다. 방향이 같아도 크기가 큰 쪽이 더 높은 점수를 받습니다.
세 척도의 관계
유클리드 거리의 제곱을 내적으로 풀어보면 관계가 드러납니다.
만약 두 벡터가 단위 벡터로 정규화되어 이라면,
가 되어 유클리드 거리가 코사인 유사도의 단조 함수로 환원됩니다. 즉 벡터를 정규화한 상태에서는 유클리드 거리로 순위를 매기든 코사인 유사도로 순위를 매기든 결과가 완전히 같습니다.
4. 정규화가 셋을 하나로 묶는다, 그리고 갈라놓기도 한다
앞의 식이 말해주는 건 "정규화된 벡터에서는 세 척도가 사실상 하나"라는 것입니다. 벡터 DB들이 l2, cosine, inner product 중 아무거나 골라도 상관없다고 말하는 경우가 있는 건 이 전제(사전에 정규화된 임베딩) 위에서만 성립합니다.
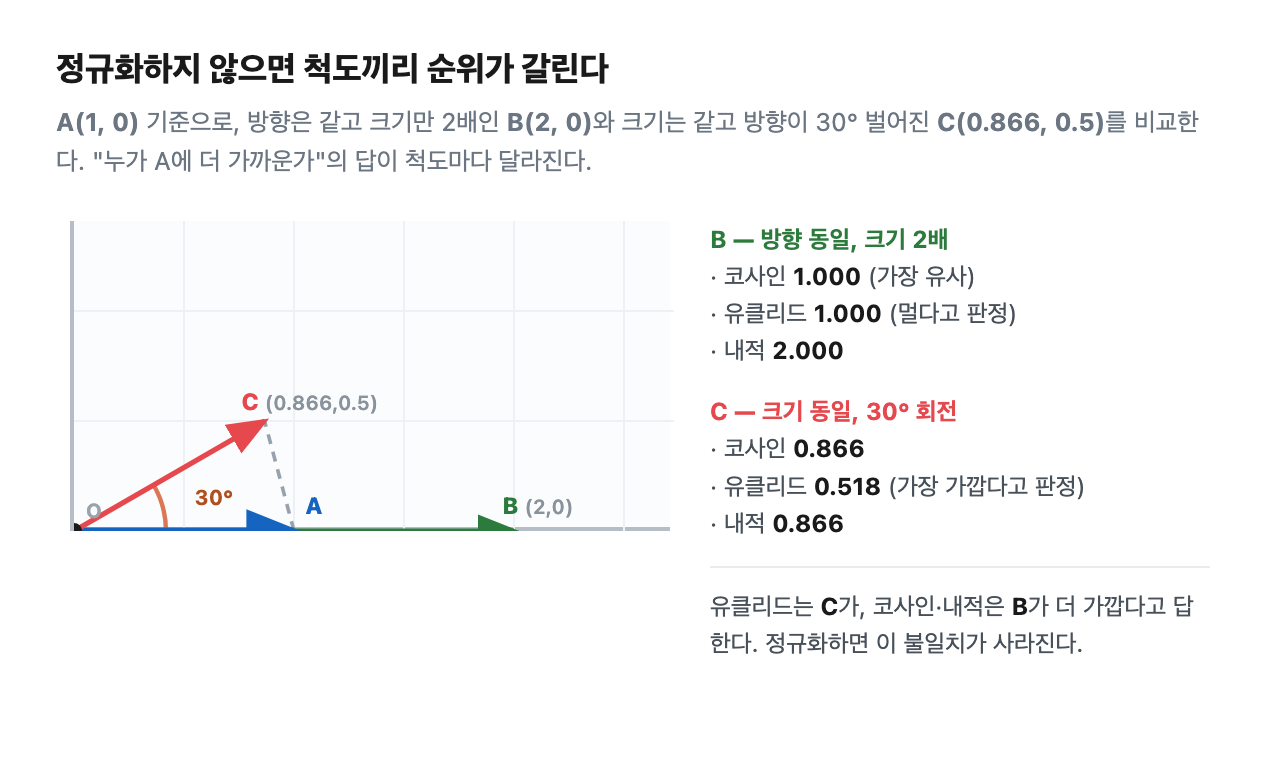
정규화하지 않은 벡터에서는 세 척도가 서로 다른 답을 낼 수 있습니다. 구체적인 숫자로 확인해보겠습니다.
- — 기준 문서
- — 와 방향은 완전히 같지만 크기만 2배 (예: 같은 내용을 좀 더 길게 쓴 문서)
- — 와 크기(norm)는 같지만 방향이 30도 벌어짐
import numpy as np

def euclidean(a, b):
    return np.linalg.norm(a - b)

def cosine(a, b):
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))

def inner_product(a, b):
    return np.dot(a, b)

A, B, C = np.array([1, 0]), np.array([2, 0]), np.array([0.866, 0.5])
| 비교 대상 | 유클리드 거리 | 코사인 유사도 | 내적 |
|---|---|---|---|
| (같은 방향, 다른 크기) | 1.000 | 1.000 | 2.000 |
| (다른 방향, 같은 크기) | 0.518 | 0.866 | 0.866 |
유클리드 거리만 보면 가 에 더 가깝다고 나옵니다(). 하지만 코사인 유사도는 정반대로 가 와 완전히 같은 방향이라며 더 유사하다고 판단합니다(). 내적도 코사인과 같은 결론을 내지만, 그 차이의 폭은 크기 항 때문에 훨씬 크게 벌어집니다( vs ).
NOTE와 가 "같은 의미인데 문서 길이만 길어서 임베딩 크기가 커진 상황"이라면, 코사인 쪽 판단이 실제 의도에 더 가깝다고 생각합니다. 반대로 벡터의 크기 자체가 인기도나 신뢰도처럼 의미 있는 신호로 학습된 모델이라면, 그 신호를 코사인이 지워버리는 셈이라 내적이 더 맞을 수 있습니다.
5. 실무에서 척도를 고르는 기준
- 임베딩 모델이 벡터의 크기(norm)에 의미를 실어 학습되었는가 → 그렇다면 내적. 크기 자체가 학습된 신호이므로 지우면 안 됩니다.
- 예시: 추천 시스템에서 사용자와 상품을 임베딩할 때, 사용자가 특정 장르를 얼마나 강하게 선호하는지를 벡터의 크기로 표현했다면, 정규화를 하면 '매우 좋아함'과 '조금 좋아함'의 차이가 소실됩니다. 이 경우에는 내적이 적합합니다(정규화 안 함).
- 문서 길이 등 부수적인 이유로 크기가 흔들리는 텍스트 임베딩인가 → 코사인. 크기를 버리고 방향(의미)만 비교합니다.
- 예시: "자동차"와 "자동차 사진"은 표현의 길이는 다르지만 의미 자체는 매우 가깝습니다. OpenAI의 text-embedding-3 처럼 의미적 유사성을 목적으로 학습된 임베딩에서는 두 백터의 방향이 중요하므로 코사인 유사도를 사용합니다(해당 모델은 출력자체에 정규화를 미리 적용합니다).
- 좌표 자체가 절대적인 의미를 갖는 저차원 데이터인가(위치 좌표 등) → 유클리드. 애초에 원점 기준 방향이라는 개념이 무의미한 경우입니다.
- 예시: 최근 텍스트 임베딩에서는 흔하지 않지만, FaceNet처럼 유클리드 거리가 가까운 임베딩 공간을 만들도록 학습한 모델은 유클리드 거리를 사용합니다. 반대로 ArcFace처럼 코사인 유사도를 기준으로 학습한 모델은 코사인 유사도를 사용합니다.
무엇을 고르든, 사용하려는 임베딩 모델이 어떤 척도를 기준으로 학습되었는지 먼저 확인하는 게 순서라고 생각합니다. OpenSearch나 다른 벡터 DB에서 space_type을 정하는 것도 결국 이 확인 작업 하나로 좁혀지는 문제입니다.
WARNING
유클리드 거리는 일반적인 텍스트 임베딩에서는 많이 사용되지 않습니다. 다만 FaceNet 처럼 L2 Distance를 최소화하도록 학습한 임베딩 모델에서는 유클리드 거리를 사용하는 것이 적합합니다.
정리
- 임베딩을 벡터라고 부르는 건 관용적 표현이 아니라, 원점을 기준으로 한 방향·크기 연산(word2vec의 유추 연산 같은)이 실제로 성립하기 때문입니다.
- 유클리드 거리, 코사인 유사도, 내적은 각각 변위·방향·방향+크기 중 무엇을 반영하는지로 구분됩니다.
- 벡터를 정규화하면 세 척도의 순위가 일치하지만, 정규화하지 않으면 크기가 큰 벡터가 척도에 따라 유리해지거나 불리해지는 결과가 갈립니다.