
OpenSearch로 하이브리드 검색 구현하기에서 HNSW를 다루면서 파라미터 튜닝과 필터링 문제까지는 짚었지만, HNSW 자체가 어떤 원리로 동작하는지, kNN과 ANN이 정확히 어떻게 다른지, HNSW 이전에 NSW라는 구조가 있었다는 것, 그리고 HNSW가 감당하지 못하는 규모에서는 무엇을 쓰는지는 다루지 않았습니다. 이 글에서는 그 빈 부분을 채웁니다.
1. kNN과 ANN의 관계
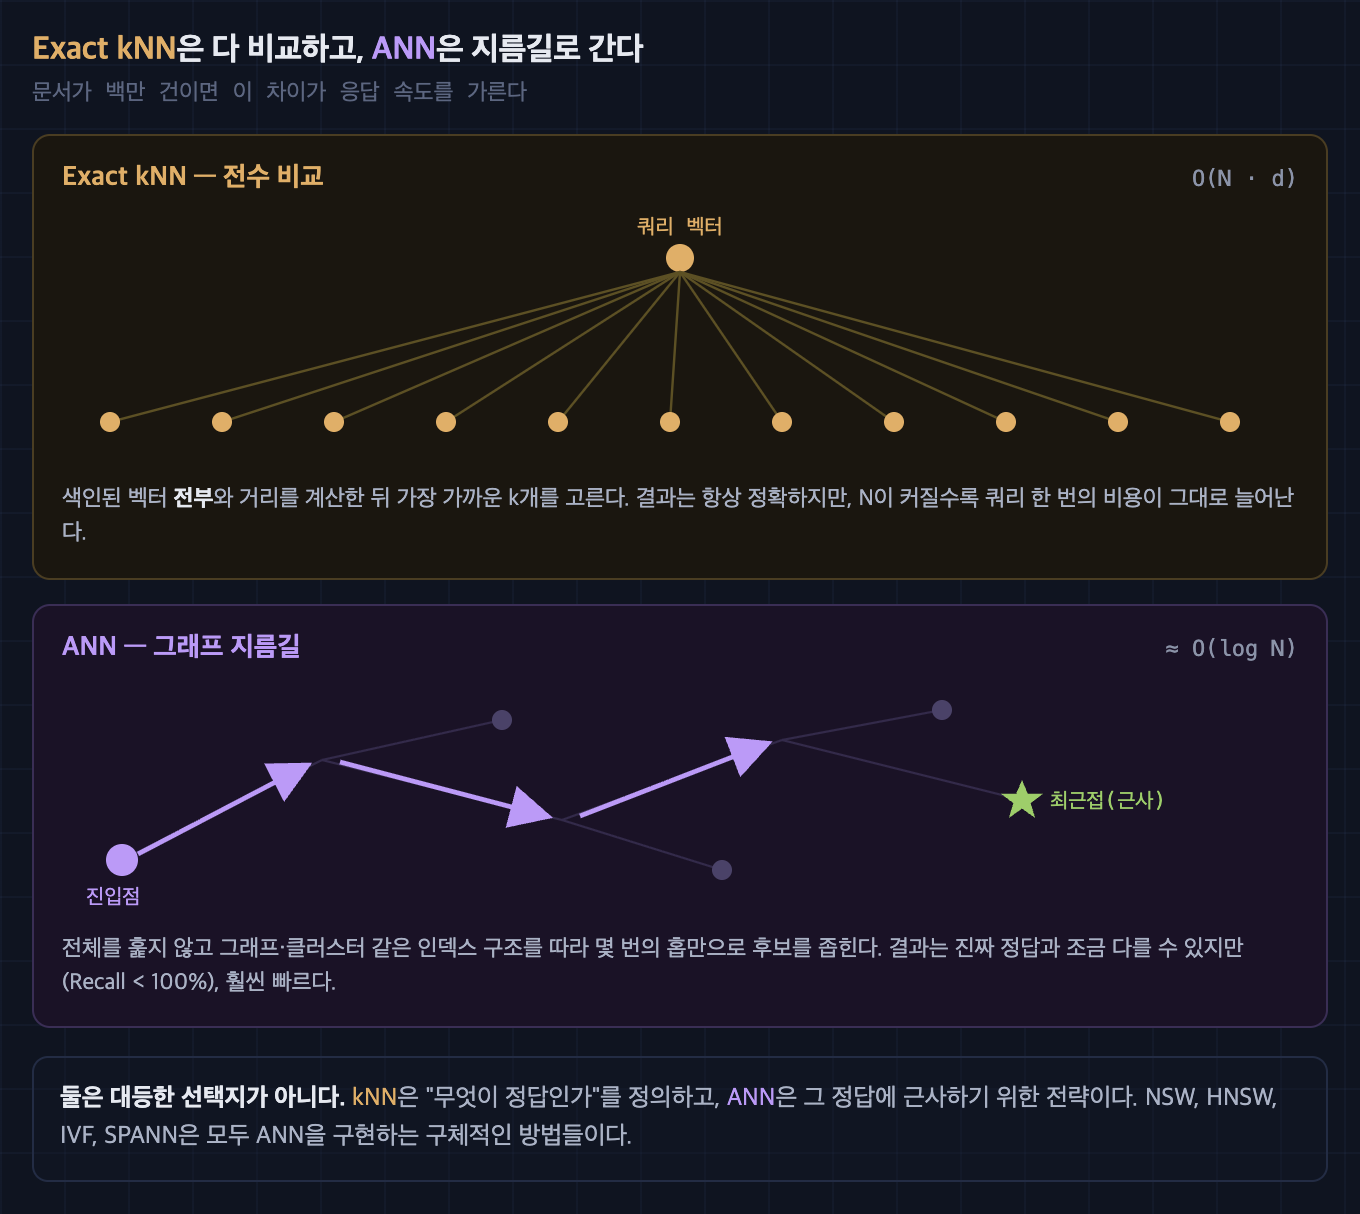
kNN(k-Nearest Neighbor)은 쿼리 벡터와 색인된 모든 벡터 사이의 거리를 하나하나 계산해서 가장 가까운 k개를 반환하는 방식입니다. 흔히 브루트포스(brute-force) 또는 exact kNN이라고 부릅니다.
- : 색인된 벡터의 개수
- : 벡터의 차원 수
문서가 수만 개 수준이면 이 방식도 충분히 빠릅니다. 하지만 수백만~수십억 개 규모로 늘어나면 쿼리 한 번에 전체를 훑는 비용이 감당이 안 됩니다. ANN(Approximate Nearest Neighbor)은 이 문제에 대한 답으로, 진짜 top-k 대신 "충분히 가까운" top-k를 훨씬 빠르게 찾는 알고리즘 계열을 가리킵니다.
그래서 kNN과 ANN은 같은 층위에서 비교할 대상이 아닙니다. kNN은 "무엇이 정답인가"를 정의하는 문제이고, ANN은 그 정답에 가깝게 근사하기 위한 자료구조·알고리즘 전략입니다. HNSW, NSW, IVF, SPANN은 전부 ANN을 구현하는 구체적인 방법들입니다.
| 구분 | Exact kNN | ANN |
|---|---|---|
| 반환 결과 | 항상 정확한 top-k | 정확한 top-k에 근접한 결과 (Recall < 100% 가능) |
| 시간복잡도 | , 데이터 규모에 선형 비례 | 대부분 근사 |
| 메모리 | 원본 벡터만 있으면 됨 | 그래프·클러스터 등 추가 인덱스 구조 필요 |
| 적합한 규모 | 수만 건 이하, 또는 필터로 후보가 크게 줄어든 경우 | 수백만 건 이상 |
NOTEOpenSearch도 두 방식을 모두 제공합니다.
exactkNN은 필터를 먼저 태워 후보가 적을 때 자동으로 선택되는 경로이고, HNSW 기반 ANN은 필터 없이 전체 공간을 검색할 때 쓰는 기본 경로입니다. 이전 글의 5장에서 다룬 "필터 대상이 매우 적을 때 엔진이 알아서 Exact Search로 우회한다"는 설명이 바로 이 두 방식의 전환입니다.
2. NSW — 그래프를 걸어서 가까운 이웃을 찾는다는 아이디어
NSW(Navigable Small World)는 벡터 하나하나를 노드로 두고, 노드를 삽입할 때 이미 그래프에 있는 노드 중 가까운 것들과 간선을 연결해 나가는 구조입니다. 삽입 초반에는 그래프가 성겨서 먼 노드끼리도 연결이 되고(장거리 간선), 그래프가 촘촘해질수록 가까운 노드끼리의 연결(단거리 간선)이 늘어납니다. 이 두 종류의 간선이 섞이면서 "몇 번만 건너뛰면 어디든 도달할 수 있는" 작은 세상(small-world) 성질이 생깁니다.
탐색은 그리디(greedy) 방식입니다. 임의의 진입점에서 시작해서, 현재 노드의 이웃 중 쿼리 벡터에 더 가까운 노드가 있으면 그쪽으로 이동하고, 없으면 탐색을 멈춥니다.
WARNING여기서 "그리디"는 Dijkstra가 아닙니다. Dijkstra는 출발점부터의 누적 경로 비용을 기준으로 그래프 전체를 체계적으로 넓혀가며 최단 경로를 보장하는 알고리즘입니다. 반면 이 그리디 탐색은 매 걸음마다 "현재 노드의 이웃이 쿼리 벡터와 얼마나 가까운가"만 보고 더 가까운 쪽으로 한 번 이동할 뿐, 되돌아가거나 다른 경로를 다시 시도하지 않습니다. 경로 비용을 누적하지 않고 목표까지의 거리만 보고 움직인다는 점에서 A*에서 경로 비용 항을 버리고 휴리스틱만 쓰는 것과 비슷한 그리디 최선 우선 탐색(Greedy Best-First Search)에 가깝고, 최단 경로를 전혀 보장하지 않습니다. 바로 아래에서 다룰 지역 최적점 문제는 이 "보장 없음"의 직접적인 결과입니다.
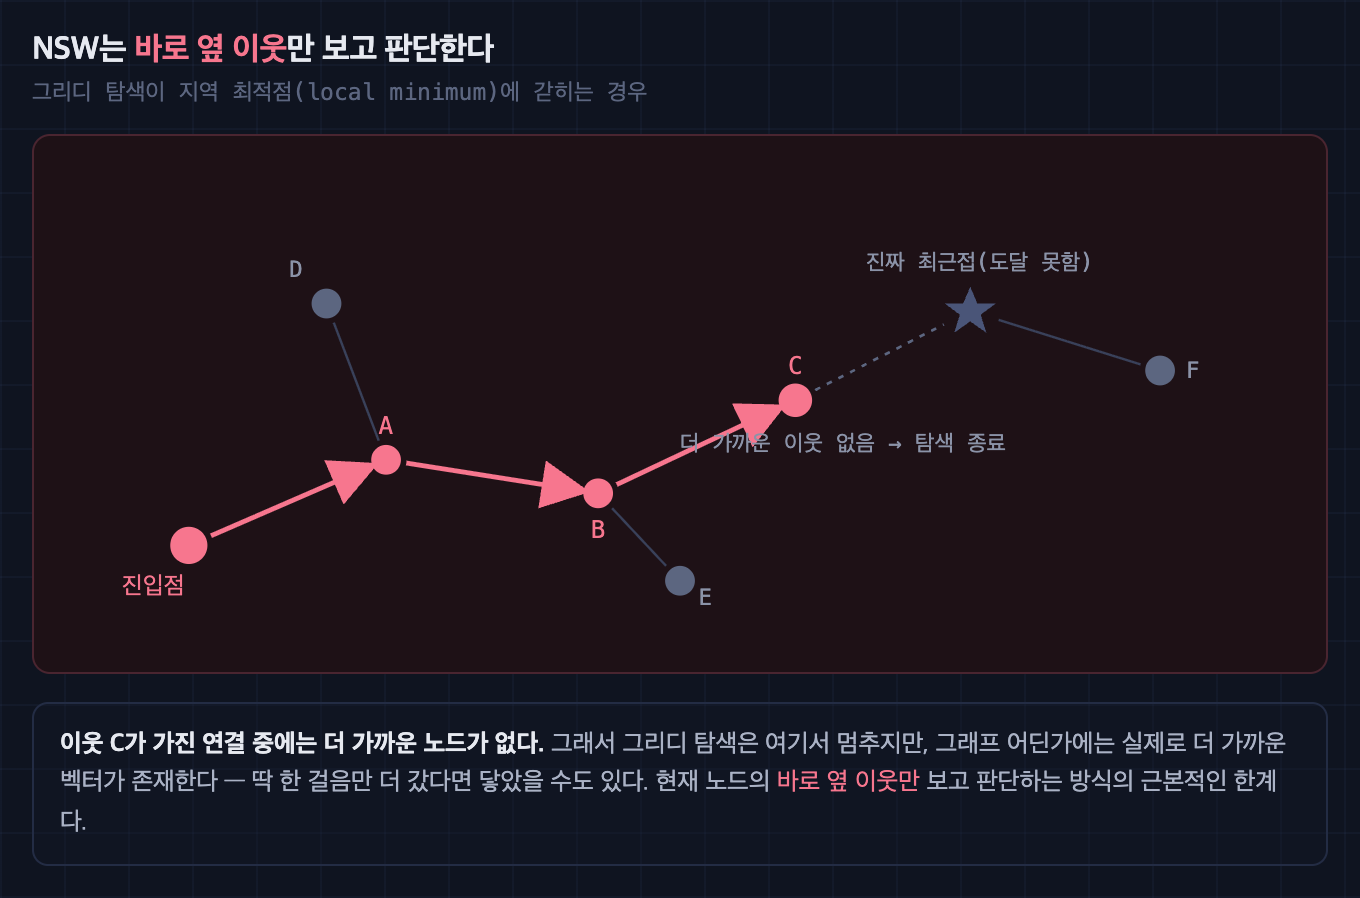
문제는 이 그리디 탐색이 지역 최적점(local minimum)에 갇히기 쉽다는 점입니다. 위 그림처럼 이웃 C가 가진 연결들 중에는 더 가까운 노드가 없어서 탐색이 멈추지만, 그래프 어딘가에는 실제로 더 가까운 벡터가 존재할 수 있습니다. 특히 그래프 초반에 삽입된 노드일수록 연결(간선)이 몰리는 허브가 되는 경향이 있어서, 탐색 경로가 이런 허브에 편중되고 결과 품질이 삽입 순서에 따라 들쭉날쭉해지는 경향이 있습니다.
3. HNSW — NSW를 층으로 쌓아 지역 최적점 문제를 완화한다
HNSW(Hierarchical NSW)는 이름 그대로 NSW 그래프를 여러 층으로 쌓은 구조입니다. 이전 글에서 다룬 고속도로·골목길 비유를 다시 가져오면, 이번에는 "왜 층을 나누는가"에 초점을 맞춥니다.
노드를 삽입할 때마다 그 노드가 몇 층까지 존재할지 확률적으로 정합니다. 층이 올라갈수록 배정될 확률이 지수적으로 낮아지기 때문에, 최상위 층에는 극소수의 노드만 남고 최하위 층(Layer 0)에는 전체 노드가 다 존재합니다. 결과적으로 위층은 노드 간 거리가 멀어 몇 번의 이동만으로 그래프 전체를 가로지를 수 있는 고속도로가 되고, 아래층으로 내려갈수록 촘촘한 골목길이 됩니다.
새 노드가 삽입되는 과정을 조금 더 구체적으로 보면 다음과 같습니다.
-
최상위 레벨 뽑기: 노드가 들어올 때마다 그 노드가 도달할 최상위 레벨 을 확률적으로 뽑습니다. 흔히 쓰는 방식은 지수분포입니다.
가 1에 가까운 흔한 경우엔 이 되고, 가 0에 아주 가까운 드문 경우에만 이 커집니다. 은 층별 노드 밀도를 조절하는 정규화 상수입니다.
-
모든 하위 층에 동시에 삽입: 이렇게 뽑힌 은 그 노드가 존재하는 유일한 층이 아니라, 0층부터 층까지 전부에 그 노드가 들어간다는 뜻입니다. 즉 상위 층의 노드는 하위 층에도 중복으로 존재합니다 — Layer 0에는 예외 없이 모든 노드가 있고, Layer 1에는 로 뽑힌 노드만, Layer 2에는 로 뽑힌 극소수만 존재하는 식입니다.
-
층마다 간선 연결: 그 노드가 속하는 층 각각(0층부터 층까지)에서, 이미 그 층에 있는 노드들 사이를 그리디하게 탐색해 가까운 후보를
ef_construction개까지 넓혀서 찾고, 그중 가장 가까운 개와 간선을 연결합니다.
즉 ef_construction은 그래프를 한 번 만들 때 드는 비용이 아니라, 노드가 삽입될 때마다 그 노드가 속한 층 수만큼 반복해서 드는 비용입니다.
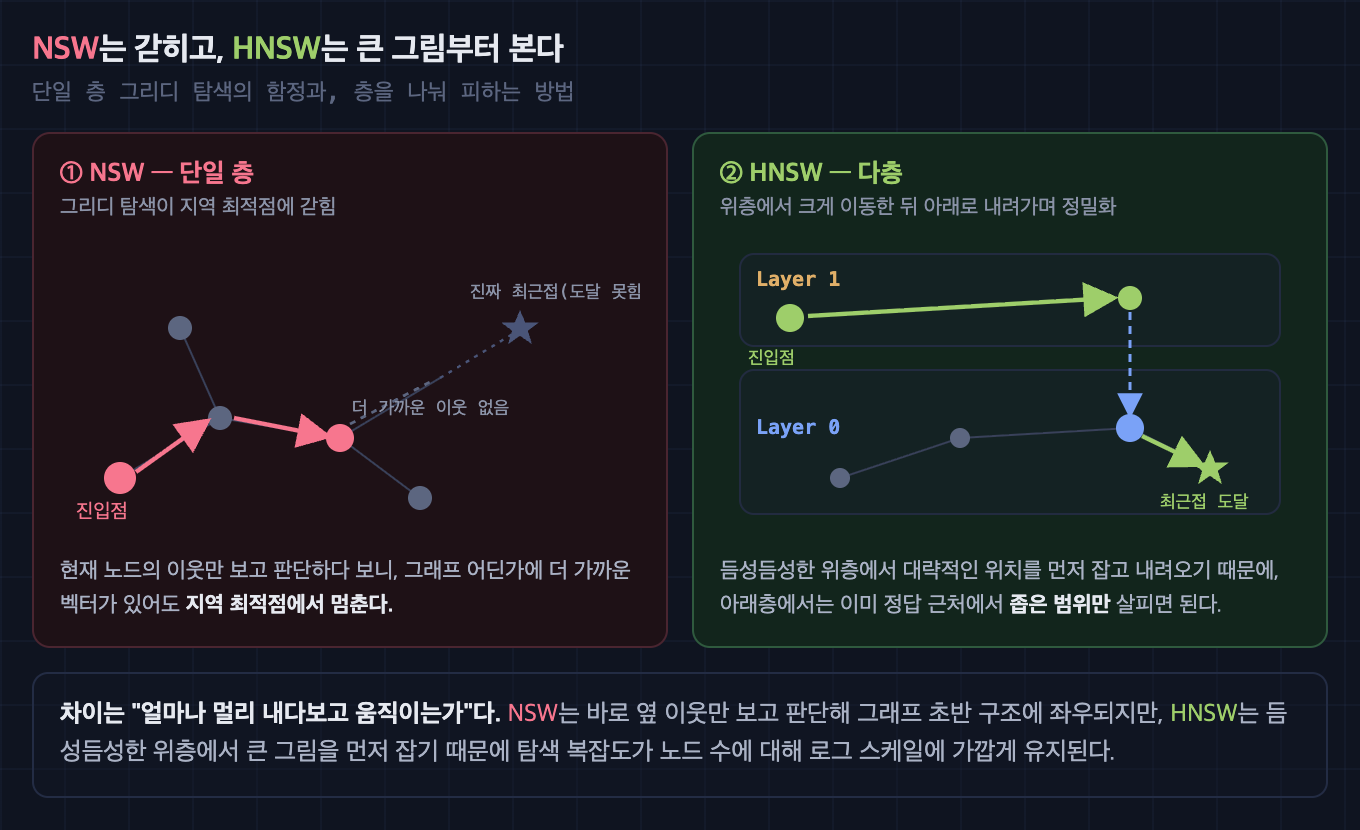
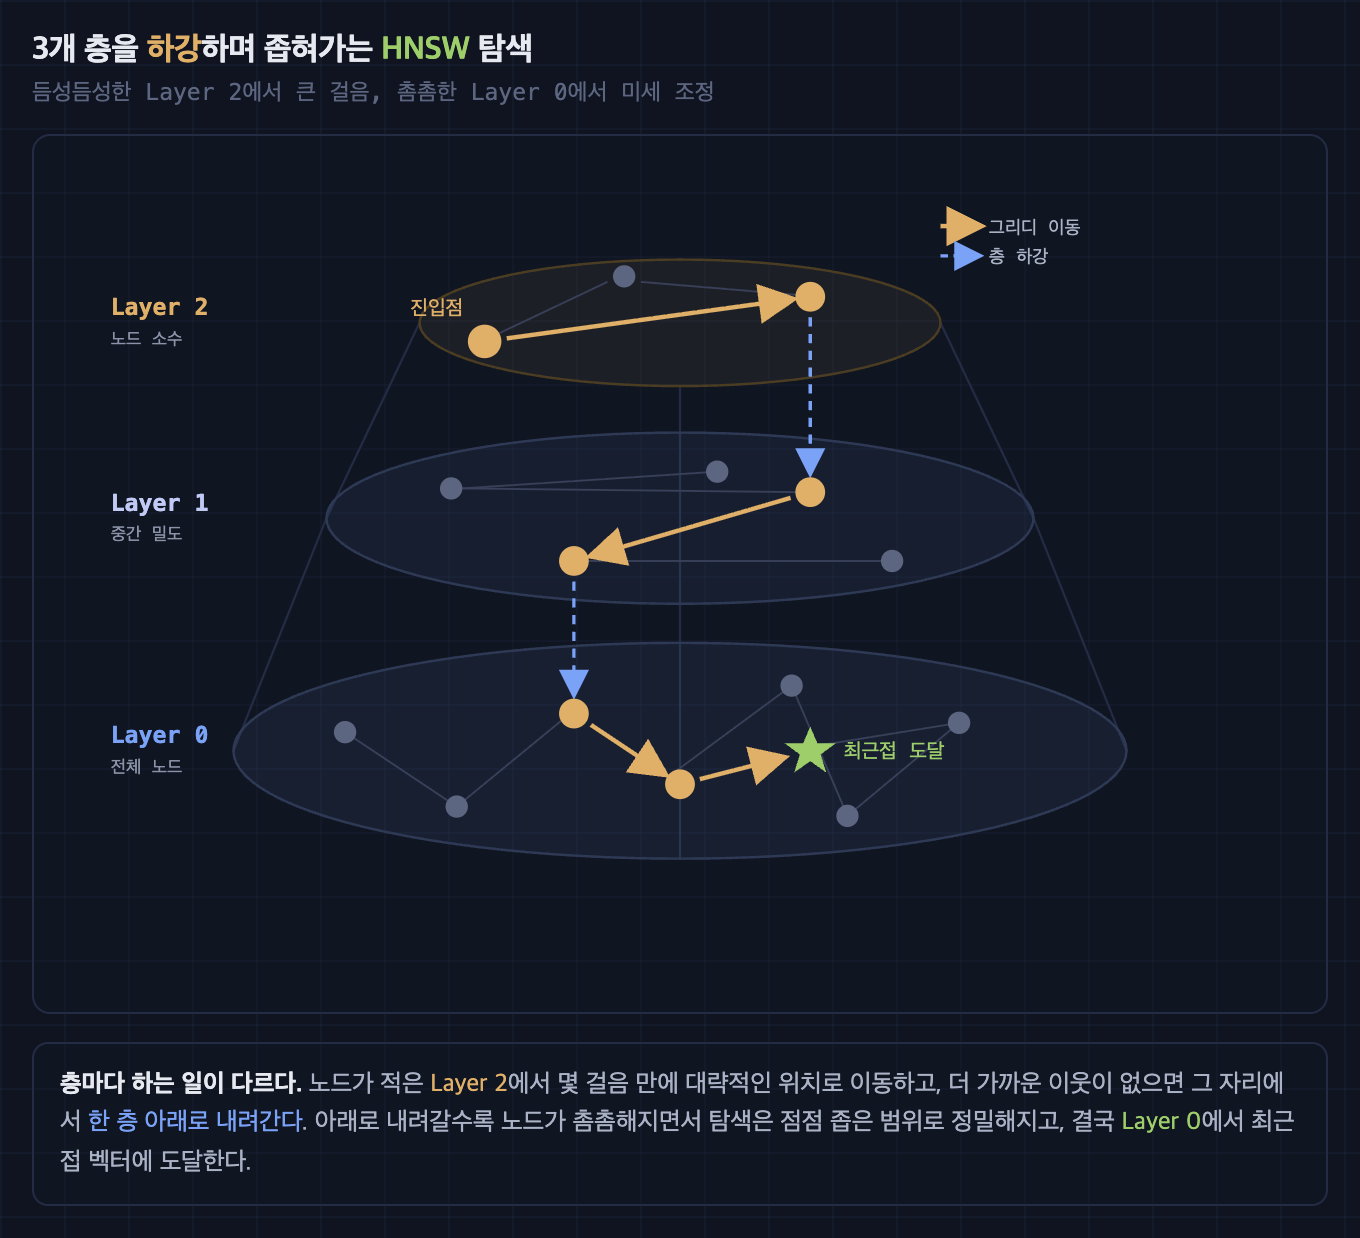
탐색은 최상위 층의 진입점에서 시작해 그리디하게 이동하다가, 더 가까운 이웃이 없으면 한 층 아래로 내려가는 과정을 반복합니다. 위층에서 큰 보폭으로 대략적인 위치를 잡아두고 내려오기 때문에, 최하위 층에서는 이미 정답 근처에 도달해 있어 좁은 범위만 정밀 탐색하면 됩니다. NSW가 단일 층에서 그리디 탐색만으로 지역 최적점에 갇히던 것과 달리, HNSW는 상위 층에서 큰 그림을 먼저 잡고 내려오기 때문에 탐색 복잡도가 노드 수에 대해 로그 스케일에 가깝게 유지됩니다.
층을 3개로 두고 이 하강 과정을 입체적으로 그리면 다음과 같습니다.
이전 글에서 다룬 파라미터도 이 구조 위에서 다시 보면 역할이 분명해집니다.
- (간선 수): 각 층에서 노드 하나가 유지하는 링크 수. 층의 "밀도"를 결정합니다.
ef_construction: 삽입 시 각 층에서 연결할 이웃을 찾기 위해 몇 개의 후보까지 넓혀서 탐색할지. (노드가 삽입될 때마다, 그 노드가 속한 층 수만큼 반복해서 드는 비용)ef_search: 질의 시 최하위 층(주로 Layer 0)에서 얼마나 넓게 후보를 유지하며 탐색할지. (검색 쿼리 하나마다 드는 비용)
4. HNSW의 벽 — 그래프가 램에 다 올라가야 한다
HNSW는 정확도와 속도의 균형이 좋지만, 전제 조건이 하나 있습니다. 그리디 탐색이 빠르려면 그래프 전체(모든 노드와 간선)가 램(RAM)에 상주해야 합니다. 노드 수가 수억~수십억 개로 늘어나면 그래프 자체가 램 용량을 초과해서, HNSW를 그대로 쓰기 어려워집니다.
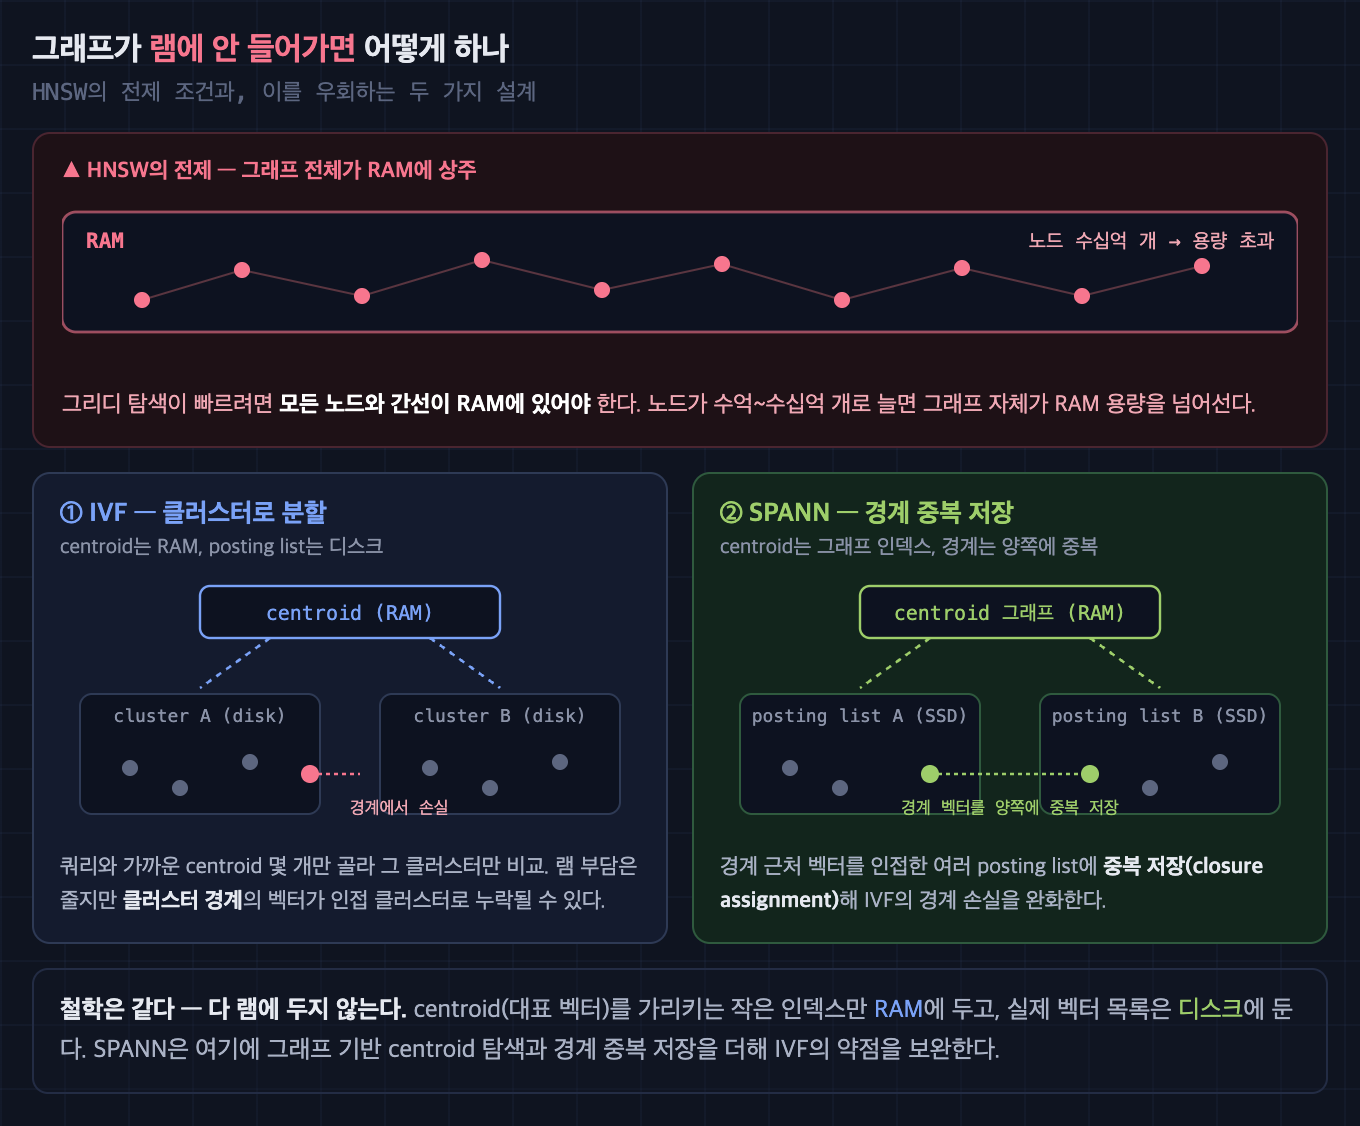
IVF(Inverted File Index)는 다른 접근입니다. 벡터 공간을 미리 몇 개의 클러스터로 나누고(각 클러스터를 대표하는 centroid를 학습), 쿼리가 들어오면 가장 가까운 centroid 몇 개만 골라 그 클러스터에 속한 벡터들만 비교합니다. 클러스터별 벡터 목록(posting list)은 디스크에 둘 수 있어 램 부담이 훨씬 적지만, 클러스터 경계에 걸쳐 있는 벡터가 인접 클러스터로 빠지면서 결과가 누락되는 경계 문제가 있습니다.
SPANN은 이 경계 문제를 완화하면서 IVF보다 정확한 centroid 탐색을 노리는 billion-scale ANN 인덱스입니다. 철학은 IVF와 비슷합니다 — "실제 벡터 목록(posting list)은 SSD에 두고, centroid를 가리키는 작은 인덱스만 램에 둔다"는 2단계 구조입니다. 다만 centroid를 찾는 이 작은 인덱스 자체를 그래프 기반 구조로 구성해 탐색 정확도를 높이고, 클러스터 경계 근처의 벡터는 하나의 클러스터가 아니라 인접한 여러 클러스터의 posting list에 중복으로 넣어(closure assignment) 경계에서 결과가 새는 문제를 줄입니다.
| 구분 | HNSW | IVF | SPANN |
|---|---|---|---|
| 인덱스 위치 | 그래프 전체가 램에 상주 | centroid는 램, posting list는 디스크 가능 | centroid 그래프는 램, posting list는 SSD |
| 정확도(Recall) | 높음 | 클러스터 경계에서 손실 발생 | 경계 벡터 중복 저장으로 손실 완화 |
| 적합 규모 | 수천만 건 내외, 램 여유 있을 때 | 수억 건 이상 | 수십억 건 규모 |
WARNINGSPANN은 아직 OpenSearch가 기본 제공하는 kNN 엔진(Lucene, Faiss, NMSLIB)에는 포함되어 있지 않습니다. 여기서는 HNSW·IVF가 램 앞에서 부딪히는 벽과, 그 벽을 넘기 위한 설계 방향을 이해하기 위한 배경 지식으로 다뤘습니다.
정리
- kNN과 ANN: 대등한 두 선택지가 아니라, "정확한 정답의 정의(kNN)"와 "그 정답에 근사하는 전략(ANN)"의 관계입니다.
- NSW → HNSW: 단일 층 그래프의 그리디 탐색이 지역 최적점에 갇히는 문제를, 층을 나눠 위에서 큰 보폭으로 훑고 아래로 내려오는 구조로 완화한 것이 HNSW입니다.
- HNSW의 다음 벽: 그래프를 통째로 램에 올려야 한다는 제약을 넘어서기 위해 IVF, SPANN 같은 메모리-디스크 분리 구조가 나왔습니다.
이 알고리즘들이 실제 서비스에 붙었을 때 어떤 파라미터 튜닝과 필터링 문제로 이어지는지는 OpenSearch로 하이브리드 검색 구현하기에서 다뤘습니다.