
정렬키·part·파티셔닝
🔍 ClickHouse 스터디 시리즈
개요
1편에서 컬럼 지향 저장과 MergeTree 정렬키의 기초를 봤습니다. 이번 글에서는 정렬키가 실제로 "읽을 양"을 어떻게 줄이는지
EXPLAIN으로 해부하고, 그 과정에서 만나는 part·merge·파티셔닝까지 다룹니다. 모든 수치는 5천만 행을 적재한 로컬 ClickHouse에서 측정한 값입니다.
정렬키를 바꾸면 무엇이 달라지나
1편에서 events 테이블(정렬키 (event_type, ts))에 WHERE country = 'KR'을 걸면 5천만 행을 전부 스캔했습니다. country가 정렬키가 아니었기 때문입니다.
그럼 country를 정렬키 맨 앞으로 올린 쌍둥이 테이블을 만들어 비교해봅니다.
CREATE TABLE events_by_country
(
    ts DateTime,
    user_id UInt32,
    event_type LowCardinality(String),
    country LowCardinality(String),
    duration_ms UInt32
)
ENGINE = MergeTree
ORDER BY (country, ts);

INSERT INTO events_by_country SELECT * FROM events;
같은 데이터, 같은 쿼리를 던집니다.
SELECT count() FROM events_by_country WHERE country = 'KR';
-- count: 8,331,972 / Processed 114,688 rows
| 테이블 | 정렬키 | 읽은 행 수 |
|---|---|---|
events |
(event_type, ts) |
50,000,000 |
events_by_country |
(country, ts) |
114,688 |
결과 건수(833만)는 같은데 읽은 행이 5천만에서 11만으로 약 435배 줄었습니다. 왜 이렇게까지 줄었는지 EXPLAIN으로 들여다봅니다.
EXPLAIN으로 들여다보기
EXPLAIN은 쿼리를 실제 실행하지 않고 실행 계획만 보여주는 명령입니다. 한 가지 짚을 점은, EXPLAIN은 ANSI SQL 표준이 아니라 각 DBMS의 자체 확장이라는 것입니다. 그래서 문법도 제각각입니다(PostgreSQL은 괄호, MySQL은 키워드). ClickHouse는 EXPLAIN [타입] [설정 = 값] <쿼리> 형태이고, indexes = 1은 "인덱스 사용 정보를 출력에 포함하라"는 정수 스위치입니다(1 = 켜기, true는 안 되고 정수만 받습니다).
EXPLAIN indexes = 1
SELECT count() FROM events_by_country WHERE country = 'KR';
ReadFromMergeTree (events_by_country)
Indexes:
  PrimaryKey
    Keys:      country
    Condition: (country in ['KR', 'KR'])
    Parts:     7/7
    Granules:  1024/6107
Condition:WHERE country = 'KR'이 인덱스 범위 조건[KR, KR]으로 변환됐습니다.Granules: 1024/6107: 전체 6,107개 granule 중 1,024개만 후보로 골랐습니다.
country는 6개국이 거의 균등 분포이므로, KR이 차지하는 granule은 전체의 약 1/6입니다.
정렬키가 KR 구간을 정확히 1/6만큼만 골라냈다는 게 수치로 확인됩니다.
그런데 왜 11만 행만 읽었나
여기서 의문이 생깁니다. Granules: 1024는 1024 × 8192 ≈ 838만 행인데, 실제 Processed는 11만이었습니다. 왜 838만이 아닐까요?
count() 쿼리이기 때문입니다. ClickHouse는 각 granule마다 행 수와 컬럼 min/max를 메타데이터로 들고 있어서, 다음처럼 처리합니다.
min = max = KR인 내부 granule은 디스크를 읽지 않고 "8192행"이라는 메타데이터만 더합니다. 실제로 읽는 건 KR과 다른 국가가 섞인 경계 granule뿐입니다.
경계 granule은 왜 8192행을 통째로 읽나
KR이 정렬돼 연속이라면, 경계의 "전환점 한 줄"만 찾으면 될 것 같습니다. 하지만 그렇게 안 됩니다.
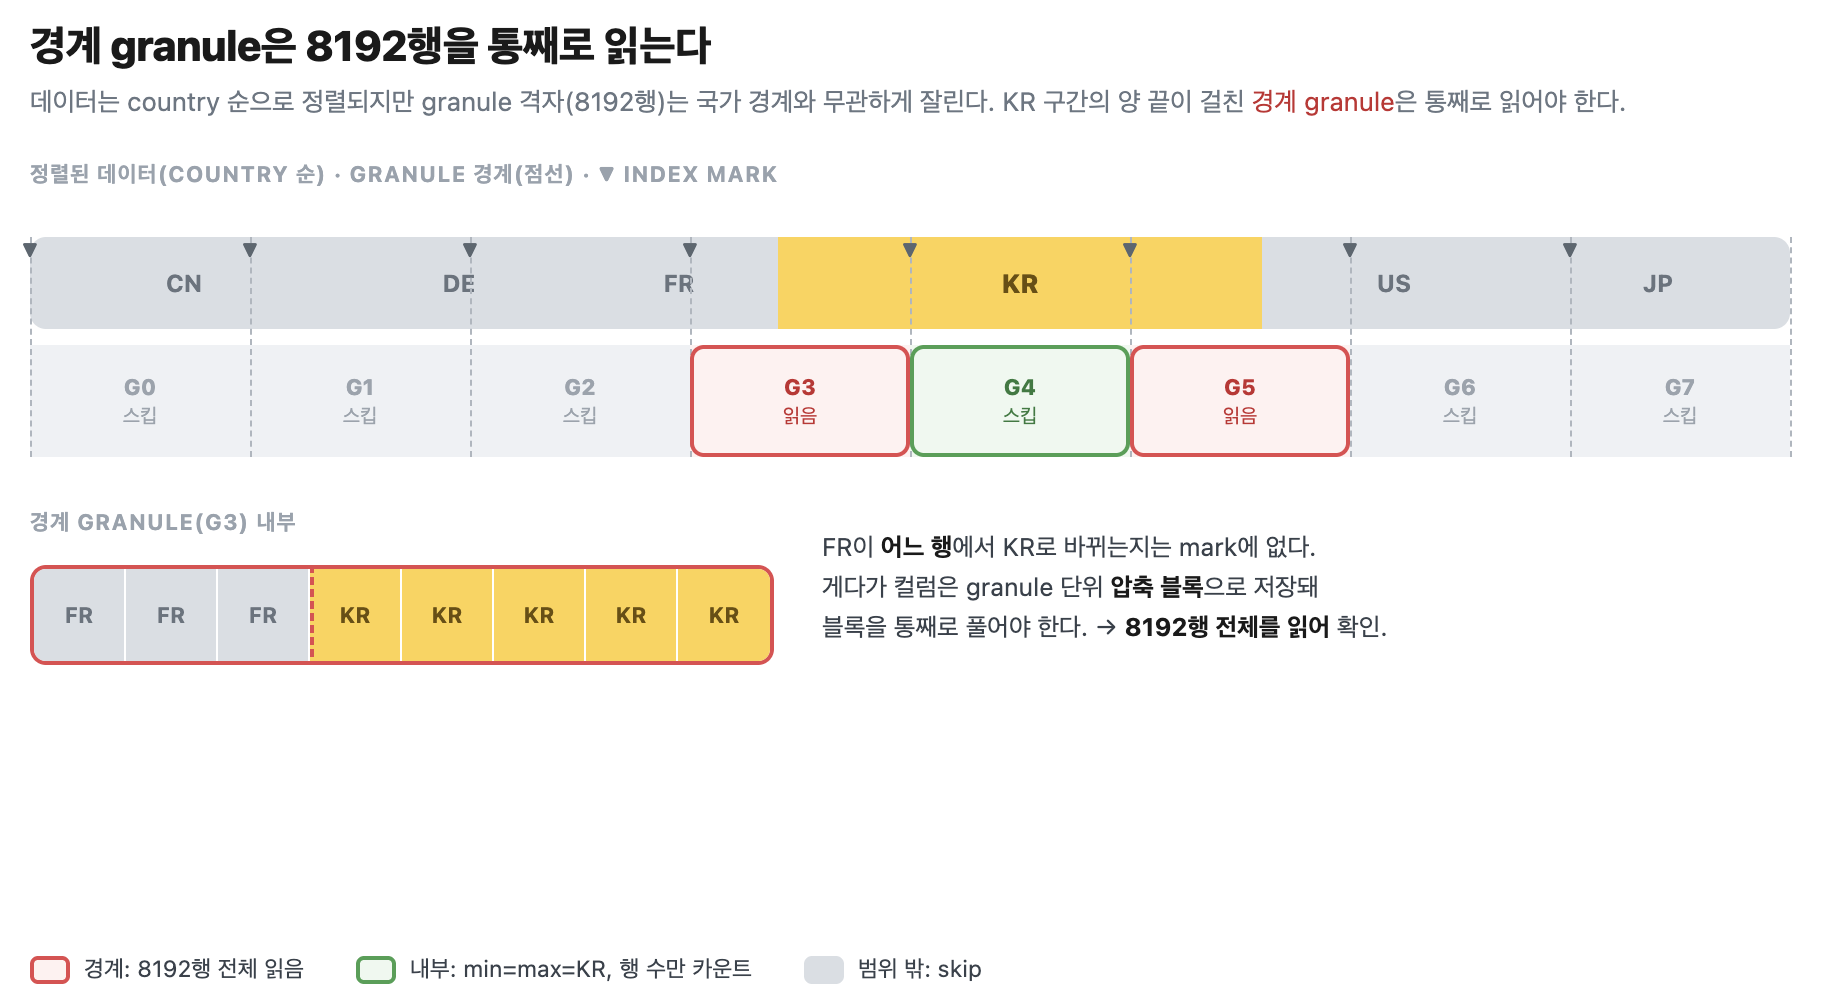
이유는 두 가지입니다.
- 인덱스(mark)는 granule의 시작점만 안다. granule 내부의 어느 행에서 값이 바뀌는지는 인덱스에 없습니다.
- 컬럼은 granule 단위 압축 블록으로 저장된다. 블록을 통째로 풀어야 내부에 접근할 수 있어, "블록의 4000번째 행부터"만 읽는 건 불가능합니다.
그래서 경계 granule은 8192행 전체를 읽어 그 안에서 KR을 찾습니다. 이것이 1편에서 본 "단건 조회에도 최소 8192행을 읽는다"와 같은 이유입니다.
읽은 11만 행의 정체는 이렇게 계산됩니다. part가 7개였고(Parts: 7/7), 각 part마다 KR 구간의 앞·뒤 경계 granule이 하나씩 있습니다.
실측 Processed 114,688과 정확히 일치합니다.
part와 merge
그런데 왜 part가 7개일까요? 그리고 part가 KR 스캔량과 무슨 상관일까요?
핵심은 ClickHouse의 정렬은 테이블 전체가 아니라 part 내부에서만 보장된다는 점입니다. 큰 INSERT는 여러 스레드가 블록 단위로 쓰면서 여러 part를 만들고, 각 part가 독립적으로 정렬됩니다. 그래서 KR은 한 덩어리가 아니라 part마다 한 덩어리씩 존재합니다.
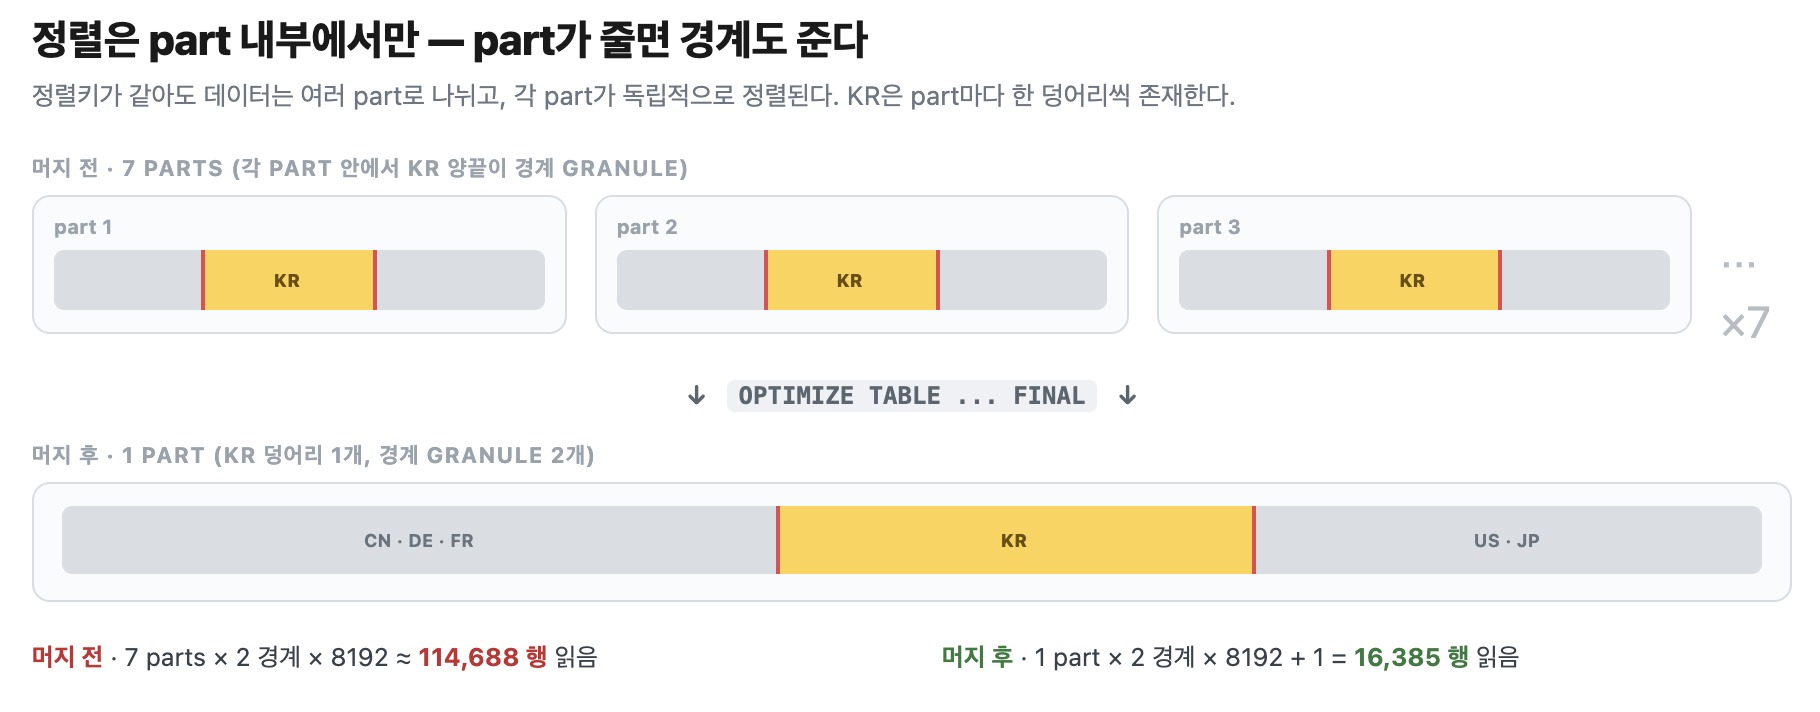
part가 7개면 KR 덩어리도 7개, 경계 granule도 7 × 2 = 14개입니다. 그럼 part를 1개로 합치면 경계도 2개로 줄어야 합니다. OPTIMIZE ... FINAL로 강제 병합해 확인합니다.
OPTIMIZE TABLE events_by_country FINAL;
SELECT count() FROM events_by_country WHERE country = 'KR';
| part 수 | 읽은 행 수 | |
|---|---|---|
| 머지 전 | 7 | 114,688 |
| 머지 후 | 1 | 16,385 |
part가 1개가 되니 KR 덩어리도 1개, 경계 granule 2개만 읽혀 16,385행으로 떨어졌습니다.
active part와 머지의 동작
system.parts를 조회할 때 WHERE active를 붙이는 이유가 여기 있습니다. 머지가 일어나면 옛 part들은 곧바로 삭제되지 않고 inactive 상태로 잠시 남습니다(머지 결과인 새 part가 active). active 필터가 없으면 같은 데이터가 옛 part와 새 part에 중복 집계됩니다.
머지에 대해 알아둘 점:
- 머지는 같은 파티션 안에서만 일어난다. 파티션이 다른 part끼리는 합쳐지지 않습니다.
- 자동으로 1개까지 합쳐지지 않는다. 머지는 비용 대비 가치 휴리스틱이라, 활성 part가 충분히 적어지면 멈춥니다. 전부 1개로 만들려면
OPTIMIZE FINAL이 필요합니다(운영에서는 무거우니 남발 금지). - 고정 주기가 없다. INSERT 직후 가장 활발하고(수 초~수십 초), 안정되면 잦아듭니다. INSERT가 머지를 못 따라가 part가 너무 많아지면 "too many parts"로 INSERT가 지연·거부됩니다.
PARTITION BY — 파티셔닝
ORDER BY(정렬키)가 "파티션 내부 검색 최적화"라면, PARTITION BY는 데이터를 물리적으로 분리하는 관리 단위입니다. 역할이 완전히 다릅니다. 월별로 파티션을 나눠봅니다.
CREATE TABLE events_partitioned
(
    ts DateTime, user_id UInt32,
    event_type LowCardinality(String),
    country LowCardinality(String),
    duration_ms UInt32
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(ts)
ORDER BY (event_type, ts);

INSERT INTO events_partitioned SELECT * FROM events;
system.parts를 보면 데이터가 월별 파티션으로 갈리고, 각 파티션이 독립적으로 part를 가집니다(머지가 파티션 경계를 못 넘으므로, part 수는 최소 파티션 수만큼 유지됩니다).
partition │ parts │ rows
202505    │   2   │   355,346
202506    │   5   │ 4,102,798
...
202512    │   6   │ 4,239,806
파티션 프루닝과 즉시 삭제
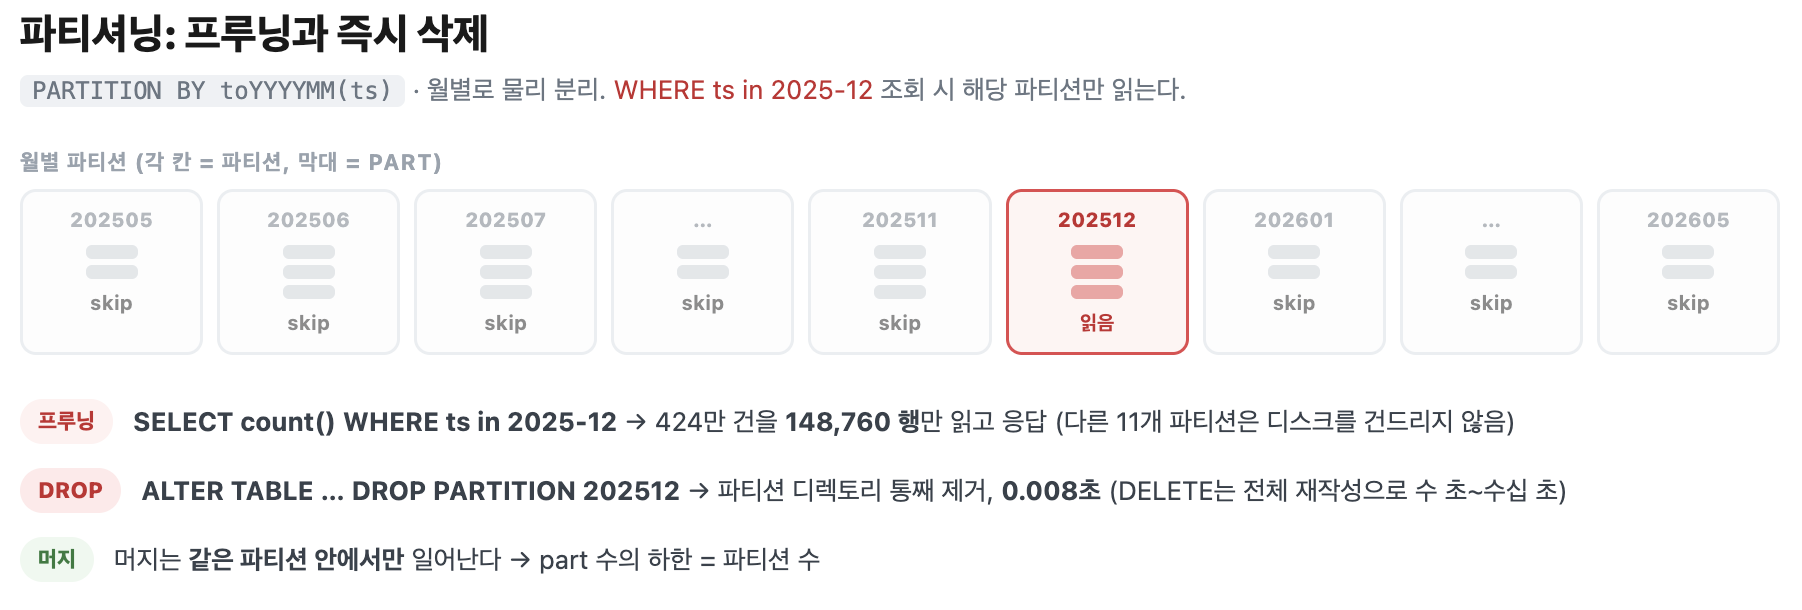
특정 월만 조회하면, 다른 달 파티션은 건드리지도 않습니다(파티션 프루닝).
SELECT count() FROM events_partitioned
WHERE ts >= '2025-12-01' AND ts < '2026-01-01';
-- count: 4,239,806 / Processed 148,760 rows
424만 건을 14.8만 행만 읽고 답했습니다. 그리고 오래된 데이터를 버릴 때 진가가 나옵니다.
ALTER TABLE events_partitioned DROP PARTITION 202512;
-- Elapsed: 0.008 sec
424만 행 삭제가 8밀리초입니다. 데이터를 한 행도 읽지 않고 파티션 디렉토리를 통째로 제거하기 때문입니다. 같은 데이터를 DELETE WHERE로 지우면 해당 part를 전부 재작성하는 무거운 mutation이 되어 수 초~수십 초가 걸립니다. 관측성 백엔드가 시간 기준 파티셔닝으로 retention을 구현하는 이유입니다.
파티셔닝의 득과 실
| 구분 | 내용 |
|---|---|
| 득 | 저비용 대량 삭제(DROP PARTITION), TTL 자동화, 파티션 프루닝, 파티션 단위 백업·이동 |
| 실 | 잘게 쪼개면 작은 part 폭증(too many parts), 머지가 파티션 경계를 못 넘어 part 수 하한 발생, 파티션 키 없는 쿼리엔 이득 없음, 메타데이터 오버헤드 |
가장 흔한 실수는 파티션을 성능 인덱스로 오해해 잘게 쪼개는 것입니다. 일별이나 고카디널리티 컬럼으로 파티션하면 파티션·part가 폭증해 오히려 느려집니다. 공식 권장은 파티션 수를 수백~수천 이하로 유지하는 것이고, 그래서 보통 시간 기준으로 거칠게(월별, 데이터가 매우 많으면 일별) 나눕니다.
🌱 빠른 필터가 필요하면 그건 정렬키나 skip index로 풀 일입니다. 파티션은 "이 데이터 덩어리를 통째로 삭제·이동할 단위가 무엇인가"로 정합니다 — 그래서 retention 주기와 일치시키는 게 정석입니다.
정리
① 정렬키가 스캔량을 결정한다
country를 정렬키 맨 앞으로 올리니WHERE country='KR'스캔이 5천만 → 11만 행으로 줄었습니다.EXPLAIN indexes = 1의Granules값으로 인덱스 prune을 직접 확인할 수 있습니다.
② count는 메타데이터로 답하고, 경계 granule만 읽는다
- 내부 granule(min=max=KR)은 디스크를 안 읽고 행 수만 더합니다.
- 경계 granule은 인덱스가 전환점을 모르고 압축 블록이 granule 단위라, 8192행을 통째로 읽습니다.
③ 정렬은 part 내부에서만 보장된다
- part가 7개면 KR 덩어리도 7개, 경계도 14개. 머지로 1개가 되면 경계가 2개로 줄어 16,385행만 읽습니다.
- 머지는 같은 파티션 안에서만, 부하 기반으로 일어나며, 자동으로 1개까지 합쳐지지는 않습니다.
④ 파티셔닝은 성능 인덱스가 아니라 관리 단위다
- 시간 기준으로 거칠게 나눠
DROP PARTITION·TTL을 싸게 만드는 게 목적입니다. - 잘게 쪼개면 part가 폭증하므로, 빠른 필터는 정렬키로 해결합니다.
TL;DR
- 자주 거는 필터 컬럼을 정렬키 맨 앞에 두면 스캔량이 자릿수로 줄어든다(
EXPLAIN indexes = 1로 확인). count()는 granule 메타데이터로 답하고, 값이 섞인 경계 granule만 8192행 통째로 읽는다. 정렬은 part 내부에서만 보장되므로 part가 많으면 경계도 많아진다(머지로 줄어듦).PARTITION BY는 성능 인덱스가 아니라 retention·관리 단위다. 시간 기준으로 거칠게 나누고, 빠른 필터는 정렬키로 푼다.