
MergeTree 엔진 패밀리
🔍 ClickHouse 스터디 시리즈
개요
지금까지는 기본
MergeTree한 종류만 썼습니다. ClickHouse에는 머지 시점에 데이터를 변형하는 엔진 패밀리가 있습니다.ReplacingMergeTree(최신만 유지),SummingMergeTree(합산),AggregatingMergeTree(복잡 집계)입니다. 이 글에서는 각 엔진과 거기서 쓰는 함수들(-State/-Merge/finalizeAggregation,FINAL)의 역할·용도·사용 시점을 실제 데이터로 정리합니다.
공통 원리: append-only + 머지 시 변형
먼저 패밀리 전체를 관통하는 원리부터. 모든 MergeTree 패밀리는 저장 모델이 append-only입니다. INSERT는 항상 새 part를 추가할 뿐, 기존 데이터를 in-place로 고치지 않습니다. 다른 점은 머지 시점에 같은 ORDER BY 키 행을 어떻게 처리하느냐뿐입니다.
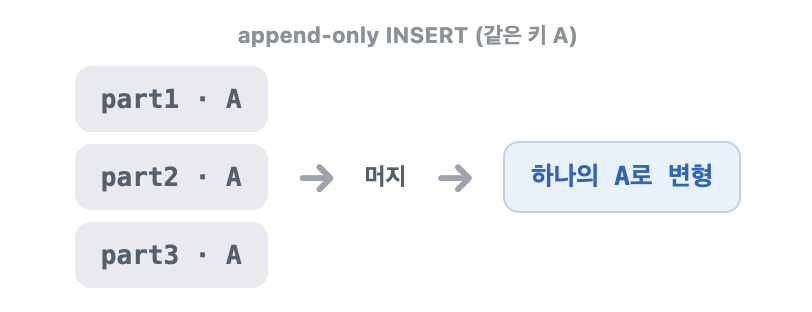
| 엔진 | 머지 시 같은 키 행 처리 |
|---|---|
MergeTree |
그대로 둠 (단순 병합) |
ReplacingMergeTree |
최신 버전 1행만 남김 |
SummingMergeTree |
숫자 컬럼 합산 |
AggregatingMergeTree |
집계 상태 병합 |
카프카를 다뤄봤다면 log compaction과 같은 발상입니다. 메시지는 append-only 로그에 쌓이고, 백그라운드 compaction이 같은 키의 오래된 것을 접습니다. ClickHouse는 그 compaction 규칙을 합산·집계로 확장한 것입니다.
중요한 귀결: 변형은 머지 시점에 "eventually" 적용됩니다. 머지 전까지는 중복이나 부분 집계가 남아 있어서, 정확한 결과는 FINAL 또는 GROUP BY로 보장해야 합니다. 이 점이 아래 모든 엔진에서 반복됩니다.
ReplacingMergeTree — UPDATE 대신 "최신 상태"
ClickHouse에는 행 단위 UPDATE가 사실상 없습니다. ALTER TABLE ... UPDATE는 있지만 해당 part를 통째로 재작성하는 무거운 mutation이라 잦은 갱신엔 부적합합니다. 그래서 "사용자의 현재 상태" 같은 가변 데이터는 새 버전을 INSERT(append)하고 최신만 조회하는 방식으로 다룹니다. 그 도구가 ReplacingMergeTree입니다.
CREATE TABLE user_state
(
    user_id    UInt32,
    status     LowCardinality(String),
    updated_at DateTime
)
ENGINE = ReplacingMergeTree(updated_at)   -- updated_at = 버전 컬럼
ORDER BY user_id;                          -- user_id = 중복 판단 키
같은 user_id를 따로따로 INSERT하면(= 다른 part) 머지 전까지 공존합니다.
INSERT INTO user_state VALUES (3, 'active',   '2026-01-01 10:00:00');
INSERT INTO user_state VALUES (3, 'inactive', '2026-05-01 10:00:00');

SELECT * FROM user_state WHERE user_id = 3;
-- 2행 (active, inactive) — 아직 머지 전

SELECT * FROM user_state FINAL WHERE user_id = 3;
-- 1행 (inactive, 2026-05-01) — updated_at이 최신인 것
ORDER BY키가 중복 판단 기준,ReplacingMergeTree(updated_at)의updated_at이 "최신"을 정하는 버전입니다.- 같은 INSERT 블록 안의 중복은 part 생성 시 즉시 제거되지만, 다른 part 간 중복은 머지 전까지 남습니다. 그래서 항상 최신을 보장하려면
FINAL이 필요합니다.
용도: 사용자/기기의 현재 상태, 최신 스냅샷, 중복 제거(dedup).
SummingMergeTree — 카운터 합산
같은 키의 숫자 컬럼을 머지 시 더합니다. 사전 집계 카운터에 씁니다.
CREATE TABLE daily_counts
(
    event_date Date,
    event_type LowCardinality(String),
    cnt        UInt64
)
ENGINE = SummingMergeTree
ORDER BY (event_date, event_type);

INSERT INTO daily_counts VALUES ('2026-05-01','click',10),('2026-05-01','click',5);
INSERT INTO daily_counts VALUES ('2026-05-01','click',7);
조회 방식이 두 가지인데, 동작이 다릅니다.
-- (A) GROUP BY sum — 쿼리가 직접 집계. 엔진과 무관하게 항상 정확
SELECT event_date, event_type, sum(cnt)
FROM daily_counts GROUP BY event_date, event_type;
-- click = 22

-- (B) FINAL — 엔진의 합산 규칙을 쿼리 시점에 적용
SELECT * FROM daily_counts FINAL;
-- click = 22
GROUP BY sum() |
FINAL |
|
|---|---|---|
| 집계 정의 | 쿼리가 명시 | 엔진 규칙(합산) |
| 다른 집계 | max·avg 등 자유 |
합산만 |
| 권장 | ✅ 일반적 | 정리된 행이 필요할 때 |
GROUP BY sum이 정석입니다. 엔진이 머지로 행을 미리 줄여놨으면 그 GROUP BY가 빠르고, 안 줄였어도 정확하니까요.
용도: 일/시간 단위 카운트·합계 사전 집계.
AggregatingMergeTree — 복잡한 집계
왜 새 엔진이 필요한가
sum·count는 Summing으로 됐습니다. 그런데 avg는 부분 평균을 저장하면 틀립니다.
- 묶음 A: 100건, 평균 50
- 묶음 B: 200건, 평균 80
- 전체 평균 = (100×50 + 200×80) / 300 = 70
- 평균의 평균 = (50+80)/2 = 65 ❌
정확히 합치려면 sum과 count를 따로 들고 있다가 병합해야 합니다. AggregatingMergeTree는 이 "집계 중간 상태"를 AggregateFunction 타입 컬럼에 저장합니다.
-State / -Merge 함수
CREATE TABLE daily_stats
(
    event_date   Date,
    event_type   LowCardinality(String),
    avg_duration AggregateFunction(avg, UInt32),
    unique_users AggregateFunction(uniq, UInt32)
)
ENGINE = AggregatingMergeTree
ORDER BY (event_date, event_type);

-- 입력: -State 로 "상태"를 만들어 넣음
INSERT INTO daily_stats
SELECT toDate(ts), event_type, avgState(duration_ms), uniqState(user_id)
FROM events GROUP BY toDate(ts), event_type;

-- 조회: -Merge 로 상태를 병합해 최종값
SELECT event_date, event_type,
       avgMerge(avg_duration)  AS avg_duration,
       uniqMerge(unique_users) AS unique_users
FROM daily_stats GROUP BY event_date, event_type;
실측에서 5천만 행 events가 1,830행(366일 × 5 event_type)으로 압축됐고, avgMerge로 평균 2494.67, uniqMerge로 고유 user 수가 나왔습니다. 대시보드 쿼리가 폭발적으로 빨라지는 사전 집계입니다.
상태 컬럼이 왜 바이너리인가
상태 컬럼을 -Merge 없이 그냥 조회하면 사람이 못 읽는 바이너리가 나옵니다. 평균값이 아니라 (sum, count)를 직렬화한 바이트열이기 때문입니다. 실제로 한 상태의 hex를 뜯어보면:
hex(avg_duration) = F978680200000000C37E
  → 앞 8바이트 F9 78 68 02 00 00 00 00 = sum   = 40,400,121
  → 뒤 varint     C3 7E                = count = 16,195
  → 40,400,121 / 16,195 = 2494.67  ✓
바이너리 안에 정말 sum과 count가 들어 있습니다.
finalizeAggregation vs -Merge
이 둘의 차이가 핵심입니다. 상태를 "합치느냐"가 갈림길입니다.
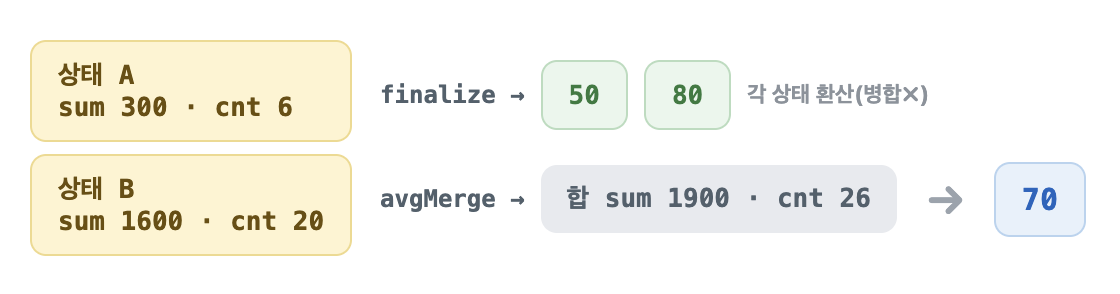
같은 키에 상태가 2개(묶음 A=평균50, B=평균80) 있을 때:
| 동작 | 결과 | |
|---|---|---|
finalizeAggregation |
상태를 각각 환산 (병합 ❌) | 2행: 50, 80 (부분값) |
avgMerge (+GROUP BY) |
상태를 합친 뒤 환산 (병합 ✅) | 1행: 70 (정답) |
비유: 상태 = 영수증(총액·개수).
finalize는 영수증 한 장씩 평균 단가를 적는 것,-Merge는 여러 영수증의 총액·개수를 다 합친 뒤 평균 단가를 내는 것. 묶음 크기가 다르면 합쳐야(=-Merge) 정답이 나옵니다.
finalizeAggregation은 언제 쓰나
finalize는 각 상태를 항상 정확히 환산합니다(틀린 계산이 아님). 다만 그 결과가 "키 통합값"이 되려면 조건이 있습니다.
- 각 part의 부분값을 보고 싶다 → 상태가 N개여도
finalize가 적합 (N행, 모두 정확) - 키 전체 통합값을 원한다 → 상태가 1개임이 보장될 때만
finalize= 통합값. 아니면-Merge필요
여기서 "상태 1개 보장"은 쿼리가 아니라 테이블의 물리적 머지 상태로 결정됩니다(OPTIMIZE FINAL 후, 또는 중복 INSERT 없음). 그래서 디폴트는 항상 -Merge 이고, finalize는 "머지가 끝났음이 확실할 때의 지름길 + 디버깅용"입니다.
avgState vs uniqState — 정확 집계 vs 근사 집계
둘 다 "병합 가능한 상태"지만 내용물이 다릅니다.

uniq(고유값 개수)는 부분 결과를 단순히 더할 수 없습니다.
- part1 고유 user
{1,2,3}= 3 - part2 고유 user
{2,3,4}= 3 - 전체 고유
{1,2,3,4}= 4 (단순 합 6이 아님)
그래서 uniqState는 HyperLogLog 스케치(고유값 해시 분포 요약)를 저장하고, uniqMerge가 두 스케치의 합집합을 구해 추정합니다. 정확한 distinct는 모든 값을 들고 있어야 해 메모리가 폭발하므로, 고정 크기 스케치로 근사(오차 ~1%)하는 거예요.
avgState |
uniqState |
|
|---|---|---|
| 상태 내용 | sum, count | HyperLogLog 스케치 |
| 정확성 | 정확 | 근사 (~1%) |
| 병합 방식 | sum·count 더하기 | 스케치 합집합 |
(정확한 distinct가 꼭 필요하면 uniqExact를 쓰지만, 모든 값을 보관해 상태가 훨씬 큽니다.)
GROUP BY vs FINAL — 집계냐, 행 선택이냐
SummingMergeTree에서 둘 다 22를 줘서 헷갈리기 쉽지만, 기준은 단순합니다. 집계값을 원하면 GROUP BY, 행 전체를 원하면 FINAL.
집계 → GROUP BY. Summing·Aggregating은 본질이 sum·avg·uniq 같은 집계라 GROUP BY(+-Merge)가 자연스럽고 우월합니다. max·avg 등 무슨 집계든 자유롭고, 머지 상태와 무관하게 정확합니다. 그래서 집계는 거의 항상 GROUP BY가 옳습니다.
행 선택 → FINAL. 반면 ReplacingMergeTree의 "각 키의 최신 행 전체"는 집계가 아니라 행 선택입니다. 이걸 GROUP BY로 재현하려면 모든 비키 컬럼에 argMax를 써야 합니다.
-- GROUP BY로 최신 행 재현: 컬럼마다 argMax (장황 + 컬럼 추가 시 깨짐)
SELECT user_id,
       argMax(status, updated_at) AS status,
       argMax(name,   updated_at) AS name,
       argMax(email,  updated_at) AS email,
       max(updated_at)            AS updated_at
FROM user_state GROUP BY user_id;

-- FINAL: 한 줄. 엔진이 최신 행을 알아서 고름
SELECT * FROM user_state FINAL;
컬럼이 10개면 argMax도 10개고, 컬럼을 추가할 때마다 이 쿼리를 고쳐야 합니다. 동점(같은 updated_at) 처리도 애매하고요. FINAL은 SELECT * 한 줄이고 컬럼이 늘어도 그대로입니다. (CollapsingMergeTree처럼 +1/-1로 상쇄하는 복잡한 로직도 FINAL이 엔진 규칙을 그대로 적용해줍니다.)
| 원하는 것 | 도구 |
|---|---|
| 집계값 (sum·avg·uniq) | GROUP BY (+-Merge) — 디폴트 |
| 최신/정리된 행 전체 (Replacing·Collapsing) | FINAL — SELECT * |
둘은 경쟁이 아니라 분담입니다. 집계는 GROUP BY, 최신 행은 FINAL. "거의 항상 GROUP BY가 옳다"는 느낌은 집계 엔진만 봤을 때의 이야기이고, 행 전체를 꺼내야 하는 ReplacingMergeTree에서는 FINAL이 정답입니다.
함수·문법 정리
| 도구 | 역할 | 언제 |
|---|---|---|
ReplacingMergeTree |
같은 키 최신 1행 유지 | 가변 상태, 최신 스냅샷, dedup |
SummingMergeTree |
같은 키 숫자 합산 | 카운트·합계 사전 집계 |
AggregatingMergeTree |
같은 키 집계 상태 병합 | avg·uniq 등 복잡 집계 사전 계산 |
-State (avgState) |
원시값 → 집계 중간 상태 | 사전 집계 입력 (MV 포함) |
-Merge (avgMerge) |
여러 상태 병합 → 최종값 | 집계 조회 디폴트 (+GROUP BY) |
finalizeAggregation |
상태 1개 → 값 (병합 안 함) | 키별 1상태 보장 시, 디버깅 |
FINAL |
엔진 규칙을 쿼리 시점 적용 | 정리된 행 자체가 필요할 때 |
GROUP BY 집계 |
쿼리가 직접 집계 | Summing 조회 등 (정확·유연) |
TL;DR
- MergeTree 패밀리는 append-only를 유지하되 머지 시 같은 키 행을 변형한다. 변형은 eventually 적용되므로 정확한 값은
FINAL/GROUP BY/-Merge로 본다. - ClickHouse엔 UPDATE가 없어,
ReplacingMergeTree+FINAL로 "최신 상태"를 구현한다 (append 후 최신만). avg·uniq는 부분 결과를 못 합치므로AggregatingMergeTree가 중간 상태를 저장한다.-Merge는 상태를 합쳐 정답을 내고,finalizeAggregation은 상태 하나만 환산한다 — 그래서 디폴트는-Merge다.