
TTL과 데이터 수명주기
🔍 ClickHouse 스터디 시리즈
개요
1·2편에서는 "데이터를 어떻게 빠르게 읽는가"(컬럼 지향, 정렬키, part, 파티션)를 다뤘습니다. 이번 글의 주제는 정반대입니다. "오래된 데이터를 어떻게 자동으로 정리하는가" — 즉 TTL입니다. 자동 삭제(retention)부터 hot/cold 계층화까지, 관측성 백엔드의 데이터 수명주기 관리를 ClickHouse가 어떻게 SQL 한 줄로 처리하는지 로컬 실측으로 확인합니다.
TTL이란
TTL(Time To Live)은 "이 시간이 지난 데이터는 자동으로 처리하라"는 규칙입니다. 테이블 정의에 선언해두면 ClickHouse 백그라운드가 알아서 적용합니다. 처리 방식은 세 가지입니다.
- 삭제(
DELETE): 만료된 데이터를 버린다 — retention - 이동(
TO VOLUME/TO DISK): 싼 디스크로 옮긴다 — hot/cold 계층화 - 롤업(
GROUP BY): 오래된 데이터를 집계해 압축 보관한다
하나씩 직접 돌려봅니다. 테이블은 1편에서 만든 5천만 행짜리 events(ts가 약 1년에 분포)를 재료로 씁니다.
자동 삭제 — retention
"6개월 지난 데이터는 버린다"는 정책을 겁니다.
CREATE TABLE events_ttl
(
    ts DateTime, user_id UInt32,
    event_type LowCardinality(String),
    country LowCardinality(String),
    duration_ms UInt32
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(ts)
ORDER BY (event_type, ts)
TTL ts + INTERVAL 6 MONTH;

INSERT INTO events_ttl SELECT * FROM events;
적재 직후 데이터 범위를 봅니다.
SELECT min(ts), max(ts), count() FROM events_ttl;
-- 2025-05-29 09:41:26 | 2026-05-29 09:41:08 | 25,907,089
원본은 5천만인데 적재 직후 이미 2,590만으로 줄었습니다. INSERT 과정에서 완전히 만료된 월 파티션이 빠르게 정리됐기 때문입니다. 다만 min(ts)가 여전히 과거인 걸 보면 아직 끝까지 적용되진 않았습니다. TTL은 백그라운드에서 점진적으로 동작합니다. 강제로 끝까지 돌려봅니다.
ALTER TABLE events_ttl MATERIALIZE TTL;
SELECT min(ts), max(ts), count() FROM events_ttl;
-- 2025-12-01 00:00:01 | 2026-05-29 09:41:08 | 24,612,546
min(ts)가 2025-05-29 → 2025-12-01로 올라갔습니다. 오늘이 2026-05-31이라 만료 기준은 2025-11-30 이전인데, 결과는 정확히 **2025-12-01(202512 파티션의 시작)**에서 잘렸습니다. TTL이 파티션 단위로 동작하기 때문입니다.
- 202511 파티션: 모든 행이
ts + 6M ≤ 2026-05-30 < now→ 파티션 전체 만료 → 통째로 드롭 - 202512 파티션:
ts + 6M ≥ 2026-06-01 > now→ 유효 → 유지
운영에서는
MATERIALIZE TTL을 칠 필요 없이 백그라운드 TTL 머지(merge_with_ttl_timeout, 기본 4시간)가 처리합니다. 즉시 확인하거나 정책을 바꿔 소급 적용할 때만 수동으로 씁니다.
파티션과의 시너지
TTL 삭제가 위처럼 파티션 경계에서 잘리는 것은 우연이 아니라 핵심입니다. 파티션을 시간 기준으로 나눠두면, TTL은 만료된 파티션을 디렉토리째 드롭할 수 있습니다.
2편에서 DROP PARTITION으로 424만 행을 8밀리초에 지웠던 게 이 경로입니다. 만약 파티션이 없거나 TTL 주기와 어긋나면, TTL은 만료 행을 제외하고 part를 통째로 재작성해야 해서 훨씬 무거워집니다. 그래서 파티션 주기를 TTL/retention 주기와 맞추는 게 정석입니다. (예: 일 단위로 지우면 PARTITION BY toDate(ts), 월 단위면 toYYYYMM(ts))
hot/cold 계층화 — TO VOLUME
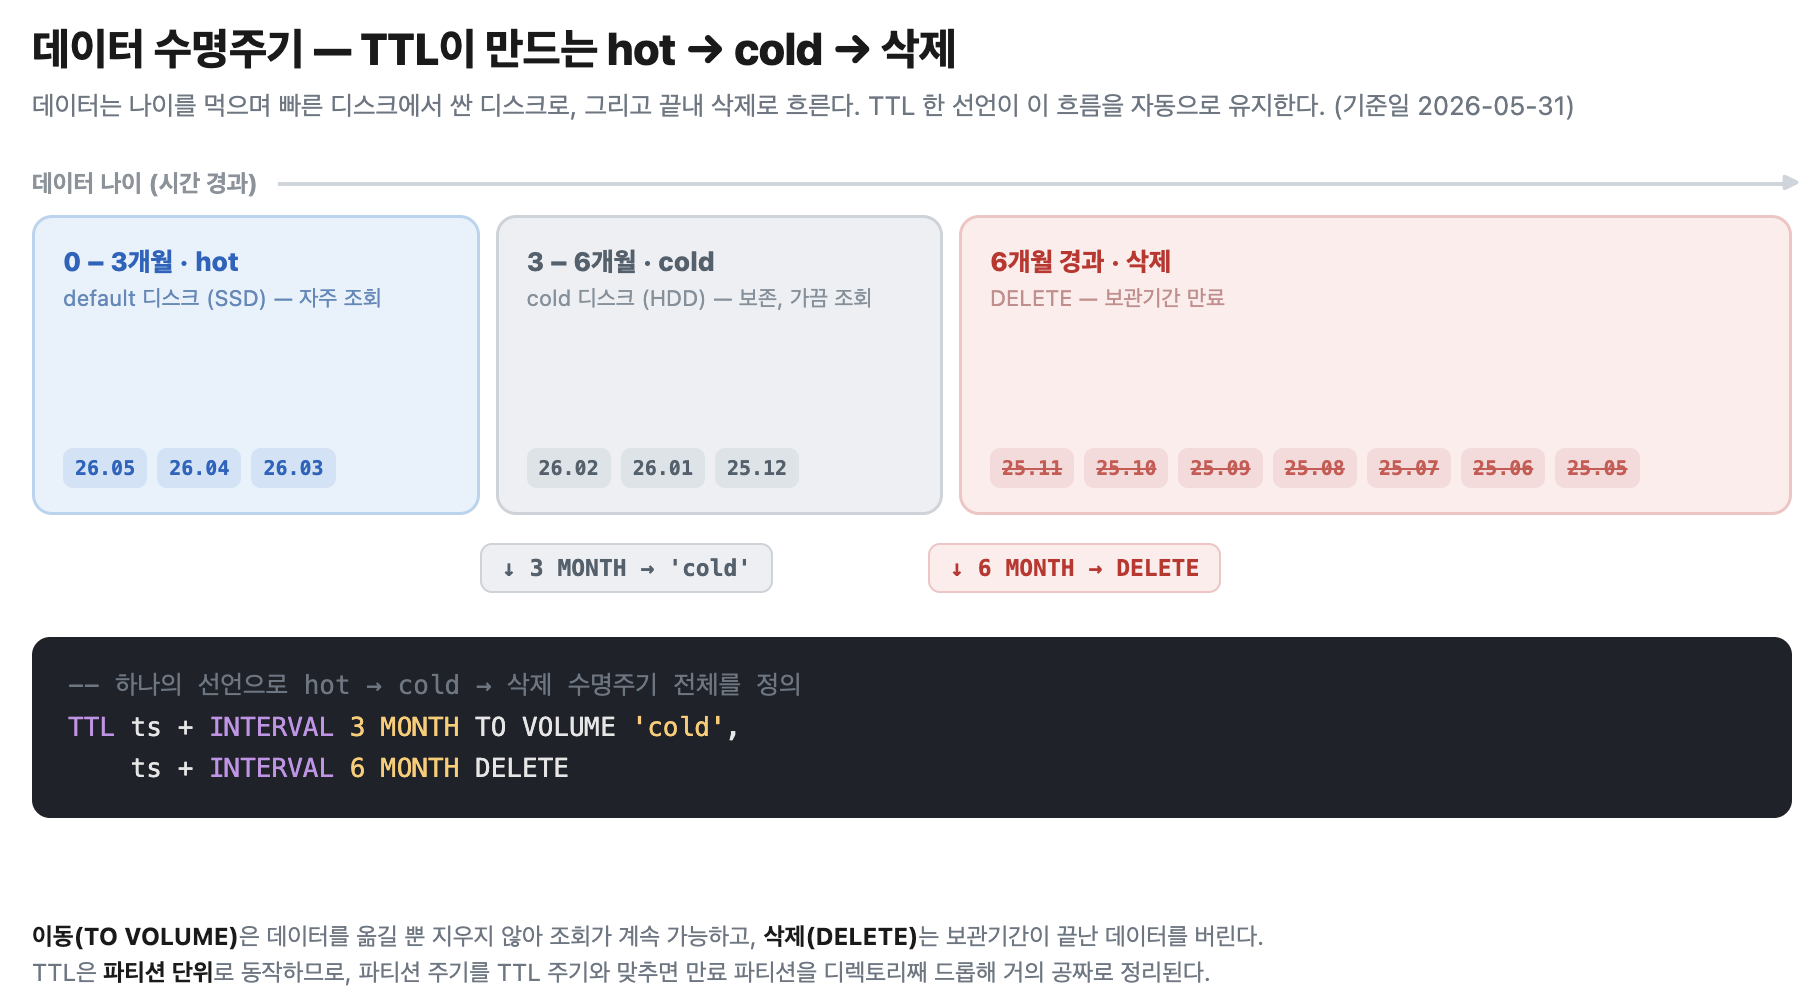
TTL의 두 번째 형태는 삭제가 아니라 이동입니다. "최근 데이터는 빠른 디스크, 오래된 데이터는 싼 디스크"를 자동으로 유지합니다.
먼저 디스크 두 개와 storage policy를 정의합니다(config.d).
<clickhouse>
  <storage_configuration>
    <disks>
      <cold><path>/var/lib/clickhouse-cold/</path></cold>
    </disks>
    <policies>
      <hot_cold>
        <volumes>
          <hot><disk>default</disk></hot>
          <cold><disk>cold</disk></cold>
        </volumes>
      </hot_cold>
    </policies>
  </storage_configuration>
</clickhouse>
"3개월 지난 데이터는 cold 볼륨으로 이동"하는 테이블을 만듭니다.
CREATE TABLE events_tiered
(
    ts DateTime, user_id UInt32,
    event_type LowCardinality(String),
    country LowCardinality(String),
    duration_ms UInt32
)
ENGINE = MergeTree
PARTITION BY toYYYYMM(ts)
ORDER BY (event_type, ts)
TTL ts + INTERVAL 3 MONTH TO VOLUME 'cold'
SETTINGS storage_policy = 'hot_cold';

INSERT INTO events_tiered SELECT * FROM events;
각 파티션이 어느 디스크에 있는지 확인합니다.
SELECT partition, disk_name, count() AS parts, sum(rows) AS rows
FROM system.parts
WHERE database = 'lab' AND table = 'events_tiered' AND active
GROUP BY partition, disk_name ORDER BY partition;
partition │ disk_name │ parts │ rows
202505    │ cold      │   3   │   355,346
...
202602    │ cold      │   4   │ 3,830,367
202603    │ default   │   6   │ 4,254,425
202604    │ default   │   8   │ 4,135,710
202605    │ default   │   2   │ 3,914,835
오늘이 2026-05-31이라 3개월 기준 2026-02-28을 경계로, **202602까지는 cold, 202603부터는 default(hot)**로 정확히 갈렸습니다. 여기서 중요한 차이가 있습니다.
count()합계는 5천만 그대로입니다.DELETE와 달리TO VOLUME은 이동만 하므로 데이터가 줄지 않습니다.- cold로 옮겨진 데이터도 여전히 조회됩니다(단 느린 디스크라 응답이 느릴 수 있음).
system.parts의 count()가 part 개수를 센다는 점도 확인할 수 있습니다. system.parts는 part 하나당 한 행이라, GROUP BY 후 count()가 곧 그 그룹의 part 수입니다.
삭제와 이동을 함께
실무에서는 둘을 묶어 하나의 수명주기를 만듭니다.
TTL ts + INTERVAL 3 MONTH TO VOLUME 'cold',
    ts + INTERVAL 6 MONTH DELETE
"3개월 지나면 cold로 옮기고, 6개월 지나면 삭제" — 위 그림의 hot → cold → 삭제 흐름이 이 한 선언으로 자동 유지됩니다. Loki/Prometheus의 보관기간 설정이나 OpenSearch ILM이 하는 일과 같습니다.
그 외의 TTL
- 컬럼 TTL: 특정 컬럼만 일정 시간 후 기본값으로 비웁니다. 예: 원본 페이로드는 30일 뒤 지우고 집계값만 남기기.
payload String TTL ts + INTERVAL 30 DAY GROUP BY롤업: 오래된 raw 데이터를 집계로 대체해 용량을 줄입니다. 예: 90일 지난 분 단위 메트릭을 시간 단위로 합쳐 보관.
둘 다 "오래된 데이터의 해상도를 낮춰 비용을 줄인다"는 관측성의 보편적 패턴을 SQL로 표현한 것입니다.
정리
① TTL은 자동 retention이다
TTL ts + INTERVAL 6 MONTH로 만료 데이터를 자동 삭제합니다. 백그라운드로 점진 적용되며,MATERIALIZE TTL로 즉시 적용할 수 있습니다.
② 파티션과 한 세트로 설계한다
- 만료가 파티션 경계와 맞으면 디렉토리째 드롭(거의 공짜), 어긋나면 part 재작성(무거움). 파티션 주기를 TTL 주기와 맞춥니다.
③ TO VOLUME으로 hot/cold 계층화
- 삭제 대신 싼 디스크로 이동합니다. 데이터는 보존되고 조회도 가능합니다.
TO VOLUME과DELETE를 함께 선언해 hot → cold → 삭제 수명주기를 만듭니다.
TL;DR
TTL ts + INTERVAL N으로 오래된 데이터를 자동 삭제·이동한다. 백그라운드로 점진 적용된다.- TTL은 파티션 단위로 동작한다 — 파티션 주기를 retention 주기와 맞추면 만료 파티션을 통째로 드롭해 거의 공짜다.
TO VOLUME 'cold'로 hot/cold 계층화를 만든다. 삭제(DELETE)와 함께 선언하면 hot → cold → 삭제 수명주기가 SQL 한 선언으로 자동 유지된다.