
ping 한 발의 해부, 그리고 유령 IP의 정체
🔍 Cilium 스터디 시리즈
Chap2에서 라우팅 테이블 12줄로 클러스터의 설계를 읽었습니다. 이번 편에서는 관찰 도구 세 개(tcpdump, ss, conntrack)를 들고 실제로 패킷을 들여다봅니다. 그 과정에서 지난 편부터 끌고 온 미스터리 하나를 해결합니다. 우리 노드들이 끊임없이 대화하는 상대, 어느 노드의 것도 아닌 IP 10.0.0.99의 정체입니다.
💡 실습 환경: 온프레미스 6노드 클러스터 (컨트롤플레인 3 + 워커 3, v1.30) + Cilium 1.18.2, Native Routing 모드, kube-proxy 없음. 이번 편의 명령은 전부 읽기 전용이거나 즉시 자가복구되는 것들입니다.
tcpdump — ping은 4단계
Chap1에서 ARP를 "주소록(ip neigh)을 만드는 절차"라고 정리했습니다. 이번에는 그 절차를 눈으로 직접 보겠습니다. 문제는 평소에는 주소록에 항목이 이미 있어서 ARP가 생략된다는 점입니다. 그래서 일부러 주소록 한 페이지를 찢고 ping을 쏘기로 했습니다.
# 터미널 1: 감시 시작
$ sudo tcpdump -i ens18 -n 'arp or icmp'

# 터미널 2: 주소록을 찢고 ping 한 발
# (ip neigh del은 다음 통신에서 즉시 재학습되는, 복구 절차조차 필요 없는 변경입니다)
$ sudo ip neigh del 10.0.0.112 dev ens18 && ping -c 1 10.0.0.112
결과는 교과서 그대로 4단이 찍혔습니다.
01:21:14.344406  ARP, Request who-has 10.0.0.112 tell 10.0.0.113   ← 브로드캐스트로 외침
01:21:14.345872  ARP, Reply 10.0.0.112 is-at bc:24:11:fe:82:5a     ← 당사자만 답장
01:21:14.345879  IP 10.0.0.113 > 10.0.0.112: ICMP echo request     ← ARP 답장 후 7µs 만에
01:21:14.347030  IP 10.0.0.112 > 10.0.0.113: ICMP echo reply
응답에 찍힌 bc:24:11:fe:82:5a는 Chap1에서 ip neigh로 봤던 바로 그 MAC입니다. 주소록의 기록과 와이어 위의 실제 응답이 일치하는 것을 확인했습니다.
그런데 타임스탬프를 자세히 보면 더 재미있는 것이 있습니다. ICMP request가 ARP Reply 직후 겨우 7µs 만에 나갔습니다. ping은 ICMP 패킷을 진작에 만들어서 커널에 넘겼지만, 커널이 MAC을 몰라 패킷을 들고 기다리고 있었던 겁니다. ARP가 풀리는 순간 즉시 발사된 거죠. "라우팅으로 문을 정하고, 주소록으로 MAC을 찾는다"는 순서가 시간축에 그대로 찍혀 있습니다.
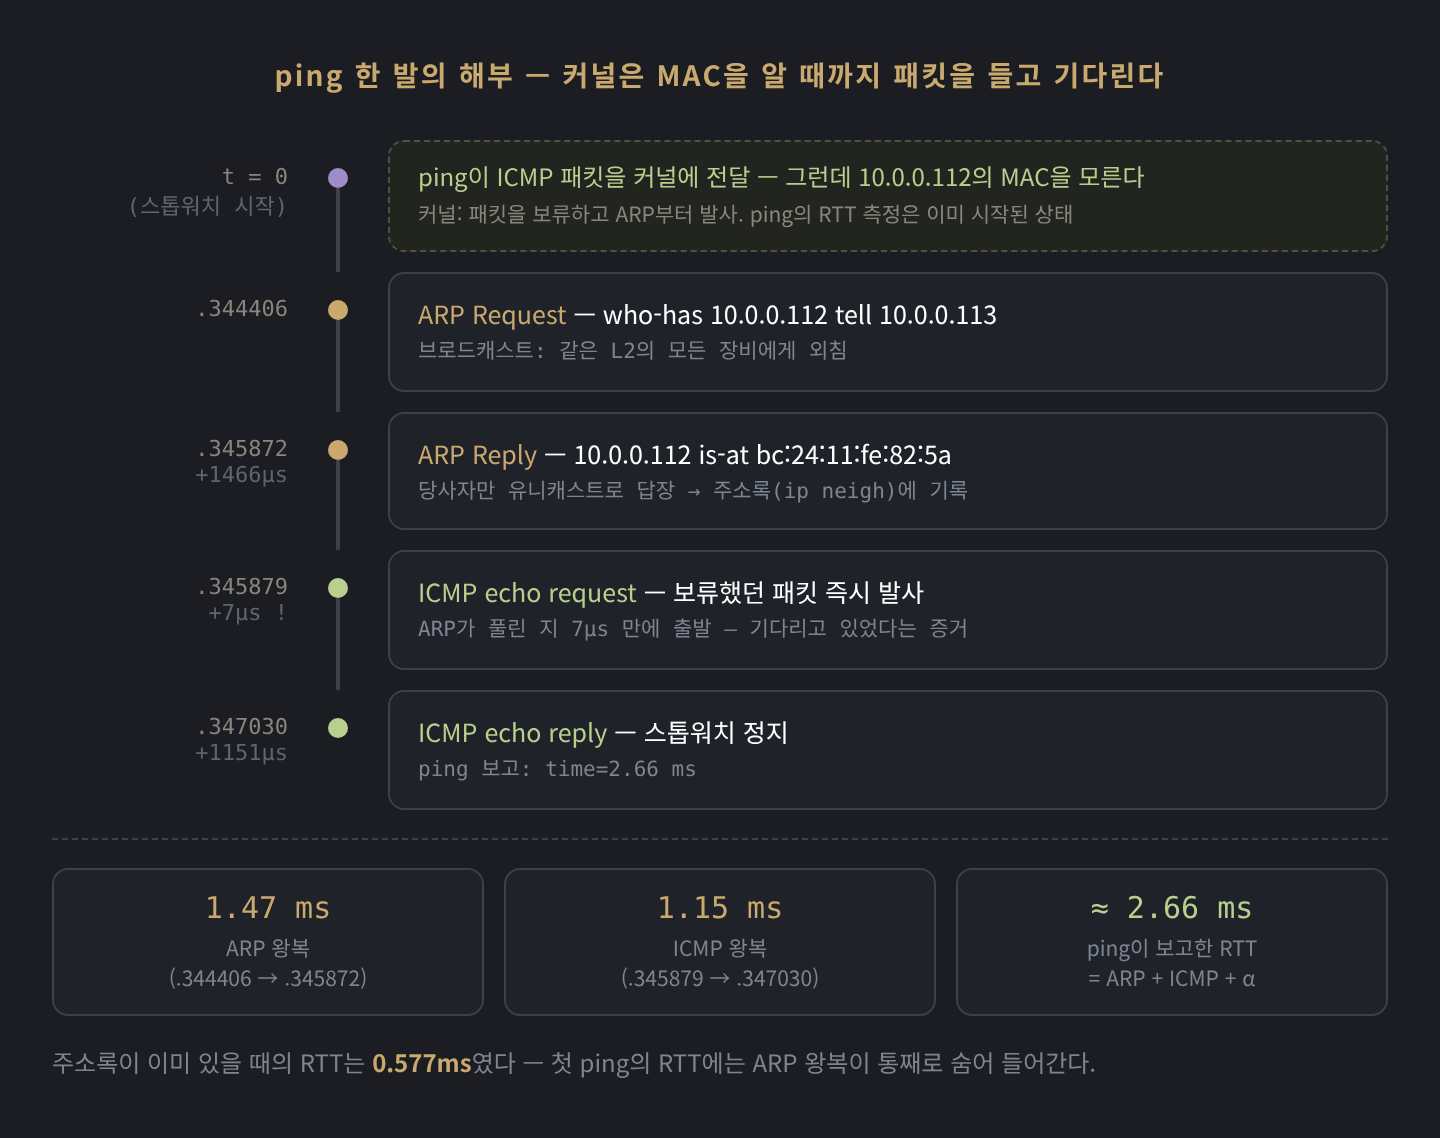
이게 실측 수치로도 확인됩니다. 같은 두 노드 사이인데, 주소록이 있을 때의 ping은 0.577ms, 주소록을 찢은 직후의 ping은 2.66ms가 나왔습니다.
347030 - 344406 = 2624µs ≈ 2.62ms   ← ARP 왕복 + ICMP 왕복 (tcpdump 기준)
ping 보고값         2.66ms           ← 위 값 + 유저스페이스 오버헤드 약간
347030 - 345879 = 1151µs            ← 순수 ICMP 왕복만 떼어내면
ping의 스톱워치는 "ICMP를 커널에 넘긴 순간"부터 돌아가는데, 커널이 그 패킷을 들고 ARP를 기다렸으니 첫 ping의 RTT에는 ARP 왕복이 통째로 숨어 들어갑니다. 같은 측정 도구라도 캐시 상태에 따라 다른 것을 재고 있는 셈입니다. 벤치마크에서 첫 샘플을 버리는 관행의 실물을 본 기분이었습니다.
안 보낸 패킷이 잡혔다
tcpdump를 켜둔 동안 우리가 만들지 않은 패킷이 흘러 들어왔습니다.
01:21:18.292334  IP 10.0.0.101 > 172.20.5.199: ICMP echo request
01:21:18.292524  IP 172.20.5.199 > 10.0.0.101: ICMP echo reply
control-plane01이 우리 노드의 파드 IP에게 ping을 보내고 있습니다. 172.20.5.199가 어느 파드인지 찾아보니, 일반 파드가 아니었습니다.
$ kubectl exec -n kube-system ds/cilium -c cilium-agent -- cilium-dbg endpoint list
ENDPOINT   IDENTITY   LABELS            IPv4           STATUS
559        4          reserved:health   172.20.5.199   ready
Cilium이 노드마다 하나씩 만들어두는 health 전용 엔드포인트입니다. cilium-health라는 구성요소가 모든 노드에서 모든 노드의 health 엔드포인트로 주기적으로 ping을 보내며 연결성을 감시합니다. 그리고 이 패킷이 Chap1에서 예고했던 "MAC은 나인데 IP는 내가 아닌 패킷은 쿠버네티스 노드의 일상"의 실측 증거입니다. 노드가 파드의 공유기 노릇을 하는 현장이 우연히 그물에 걸린 겁니다.
💡 tcpdump의
-n은 습관처럼 붙이게 됐습니다. 이 옵션이 없으면 tcpdump는 출력할 IP마다 DNS 역조회를 하고 나서 한 줄을 출력합니다. 관찰 행위가 새 DNS 패킷을 만들어내고, DNS 응답을 기다리느라 출력이 밀립니다. Chap1의 SSH 루프와는 다른 종류의 관찰자 효과입니다.
ss — 사물함 점검과 유령 IP
다음 도구는 ss(socket statistics)입니다. Chap1 물류센터 비유에서 패킷의 종착지가 소켓(사물함)이었는데, ss는 그 사물함들을 점검하는 도구입니다. 어떤 사물함이 열려 있고(LISTEN), 어떤 사물함이 누구와 대화 중이고(ESTAB), 주인 프로세스가 누구인지 보여줍니다.
이 도구로 풀고 싶었던 미스터리가 있습니다. 이전 관찰에서 우리 노드가 10.0.0.99:7443과 끊임없이 대화하는 것을 봤는데, 수상한 점이 둘입니다.
10.0.0.99는 어느 노드의 IP도 아닙니다 (노드는 101103, 111113)7443은 API 서버의 표준 포트(6443)도 아닙니다
먼저 누가 대화 중인지부터 색출했습니다.
$ sudo ss -tnp | grep 7443
ESTAB  10.0.0.113:37932  10.0.0.99:7443  users:(("kubelet",pid=1048,fd=24))
kubelet입니다. 그것도 연결이 딱 하나입니다. kubelet은 API 서버와 수십 가지 리소스를 주고받지만, HTTP/2 멀티플렉싱으로 연결 하나에 대화 수십 갈래를 꽂아 씁니다. 사물함 하나로 모든 업무를 처리하는 셈입니다.
주소록 탐문
그럼 10.0.0.99는 누구인가. IP의 신원을 모를 때 쓸 수 있는 가장 낮은 수준의 탐문이 ARP 주소록 대조입니다.
$ ip neigh show 10.0.0.99
10.0.0.99  dev ens18 lladdr bc:24:11:cd:8a:d3 REACHABLE

$ ip neigh | grep -E "10.0.0.10[123]"
10.0.0.101 dev ens18 lladdr bc:24:11:cd:8a:d3 REACHABLE   ← 같은 MAC!
10.0.0.102 dev ens18 lladdr bc:24:11:c1:d1:7f REACHABLE
10.0.0.103 dev ens18 lladdr bc:24:11:08:e2:20 REACHABLE
10.0.0.99의 MAC이 control-plane01의 MAC과 같습니다. 유령 IP는 지금 CP01의 NIC에 얹혀 살고 있습니다. NIC 하나가 IP 두 개의 ARP에 응답하고 있는 겁니다.
"머신에는 IP가 하나"라는 오해
여기서 제가 갖고 있던 오해 하나를 깨야 했습니다. CP01 = 10.0.0.101이라고 생각하면, dst=10.0.0.99인 패킷을 CP01이 받으려면 뭔가 주소 변환이 필요할 것 같습니다. 하지만 커널의 실제 동작은 다릅니다.
커널은 "내 IP 목록"을 관리하고, 그 목록의 어느 것으로 온 패킷이든 다 받습니다. IP는 머신의 단일 정체성이 아니라 목록에 추가/삭제되는 항목일 뿐입니다. 이 IP를 목록에 넣고 빼는 일을 하는 것이 keepalived라는 데몬입니다. keepalived가 하는 일의 전부는 사실 이것입니다.
# keepalived가 선출된 노드에서 실행하는 일:
ip addr add 10.0.0.99/32 dev ens18    # 내 IP 목록에 한 줄 추가
# + gratuitous ARP 한 발: "10.0.0.99는 내 MAC이야"라고 동네에 공지
이렇게 노드들 사이를 떠돌아다닐 수 있는 IP를 VIP(Virtual IP)라고 부릅니다. CP01이 죽으면 다른 CP의 keepalived가 같은 일을 하고, 모든 노드의 주소록이 갱신되고, VIP는 이사를 마칩니다.
패킷이 도착한 다음에는 사물함 매칭이 남는데, 여기에 한 가지 장치가 더 있습니다. 사물함(소켓)을 만들 때 라벨을 두 방식으로 붙일 수 있습니다.
| bind 주소 | 의미 | dst=10.0.0.99:7443 매칭? |
|---|---|---|
10.0.0.101:7443 |
101 앞으로 온 7443 소포만 | 안 됨 |
0.0.0.0:7443 |
내 IP 목록 중 뭐로 왔든 7443이면 전부 | 됨 |
0.0.0.0 와일드카드로 바인딩해두면, 미래에 VIP가 추가되든 IP가 몇 개가 되든 그 포트로 온 패킷을 전부 받습니다. 그래서 VIP 구성에서는 패킷 헤더를 단 한 바이트도 고칠 필요가 없습니다. keepalived의 VIP는 NAT가 아니라, 목적지 주소 자체가 "내 것"이 되는 방식입니다.
7443의 정체
남은 의문은 포트입니다. API 서버는 6443인데 왜 7443인가. 이건 설정 파일 대신 동작으로 확인했습니다. VIP가 없는 노드까지 포함해서 포트를 두드려본 겁니다.
$ curl -ks https://10.0.0.99:7443/version   | grep gitVersion   # 응답함
$ curl -ks https://10.0.0.101:7443/version  | grep gitVersion   # 응답함
$ curl -ks https://10.0.0.102:7443/version  | grep gitVersion   # VIP 없는 노드인데 응답함!
$ curl -ks https://10.0.0.102:6443/version  | grep gitVersion   # 응답함
VIP가 없는 CP02의 7443도 응답합니다. 즉 7443 리스너는 VIP에 붙은 것이 아니라 CP 3대 모두에 떠 있습니다. 그 정체는 haproxy입니다. 각 CP에서 haproxy가 0.0.0.0:7443을 듣고, 뒤에 있는 API 서버 3대(10.0.0.101~103:6443)로 분배합니다.
그럼 왜 haproxy는 6443을 쓰지 않았을까요. 같은 머신에서 kube-apiserver가 이미 0.0.0.0:6443을 잡고 있기 때문입니다. 와일드카드 바인딩은 모든 로컬 IP의 해당 포트를 점유하므로, haproxy가 "나는 VIP 전용으로 10.0.0.99:6443만 쓸게"라고 해도 Address already in use로 거절당합니다. LB와 API 서버를 같은 머신에 두는 구성(kubeadm 문서의 stacked 토폴로지)에서는 LB가 다른 포트로 비켜나는 수밖에 없고, 그게 7443이었습니다.
이제 전체 그림이 맞춰집니다.
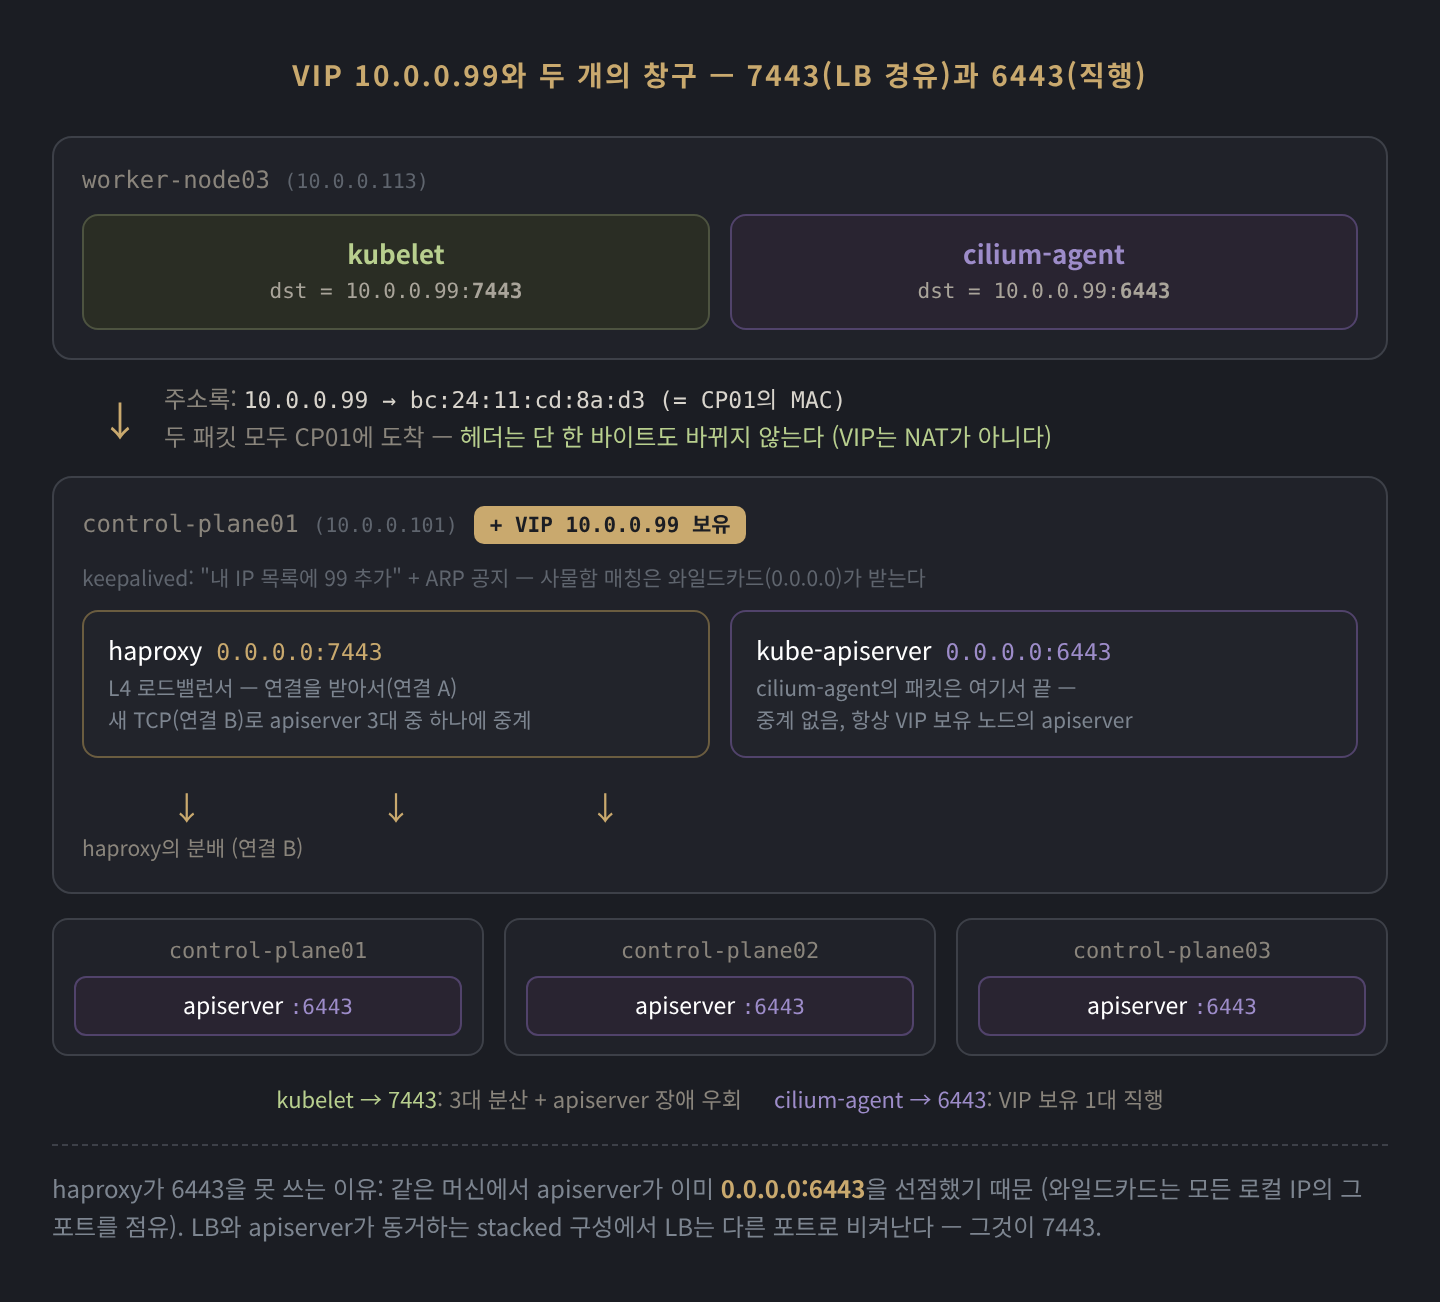
그림에서 눈에 걸리는 부분이 하나 있을 겁니다. kubelet은 7443(LB 창구)으로 가는데 cilium-agent만 6443으로 직행합니다. 같은 VIP를 쓰면서 왜 포트가 다른지, 이게 의도된 구성인지는 뒤의 운영 노트에서 따로 다룹니다. 일단 여기서는 "두 경로 모두 동작한다"는 것만 확인하고 넘어가겠습니다.
정리하면 구성요소별 역할은 이렇습니다.
| 구성요소 | 위치 | 역할 |
|---|---|---|
| keepalived | CP 3대 (systemd) | VIP 10.0.0.99의 소유권 관리 — 선출된 노드의 IP 목록에 추가 + ARP 공지 |
| haproxy | CP 3대 (systemd), 0.0.0.0:7443 |
L4 로드밸런서 — 받은 연결을 API 서버 3대 중 하나로 중계 |
| kube-apiserver | CP 3대 (static pod), 0.0.0.0:6443 |
API 서버 본체 |
둘 다 systemd 서비스라는 점도 의미가 있습니다. Chap2의 부트스트랩 사다리로 말하면 0층보다 아래에 사는 존재들입니다. 쿠버네티스가 전부 죽어도 API 서버로 가는 길은 살아 있어야 하니까요.
failover 분해하기
VIP가 있으니 CP01이 죽어도 안전하다, 까지는 누구나 압니다. 그런데 "kubelet의 그 ESTAB 연결은 어떻게 되는가?"를 따라가 보면 더 정확한 그림이 나옵니다. 저는 처음에 "VIP가 그대로니까 연결도 살아서 이어진다"고 답했는데, 오답이었습니다.
TCP 연결의 상태는 네트워크 어딘가가 아니라 양 끝 머신의 커널 메모리에 삽니다. haproxy는 L4 프록시라서 연결을 자기가 직접 받기 때문에, kubelet 하나가 붙으면 실제로는 연결이 두 개 생깁니다.
[연결 A]                            [연결 B]
kubelet ←────→ haproxy(CP01) ←────→ apiserver
                  │
                  └─ CP01 메모리의 장부: 연결 A·B의 seq 번호, "A로 온 것은 B로" 매핑
CP01이 죽으면 이 장부가 메모리와 함께 증발합니다. CP02의 haproxy도 이미 떠서 돌고 있지만, 각자의 장부는 각자의 것입니다. CP01이 자기 연결 상태를 CP02에 실시간으로 알려주는 채널은 없습니다.
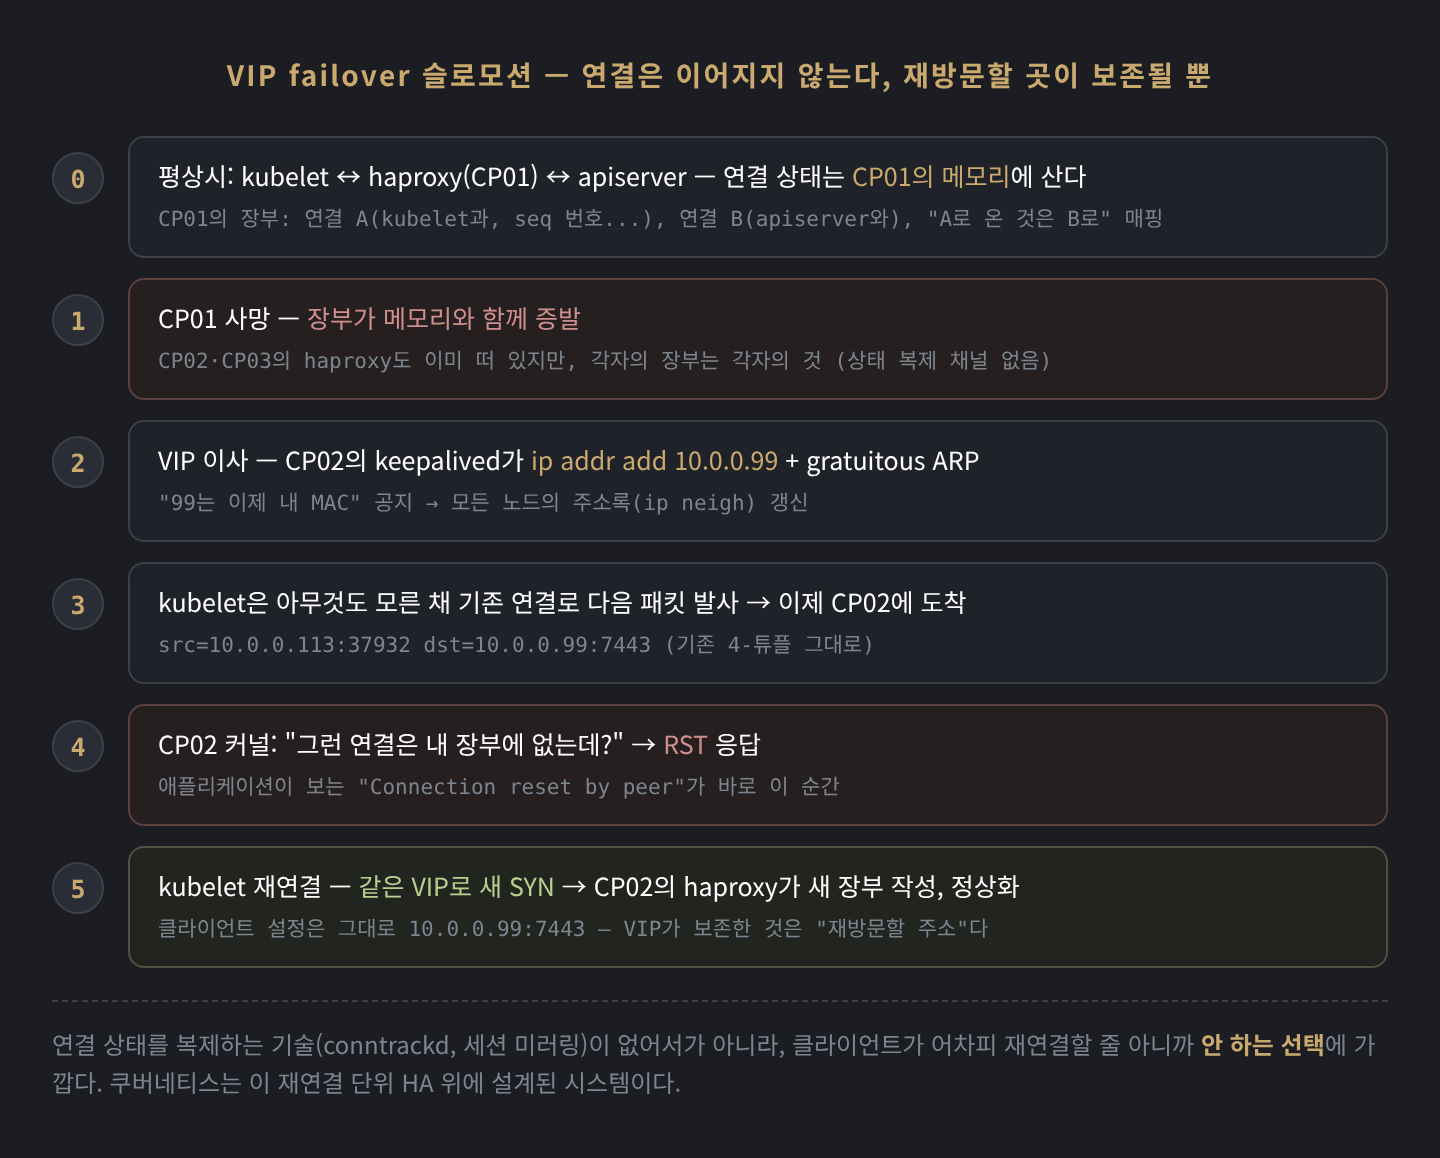
그래서 failover의 실제 순서는 이렇게 됩니다.
- CP01 사망 → 장부 증발
- VIP가 CP02로 이사 (gratuitous ARP → 모든 노드 주소록 갱신)
- kubelet은 아무것도 모른 채 기존 연결로 다음 패킷 발사 → CP02에 도착
- CP02 커널: "그런 연결은 내 장부에 없는데?" → RST 응답
- kubelet 재연결 → 같은 VIP로 → 이번엔 CP02의 haproxy가 새 장부를 만들고 정상화
애플리케이션 에러 메시지 Connection reset by peer가 바로 4번에서 RST를 맞았다는 뜻입니다. 정리하면, VIP failover는 "대화를 잇는" 것이 아니라 "재방문할 곳을 보존하는" 것에 가깝습니다. 끊김 없는 이전이 아니라 재연결 단위의 HA입니다. 연결 상태를 복제하는 기술(conntrackd, 상용 LB의 세션 미러링)이 없어서가 아니라, 클라이언트가 어차피 재연결할 줄 아니까 안 하는 선택에 가깝습니다. 쿠버네티스 전체가 이 철학 위에 있습니다. watch가 끊기면 다시 걸면 되고, 컨트롤러는 상태를 다시 읽으면 됩니다.
💡 이 "ARP로 IP 소유권을 주장하는" 방식은 MetalLB L2 모드가 LoadBalancer IP로 하는 일과 같은 원리입니다. 그래서 keepalived의 VIP 대역과 MetalLB의 IP 풀은 절대 겹치면 안 됩니다. 같은 기술을 쓰는 두 주인이 한 IP를 두고 싸우게 됩니다.
IP - 노드 IP, VIP, ClusterIP
여기까지 오면 이 클러스터에 사는 IP 세 부류를 구분할 수 있게 됩니다. ss 출력에 우연히 셋의 차이가 모두 담겨 있었습니다.
$ sudo ss -tnp | grep -E ":7443|:6443"
ESTAB  10.0.0.113:48840  10.0.0.101:6443  users:(("speaker",...))        ← ?
ESTAB  10.0.0.113:33002  10.0.0.99:6443   users:(("cilium-agent",...))   ← ??
ESTAB  10.0.0.113:37932  10.0.0.99:7443   users:(("kubelet",...))
speaker(MetalLB)의 줄이 이상합니다. speaker는 설정상 kubernetes 서비스의 ClusterIP(10.96.0.1:443)로 API에 접속하는데, 소켓에는 진짜 엔드포인트(10.0.0.101:6443)가 찍혀 있습니다. Cilium의 서비스 맵을 보면 답이 나옵니다.
$ kubectl exec -n kube-system ds/cilium -c cilium-agent -- cilium-dbg service list
ID   Frontend            Service Type   Backend
20   10.96.0.1:443/TCP   ClusterIP      1 => 10.0.0.101:6443/TCP (active)
eBPF Socket LB가 connect() 호출 순간에 목적지를 바꿔치기해서, 소켓 테이블에조차 ClusterIP가 남지 않습니다. ClusterIP가 와이어는커녕 자기 머신의 소켓 목록에도 없는 겁니다. 이 동작 원리는 별도 편에서 제대로 다루겠지만, 표 한 장으로 세 부류를 미리 정리해 둡니다.
| 노드 IP (10.0.0.113) | VIP (10.0.0.99) | ClusterIP (10.96.0.1) | |
|---|---|---|---|
| NIC에 할당 | 됨, 고정 | 됨, 단 이사 다님 | 안 됨 — 어디에도 없음 |
| ARP 응답 | 그 노드가 | 현재 소유한 CP가 | 아무도 안 함 |
| 와이어에 등장 | 함 | 함 | 안 함 — connect() 순간 변환됨 |
| 실체 | 머신의 주소 | keepalived가 옮기는 간판 | 커널 변환 테이블의 키 |
Chap2에서 라우팅 테이블 12줄을 읽을 때 10.96.x.x 대역이 한 줄도 없었던 이유도 이 표로 설명됩니다. ClusterIP는 라우팅의 대상이 아니라 변환의 대상입니다.
운영 노트 — cilium-agent의 목적지
위 ss 출력에서 둘째 줄도 그냥 지나칠 수 없었습니다. cilium-agent가 10.0.0.99:6443에 붙어 있습니다. VIP인데 포트가 7443이 아니라 6443입니다.
cilium-agent에게 이 연결은 생명줄입니다. 우리 클러스터는 Cilium의 자체 저장소(KVStore)를 끄고 모든 상태를 쿠버네티스 CRD로 관리하는 구성이라, agent에게 API 서버는 유일한 컨트롤플레인 채널입니다. 서비스가 바뀌면 eBPF 맵을 갱신하고, 파드를 배선하면 CiliumEndpoint를 등록하는 일이 전부 이 연결로 흐릅니다. (이 연결이 끊겨도 datapath는 커널에서 계속 돕니다. 멈추는 것은 "변경 반영"뿐입니다. 이 분리는 아키텍처 편에서 자세히 다룹니다.)
그 생명줄이 LB 창구(7443)가 아니라 API 서버 본체 포트(6443)로 직행하고 있다는 뜻입니다. helm 값을 확인하니 설치할 때 넣은 값이 그랬습니다.
$ helm get values cilium -n kube-system | grep k8sService
k8sServiceHost: 10.0.0.99
k8sServicePort: 6443        # ← 7443이 아니다
helm 리비전 탐색
왜 6443이 됐는지 기억이 나지 않아서, helm 리비전 이력을 발굴했습니다. helm은 리비전마다 당시의 값을 통째로 보관하고 있어서, 이런 때 블랙박스 역할을 합니다.
$ helm history cilium -n kube-system
REVISION  UPDATED                   DESCRIPTION
1         Mon Oct  6 14:30:58 2025  Install complete
2         Fri Oct 10 05:41:04 2025  Upgrade complete
3         Fri Oct 10 05:41:37 2025  Upgrade complete
4         Fri Oct 10 10:03:54 2025  Upgrade complete
5         Fri Oct 10 10:06:16 2025  Upgrade complete

$ for r in 1 2 3 4 5; do helm get values cilium -n kube-system --revision $r | grep k8sServicePort; done
rev 1: 7443    ← 최초 설치는 LB 창구로 시작했다
rev 2: 6443    ← 새벽 5시 41분, 6443으로 변경
rev 3: 7443    ← 33초 뒤 원복
rev 4: (없음)  ← k8sServiceHost/Port가 통째로 빠짐
rev 5: 6443    ← 2분 30초 뒤, 6443으로 최종 정착
8개월 전 어느 금요일의 디버깅 세션이 그대로 찍혀 있습니다. 새벽에 33초짜리 시도와 원복이 있었고, 오전에 클러스터 최종 설정(native routing, L2 announcements 등이 rev5에서 한꺼번에 들어갔습니다)을 적용하다가 rev4에서 k8sServiceHost가 통째로 빠지는 사고가 났습니다. kube-proxy 없는 클러스터에서 이 값이 빠지면 agent가 API 서버를 찾을 방법이 없어집니다(Chap2의 닭-달걀 문제 그대로입니다). 2분 30초 만에 나온 rev5가 그 응급 복구였고, 그때 6443이 함께 들어와 지금까지 왔습니다.
6443 직행과 7443 경유의 차이
동작은 둘 다 합니다. 하지만 장애가 났을 때의 행동이 다릅니다.
| kubelet (VIP:7443) | cilium-agent (VIP:6443) | |
|---|---|---|
| 경로 | haproxy가 3대 중 선택 | VIP 소유 CP의 apiserver 직행 |
| 부하 분산 | 3대 분산 | 항상 VIP 소유자 1대 |
| apiserver 프로세스만 죽으면 | haproxy가 그 백엔드를 빼고 우회 — 무중단 | VIP는 안 움직이므로(노드는 살아 있으니) 멀쩡한 apiserver 2대를 두고도 접속 불가 |
| CP 노드가 통째로 죽으면 | VIP 이사 후 재연결 | 동일 |
7443 경유는 apiserver 프로세스 단위의 장애를 흡수하고, 6443 직행은 노드 단위 장애만 흡수합니다. 그래서 7443으로 교정하는 것이 원래 설계에 맞는데, 무턱대고 바꾸지 않고 과제로 남겨뒀습니다. haproxy의 idle 타임아웃 기본값(약 50초)이 agent의 장시간 watch 연결을 주기적으로 끊는 문제가 알려져 있어서, CP의 haproxy 타임아웃 설정을 먼저 확인해야 합니다. 어쩌면 그게 그 새벽 5시 41분의 범인이었을지도 모릅니다. 확인 결과는 KPR(kube-proxy replacement)을 다루는 편에서 이어가겠습니다.
💡 이번 발굴에서 얻은 교훈: helm 값을 바꾸기 전에
helm get values로 백업하고 리비전 번호를 기록해두면, helm rollback이 타임머신이 됩니다. rev4 → rev5의 2분 30초짜리 복구가 가능했던 것도 이 구조 덕분입니다.
conntrack
마지막 도구입니다. Chap2에서 masquerade 규칙(파드가 클러스터 밖으로 나갈 때 출발지를 노드 IP로 바꿔치기)을 봤는데, 변장에는 숙제가 하나 따라옵니다. 답장이 오면 원래 주인을 찾아줘야 합니다.
파드 172.20.5.82가 1.1.1.1로 나가면서 출발지를 10.0.0.113으로 변장했다면, 1.1.1.1의 답장은 10.0.0.113으로 옵니다. 노드 자신에게 온 것인지, 어느 파드의 것인지 구분할 방법이 필요합니다. 변장시킬 때 장부에 적어두지 않으면 답장은 미아가 됩니다. 그 장부가 커널의 conntrack 테이블입니다.
실제 장부를 열어봤습니다. 항목마다 두 방향이 기록되어 있습니다. 먼저 파드끼리의 통신(클러스터 내부행)입니다.
$ sudo conntrack -L | grep "src=172.20"
tcp  ESTABLISHED src=172.20.5.91 dst=172.20.0.10 sport=55628 dport=9200
                 src=172.20.0.10 dst=172.20.5.91 sport=9200  dport=55628
블로그 파드가 다른 노드의 Elasticsearch 파드(9200)와 통신 중인 항목입니다. 답장 방향의 dst가 파드 IP 그대로입니다. 변장이 없습니다. Chap2에서 본 masquerade 규칙의 조건(! -d 172.20.0.0/16 — 목적지가 클러스터 내부면 제외)이 그대로 동작하는 겁니다. 내부행은 native routing이 끝까지 배달하니 변장할 이유가 없습니다.
다음은 외부행입니다. 테스트 파드에서 1.1.1.1로 요청 하나를 만들어 장부를 봤습니다.
$ sudo conntrack -L | grep "dst=1.1.1.1"
tcp  TIME_WAIT  src=172.20.5.82 dst=1.1.1.1    sport=53402 dport=80    ← 원래 방향: 진짜 신원
                src=1.1.1.1     dst=10.0.0.113 sport=80    dport=53402 ← 답장 방향: 변장된 모습
원래 방향에는 파드의 진짜 신원이, 답장 방향에는 변장된 모습(dst=노드 IP)이 적혀 있습니다. 1.1.1.1의 답장이 dst=10.0.0.113으로 도착하면, 커널이 이 장부를 보고 172.20.5.82로 복원해서 배달합니다.
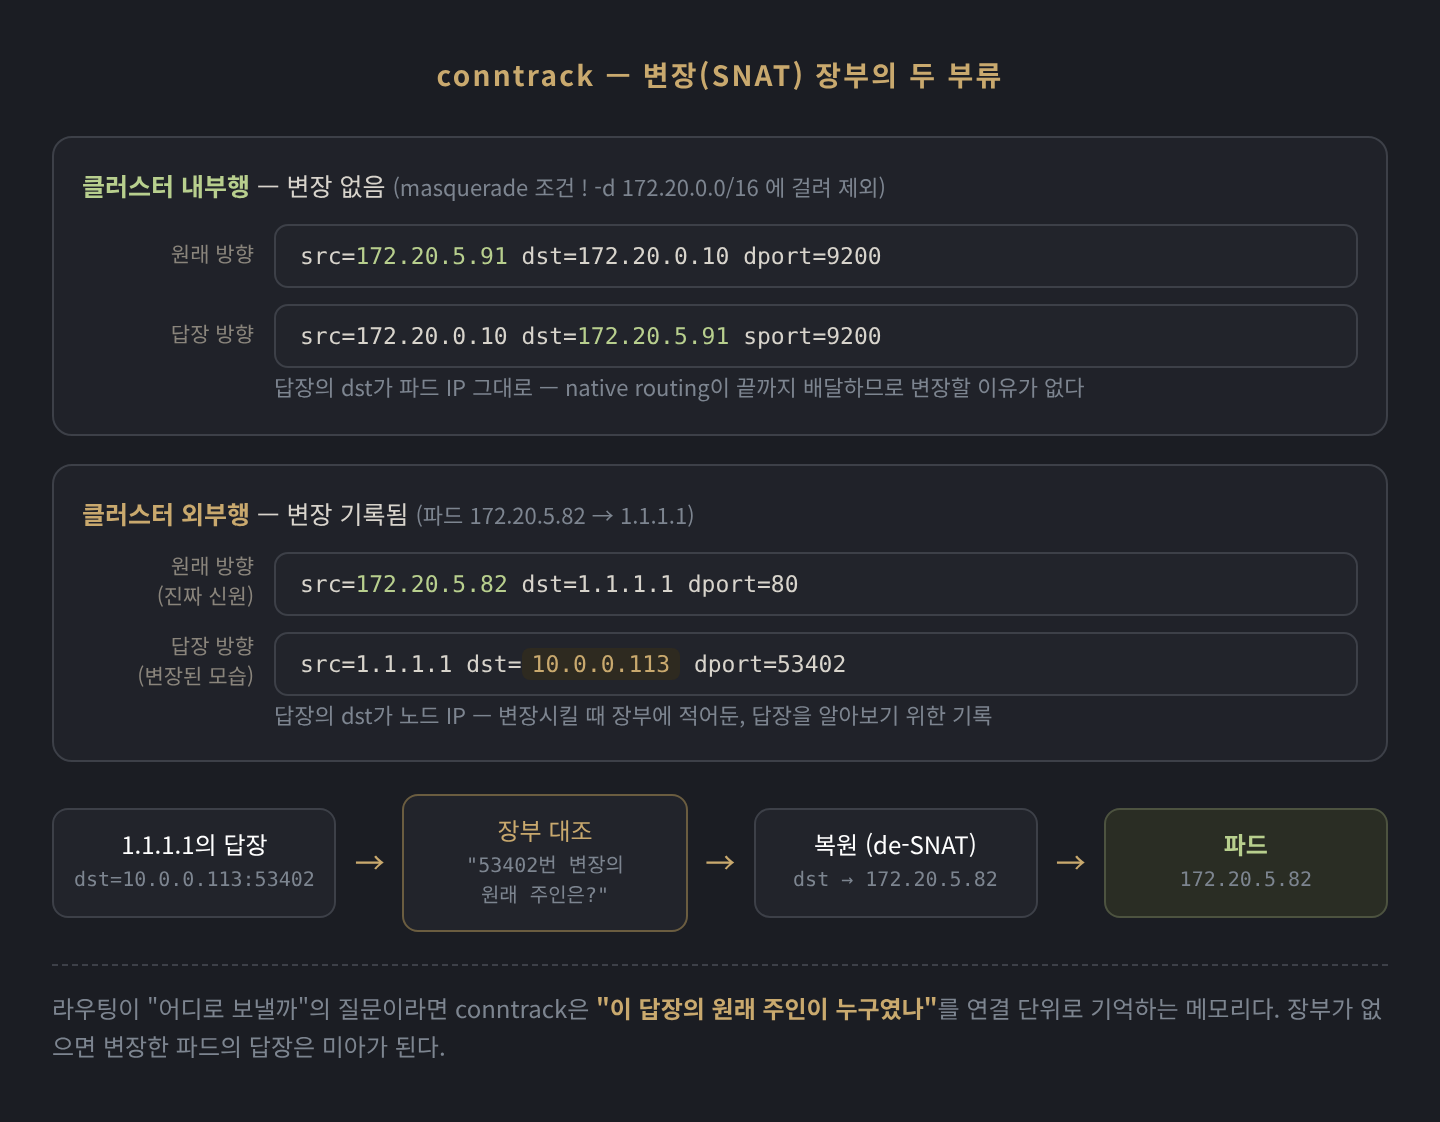
Chap2에서 "라우팅(어디로 보낼까)과 NAT(출발지를 뭐라고 적을까)는 다른 질문"이라고 정리했는데, conntrack은 그 NAT 질문의 답을 연결 단위로 기억하는 메모리였습니다.
💡 한 가지 짚어둘 점: Cilium은 자체 BPF conntrack을 따로 갖고 있습니다(
cilium-dbg bpf ct list). 위에서 본 것은 커널 netfilter의 conntrack인데, 우리 클러스터는 masquerade를 iptables에 위임한 구성(masquerade=iptables)이라 변장 장부가 여기에 남습니다. masquerade까지 eBPF로 옮기는 옵션(bpf.masquerade=true)도 있는데, 그때는 이 장부가 BPF 맵으로 이사합니다. 데이터패스 편에서 다룹니다.
TL;DR
이번 편의 핵심을 정리하면 다음과 같습니다.
- 첫 ping의 RTT에는 ARP 왕복이 숨어 있다. 커널은 MAC을 알 때까지 패킷을 들고 기다린다. tcpdump의 타임스탬프로 이것을 직접 쪼개볼 수 있다.
- 머신에는 IP가 하나가 아니라 "IP 목록"이 있다. keepalived의 VIP는 그 목록에 항목을 넣고 빼는 것 + ARP 공지가 전부다. 패킷은 단 한 바이트도 변환되지 않는다 — VIP는 NAT가 아니다.
- 7443은 포트 충돌의 산물이다. apiserver가
0.0.0.0:6443을 선점하면 같은 머신의 haproxy는 다른 포트로 비켜나야 한다(stacked 토폴로지). - VIP failover는 연결을 잇지 않는다. TCP 상태는 죽은 머신의 메모리와 함께 증발하고, 클라이언트는 RST를 맞고 같은 VIP로 재연결한다. 쿠버네티스는 이 재연결 단위 HA 위에 설계된 시스템이다.
- 이 클러스터의 IP는 세 부류다. 노드 IP(NIC에 고정), VIP(NIC 사이를 떠도는 간판), ClusterIP(어느 NIC에도 없는 변환 테이블의 키).
- conntrack은 변장(SNAT) 장부다. 외부행 연결만 답장 방향에 노드 IP가 기록되고, 내부행은 변장 없이 파드 IP 그대로 오간다.
- helm 리비전은 클러스터의 블랙박스다. 값 변경 전 백업과 리비전 기록이 타임머신을 만든다.
다음 편 예고
다음 편은 시스템에 더 깊게 들어갑니다. 쿠버네티스 없이 리눅스 명령만으로(netns + veth + 라우팅) 파드 네트워크를 맨손으로 만들어보고, CNI가 하는 일이 정확히 무엇인지 바닥에서부터 확인해보겠습니다.