
쿠버네티스 없이 파드 네트워크 만들기
🔍 Cilium 스터디 시리즈
지금까지(Chap2~3)는 이미 만들어져 있는 파드 네트워크를 관찰만 했습니다. lxc 케이블, 172.20.x 파드 IP, native routing 6줄을 읽기 전용 명령으로 들여다봤습니다. 이번 편에서는 반대로 그것을 직접 만들어 봅니다. 쿠버네티스도 Cilium도 없이 ip 명령만으로 파드 두 개를 만들고 서로 통신시키는 것이 목표입니다. 다 만들고 나면 CNI가 파드마다 자동으로 해주는 일이 무엇인지 분명해집니다.
이번 편의 명령은 모두 격리된 network namespace 안에서 일어나고,
ip netns del한 번으로 정리됩니다. 다만 실제 Cilium이 돌고 있는 노드에서 그대로 하면 뒤에서 설명할 이유로 막히는 부분이 있어, 깨끗한 리눅스 호스트(또는 일회용 VM)를 기준으로 진행합니다.
network namespace로 빈 파드 만들기
파드가 가진 "격리된 네트워크 세계"의 실체는 리눅스 커널의 network namespace(이하 netns)입니다. netns를 하나 만들면 그 안은 자기만의 인터페이스 목록, 자기만의 라우팅 테이블, 자기만의 ARP 주소록을 가진 독립된 공간이 됩니다.
# netns 2개 생성 (빈 파드 2개)
$ sudo ip netns add lab-pod-a
$ sudo ip netns add lab-pod-b

# 방금 만든 파드 a의 네트워크 상태 확인
$ sudo ip netns exec lab-pod-a ip addr
1: lo: <LOOPBACK> mtu 65536 ... state DOWN
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00

$ sudo ip netns exec lab-pod-a ip route
(아무것도 없음)
ip netns exec lab-pod-a <명령>은 그 파드의 네트워크 공간 안에서 명령을 실행하라는 뜻입니다. 결과를 보면 바깥과 연결되는 인터페이스가 하나도 없고, 자기 자신을 가리키는 lo(루프백)만 있는데 그마저 DOWN 상태입니다. 라우팅 테이블도 비어 있습니다. 아직 아무 데도 연결되지 않은 빈 공간입니다.
쿠버네티스에서
pause컨테이너(샌드박스)가 하는 일이 이 빈 netns를 붙들고 있는 것입니다. 파드 안 컨테이너가 재시작돼도 IP가 유지되는 이유는, pause가 이 netns를 계속 잡고 있기 때문입니다.
veth pair로 케이블 연결하기
이 격리된 공간을 바깥과 잇는 도구가 veth pair입니다. veth는 항상 쌍으로 만들어지는 가상 인터페이스로, 한쪽 끝에 들어간 패킷이 반대쪽 끝으로 그대로 나옵니다. Chap2에서 본 lxc가 이 케이블의 노드 쪽 끝이었습니다.
# 케이블 하나를 만들면서, 한쪽 끝(eth0)을 곧바로 파드 netns 안에 넣는다
$ sudo ip link add lab-veth-a type veth peer name eth0 netns lab-pod-a
$ sudo ip link add lab-veth-b type veth peer name eth0 netns lab-pod-b
이 한 줄을 토막 내면 의미가 보입니다. type veth는 쌍으로 만들어지는 가상 케이블이라는 뜻이고, peer name eth0은 반대쪽 끝의 이름을 eth0으로 지정합니다. netns lab-pod-a는 그 반대쪽 끝을 만들자마자 lab-pod-a 안으로 옮기라는 뜻입니다. 결과적으로 케이블 하나를 만들면서 한쪽 끝은 호스트에 남기고 다른 쪽 끝은 파드 안에 넣는 작업을 한 번에 합니다.
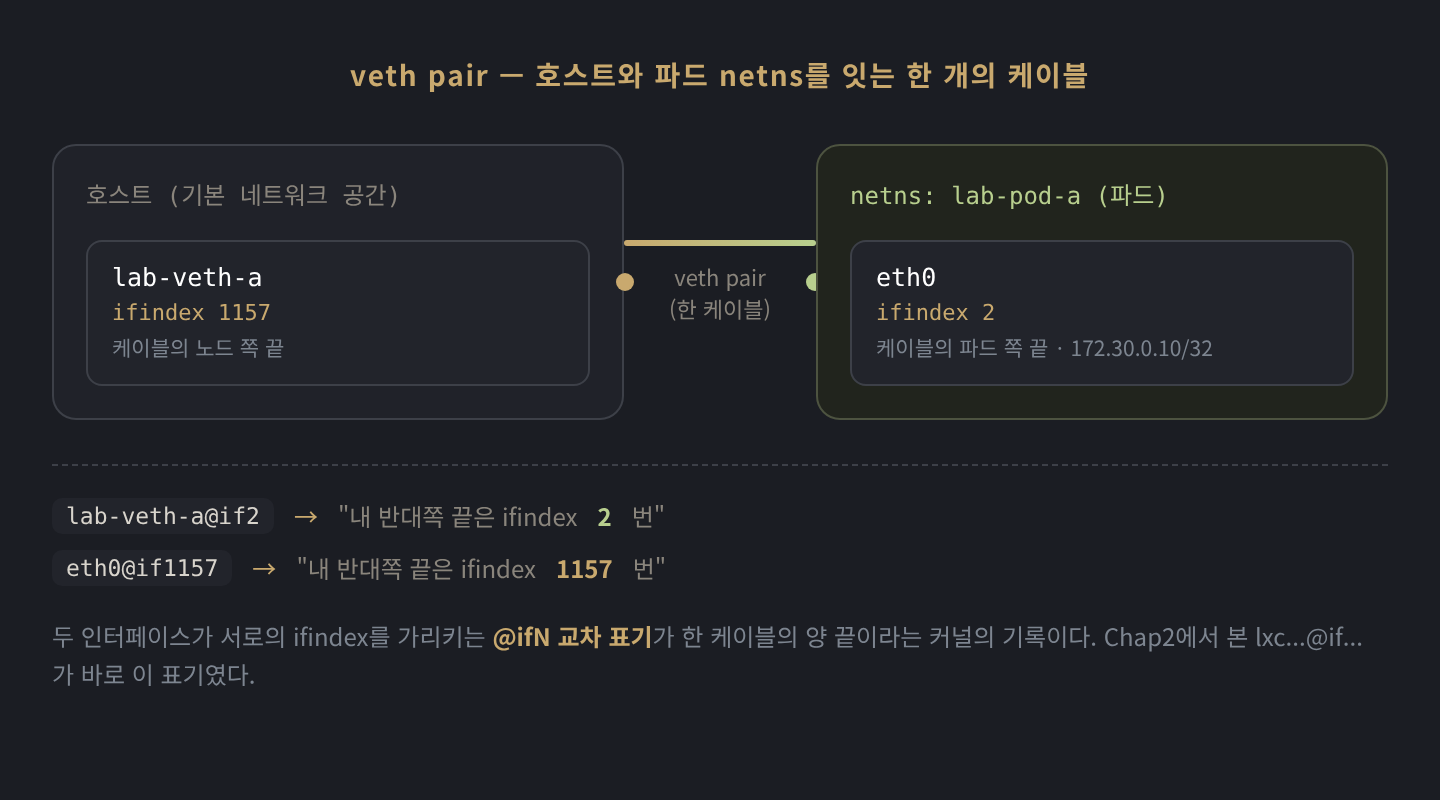
만든 다음 양쪽 끝을 확인하면, 둘이 서로를 가리키고 있습니다.
# 호스트 쪽 케이블 끝
$ ip link show lab-veth-a
1157: lab-veth-a@if2: ... link-netns lab-pod-a

# 파드 a 안의 케이블 끝
$ sudo ip netns exec lab-pod-a ip addr
2: eth0@if1157: ...
호스트의 lab-veth-a는 ifindex가 1157이고 @if2로 "반대쪽은 2번"이라 적혀 있습니다. 파드의 eth0은 ifindex가 2이고 @if1157로 "반대쪽은 1157번"이라 적혀 있습니다. 두 인터페이스가 서로의 번호를 정확히 가리키는 이 교차 표기가 한 케이블의 양 끝이라는 커널의 기록입니다. Chap2에서 lxc...@if... 형태로 봤던 것이 이것입니다.
케이블 종류가 곧 CNI 설계다
방금 우리는 type veth를 골랐습니다. 그런데 ip link add ... type <X>의 X 자리에는 다른 종류도 들어갈 수 있고, 무엇을 고르느냐가 CNI의 데이터패스 설계를 좌우합니다. 네 가지를 패킷이 어떻게 흐르는지를 기준으로 비교해 보겠습니다.
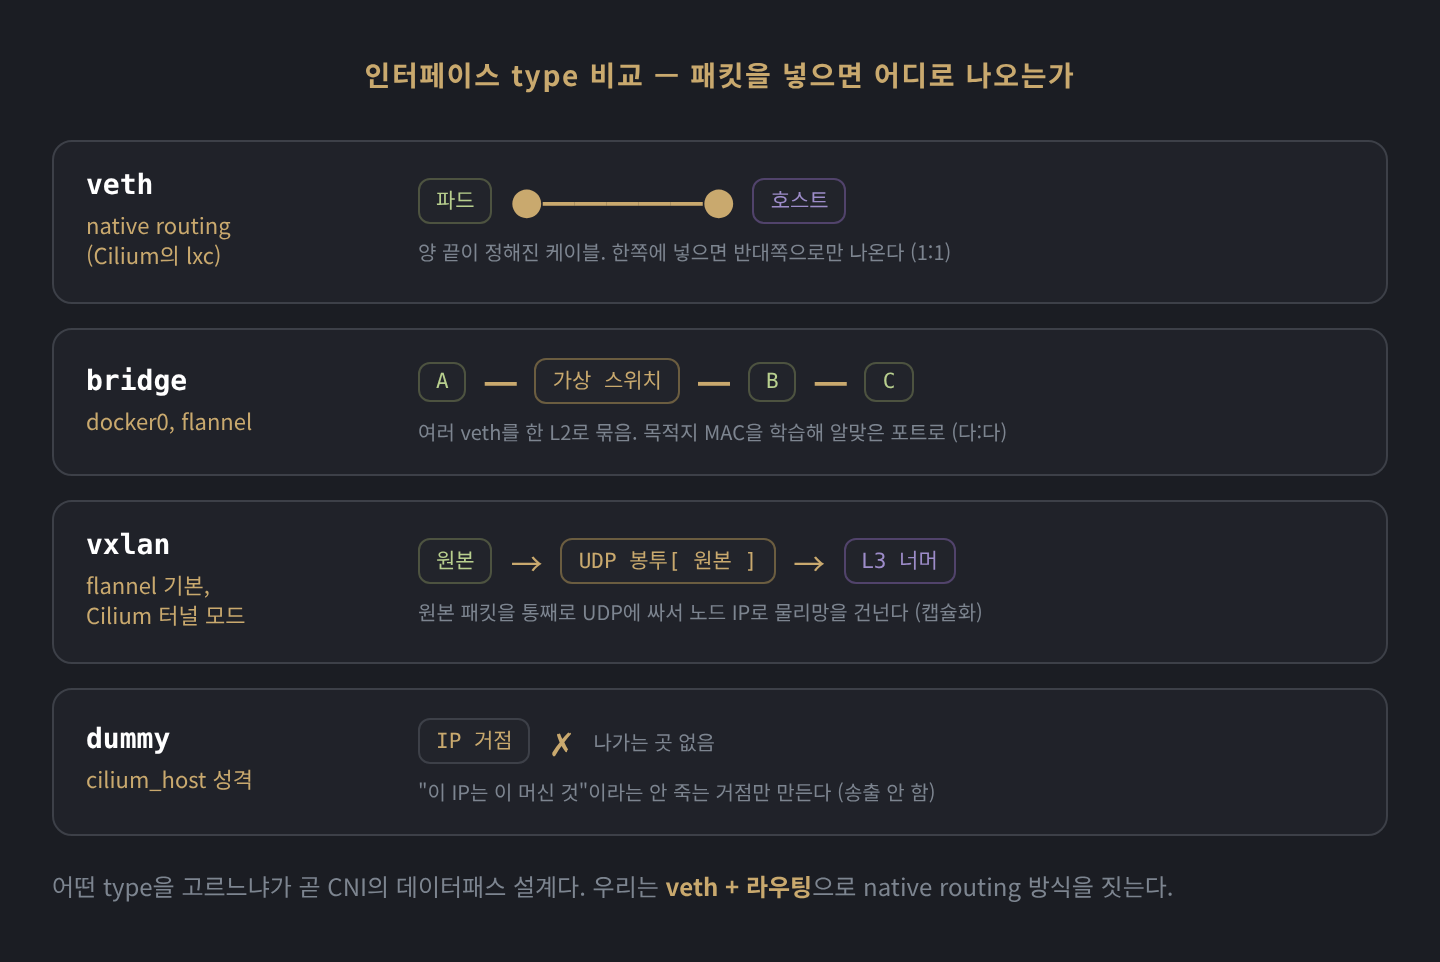
veth는 양 끝이 정해진 케이블입니다. 한쪽에 들어간 패킷은 반대쪽으로 나오며, 그 사이에 분기나 판단이 없습니다. 다만 케이블은 양 끝뿐이라 veth만으로는 파드 셋 이상을 서로 잇지 못합니다.
bridge는 가상 스위치입니다. veth들의 호스트 쪽 끝을 여기에 꽂으면 여러 파드가 하나의 L2로 묶입니다. 들어온 패킷의 목적지 MAC을 학습해서 알맞은 포트로 보냅니다. docker의 docker0, flannel의 일부 모드가 이 방식입니다.
vxlan은 L3 위에 까는 L2 터널입니다. 원본 패킷을 통째로 UDP 패킷 안에 넣어 노드 IP로 물리망을 건넌 뒤, 반대편에서 다시 꺼내 복원합니다. 노드들이 같은 L2에 있지 않아도 되는 대신 캡슐화 비용이 듭니다. flannel 기본 모드, Cilium 터널 모드가 vxlan을 씁니다.
dummy는 나가는 곳이 없는 인터페이스입니다. "이 IP는 이 머신의 것"이라는 안정적인 거점만 만드는 용도입니다. Chap2에서 172.20.5.0/24 dev cilium_host로 봤던 cilium_host가 이 성격에 가깝습니다.
우리가 veth만 쓰고 bridge를 두지 않는 것은, bridge로 묶는 docker나 flannel 방식이 아니라 라우팅으로 잇는 Cilium의 native routing 방식을 따라가겠다는 선택입니다. Chap2에서 "flannel이었다면 와이어에서 UDP로 한 번 더 포장됐을 것"이라고 한 차이가 바로 이 type 선택에서 갈립니다.
vxlan은 왜 UDP로 싸는가
vxlan을 처음 보면 "원본 패킷을 UDP로 감싼다니, 계층이 거꾸로 아닌가" 하는 의문이 듭니다. 정상적인 패킷은 한 번에 한 층씩 쌓이지만(이더넷 위에 IP, 그 위에 TCP, 그 위에 데이터), 터널은 완성된 패킷 하나를 통째로 바이트 덩어리로 취급해서 새 패킷의 데이터 자리에 넣는 방식이라 계층 순서를 따르지 않습니다. UDP 입장에서 데이터 자리에 무엇이 들었는지는 상관이 없습니다. 거기에 또 다른 완성 패킷이 통째로 들어 있어도 그냥 정해진 길이만큼의 데이터일 뿐입니다.
운송 수단으로 UDP를 고른 이유는 터널이 가볍고 단순할수록 좋기 때문입니다. 재전송이나 순서 보장 같은 일은 안에 든 원본 패킷의 TCP가 알아서 합니다. 바깥 봉투까지 TCP면 안쪽 TCP와 제어가 겹쳐 성능이 나빠집니다. 또 UDP로 보내면 기존 네트워크 장비들이 평범한 UDP 트래픽으로 취급해 그대로 통과시킵니다.
받는 쪽은 까서 나온 것이 무엇인지 어떻게 알까요. 각 헤더에는 다음 층이 무엇인지 알려주는 번호가 있습니다(이더넷의 EtherType, IP의 Protocol 번호, UDP나 TCP의 포트 번호). vxlan은 그중 UDP 목적지 포트가 "여기서부터 이더넷 프레임이 통째로 들어 있다"는 신호 역할을 합니다. 표준 포트는 IANA가 정한 4789인데, 리눅스 커널은 표준화 이전에 먼저 구현하면서 8472를 기본값으로 정했고 하위 호환 때문에 지금도 그대로입니다(flannel, Cilium 터널 모드도 8472). 그래서 "vxlan은 항상 특정 포트"라기보다, 한 터널에 참여하는 모든 노드가 같은 포트로 합의되어 있어야 한다는 것이 핵심입니다. 방화벽이 이 UDP 포트를 막으면 노드 간 파드 통신이 통째로 끊기는 경우가 현장에서 자주 나옵니다.
IP는 왜 /32로 주는가
이제 케이블에 전원을 켜고 파드에 IP를 줍니다. 여기서 Cilium 방식의 특징이 하나 나타납니다. 보통은 IP를 /24 같은 서브넷으로 주지만, Cilium은 파드에 /32, 즉 자기 혼자만의 주소를 주고 라우팅으로 연결합니다. 우리도 그 방식을 따릅니다.
# 호스트 쪽 케이블 끝 활성화
$ sudo ip link set lab-veth-a up
$ sudo ip link set lab-veth-b up

# 파드 a: lo와 eth0 활성화, /32 IP 부여
$ sudo ip netns exec lab-pod-a ip link set lo up
$ sudo ip netns exec lab-pod-a ip link set eth0 up
$ sudo ip netns exec lab-pod-a ip addr add 172.30.0.10/32 dev eth0

# 파드 b도 동일하게 172.30.0.11/32
$ sudo ip netns exec lab-pod-b ip link set lo up
$ sudo ip netns exec lab-pod-b ip link set eth0 up
$ sudo ip netns exec lab-pod-b ip addr add 172.30.0.11/32 dev eth0

# a에서 b로 ping
$ sudo ip netns exec lab-pod-a ping -c 1 172.30.0.11
ping: connect: Network is unreachable
IP를 양쪽에 다 줬는데도 Network is unreachable입니다. 라우팅 테이블을 보면 이유가 나옵니다.
$ sudo ip netns exec lab-pod-a ip route
(아무것도 없음)
보통 IP를 인터페이스에 붙이면 커널이 "이 주소가 속한 서브넷은 이 인터페이스로 직접 도달 가능"이라는 경로를 자동으로 추가합니다. 그런데 /32는 서브넷에 자기 혼자뿐이라 직접 도달할 이웃이 없고, 그래서 자동으로 생기는 경로 자체가 없습니다. 나갈 길이 없으니 라우팅 단계에서 바로 실패합니다.
라우팅 테이블은 하나가 아니다
"그럼 자기 자신(172.30.0.10)으로 가는 경로는 어디 있나" 싶지만, 그것은 다른 테이블에 있습니다. 커널의 라우팅은 여러 테이블로 나뉘어 있고, ip route는 그중 main 하나만 보여주는 약식 명령입니다.
$ sudo ip netns exec lab-pod-a ip route show table local
local 172.30.0.10 dev eth0 scope host src 172.30.0.10   # 나에게 온 패킷은 내가 받는다
local 127.0.0.0/8 dev lo ...                            # 루프백
| 테이블 | 답하는 질문 | 파드 a의 내용 |
|---|---|---|
local |
이 패킷이 나에게 온 것인가 | 172.30.0.10(자기 자신), 127.x. 커널이 IP 부여 시 자동 생성 |
main (ip route) |
이 패킷을 어디로 내보낼까 | 비어 있음 |
local은 들어오는 쪽을, main은 나가는 쪽을 담당합니다. 방금 ping이 실패한 것은 들어오는 쪽은 채워졌지만 나가는 쪽이 비어서, 172.30.0.11로 나갈 경로가 없었기 때문입니다. 커널은 패킷을 처리할 때 local을 먼저 확인하고, 자기 것이 아니면 main으로 넘어갑니다.
비어 있던 나가는 경로를 직접 추가합니다.
# 파드 a: 172.30.0.11로 가려면 eth0으로 내보내라
$ sudo ip netns exec lab-pod-a ip route add 172.30.0.11/32 dev eth0
# 파드 b: 반대 방향도
$ sudo ip netns exec lab-pod-b ip route add 172.30.0.10/32 dev eth0

$ sudo ip netns exec lab-pod-a ip route
172.30.0.11 dev eth0 scope link
via(게이트웨이) 없이 dev만 지정한 scope link는 "이 케이블 건너편에 그 대상이 직접 있다고 보고 보내라"는 뜻입니다. Cilium이 파드 라우팅을 구성할 때 쓰는 방식과 같습니다.
노드가 두 파드를 잇는 라우터가 된다
경로까지 추가했는데도 ping을 하면, 이번엔 메시지가 Network is unreachable에서 100% packet loss로 바뀝니다. 나갈 길이 없던 상태에서, 보냈는데 답이 없는 상태로 바뀐 것입니다. 파드 a의 ARP 주소록에 단서가 있습니다.
$ sudo ip netns exec lab-pod-a ip neigh
172.30.0.11 dev eth0  INCOMPLETE      # ARP 요청을 보냈지만 응답이 없음
INCOMPLETE는 "172.30.0.11이 누구냐"고 물었는데 아무도 답하지 않았다는 뜻입니다. 우리가 만든 케이블의 실제 배선을 보면 이유가 나옵니다.
  파드 a (eth0) ●━━━━━● lab-veth-a       lab-veth-b ●━━━━━● 파드 b (eth0)
                       └──[ 호스트 ]──┘
                          여기가 끊겨 있다
파드 a의 eth0은 lab-veth-a로, 파드 b의 eth0은 lab-veth-b로 이어지는데, lab-veth-a와 lab-veth-b는 서로 연결되어 있지 않습니다. 둘 다 호스트에 끝이 나와 있을 뿐입니다. 그래서 파드 a의 ARP 요청은 lab-veth-a까지 갔다가 거기서 멈춥니다.
이것이 앞에서 말한 "veth만으로는 파드 셋 이상을 못 잇는다"의 실제 모습입니다. 호스트 쪽 끝들을 이어 줄 무언가가 필요한데, 두 가지 방법이 있습니다. bridge로 묶거나, 아니면 호스트를 라우터로 만들어 중계시키는 것입니다. 우리는 후자를 택합니다. Chap2에서 "노드는 파드들의 공유기"라고 한 것을 직접 만드는 부분입니다.
# (1) 호스트가 패킷을 중계(forwarding)하도록 허용
$ sudo sysctl -w net.ipv4.ip_forward=1

# (2) 호스트 라우팅 테이블에 각 파드의 위치 등록
$ sudo ip route add 172.30.0.10/32 dev lab-veth-a
$ sudo ip route add 172.30.0.11/32 dev lab-veth-b

# (3) 호스트가 각 파드를 대신해 ARP에 응답 (proxy ARP)
$ sudo sysctl -w net.ipv4.conf.lab-veth-a.proxy_arp=1
$ sudo sysctl -w net.ipv4.conf.lab-veth-b.proxy_arp=1
(3)의 proxy ARP가 핵심입니다. 파드 a는 172.30.0.11이 eth0 건너편에 직접 있다고 보고 ARP를 보내지만, 실제로 거기엔 호스트(lab-veth-a)밖에 없습니다. proxy ARP는 호스트가 파드 a에게 "그건 나에게 보내라"고 대신 응답하게 합니다. 그러면 파드 a는 호스트로 패킷을 보내고, 호스트가 (2)의 라우팅을 따라 lab-veth-b를 거쳐 파드 b로 전달합니다.
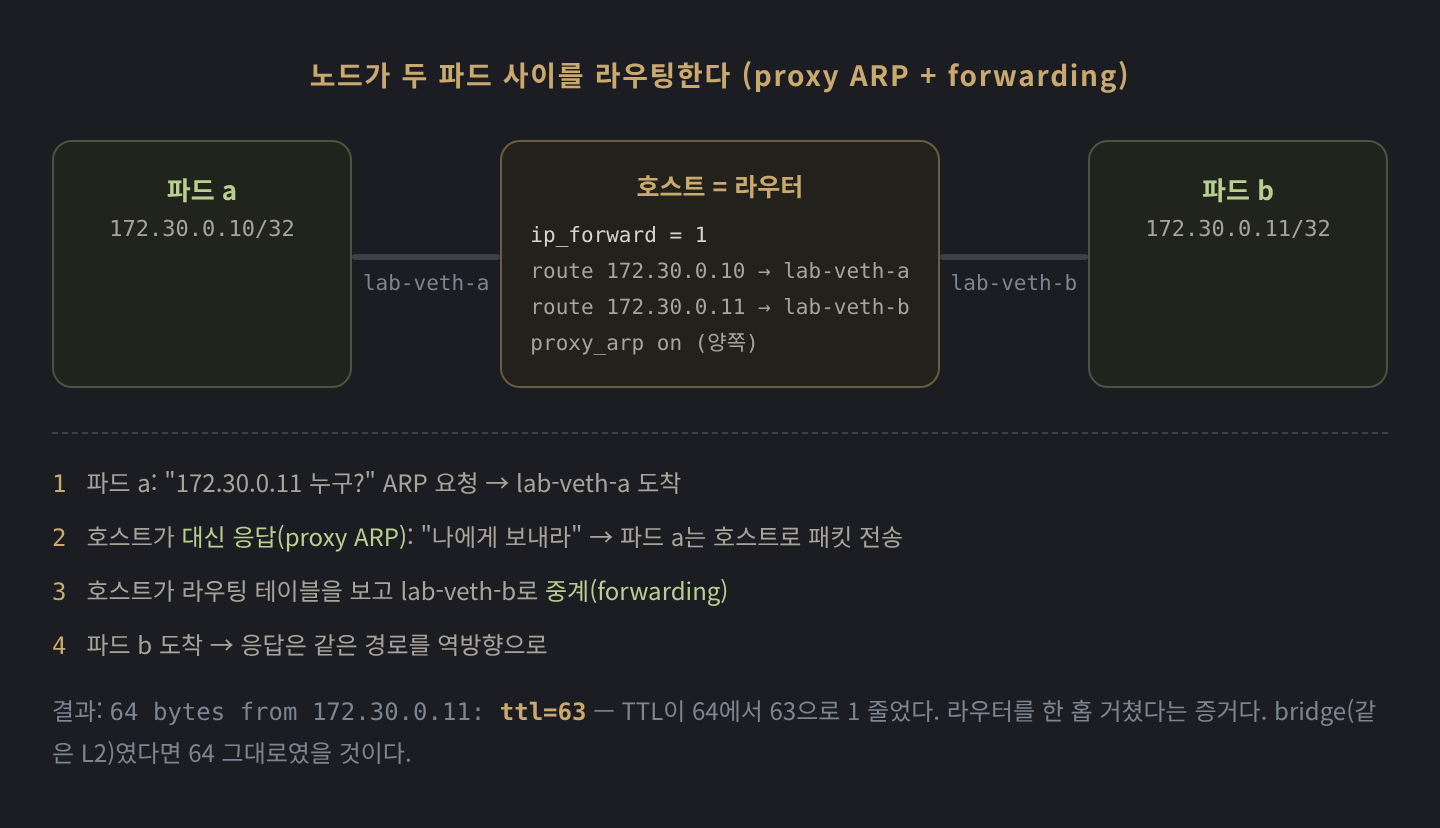
이제 ping이 통합니다.
$ sudo ip netns exec lab-pod-a ping -c 2 172.30.0.11
PING 172.30.0.11 (172.30.0.11) 56(84) bytes of data.
64 bytes from 172.30.0.11: icmp_seq=1 ttl=63 time=0.045 ms
64 bytes from 172.30.0.11: icmp_seq=2 ttl=63 time=0.039 ms
ttl=63을 눈여겨볼 만합니다. 파드가 보낼 때 TTL은 64인데 받은 쪽에서 63으로 줄었습니다. 호스트라는 라우터를 한 홉 거치면서 TTL이 1 깎인 것입니다. 만약 bridge로 묶었다면 같은 L2이므로 TTL이 64 그대로였을 것입니다. 이 숫자 하나가 우리가 만든 것이 스위치가 아니라 라우터라는 증거입니다. Chap2에서 노드를 공유기에 빗댄 이유가 여기에 있습니다. 노드는 파드망들 사이에서 패킷을 라우팅하는 L3 장비입니다.
한 가지 함정을 적어 둡니다. 위 실습을 깨끗한 호스트가 아니라 실제 Cilium이 돌고 있는 노드에서 그대로 하면, 설정이 모두 맞는데도 ping이 실패합니다. 진단해 보면 패킷은 호스트에 도착하고
iptables의 FORWARD 체인도 ACCEPT인데, 반대편 veth로 넘어가지 않습니다. 원인은 Cilium이 설치해 둔 eBPF 데이터패스입니다. Chap2에서 "eBPF가 갈아치우는 것은 netfilter(검문소)"라고 했는데, 이 노드에서 포워딩을 실제로 결정하는 주체가 iptables가 아니라 eBPF이기 때문에, iptables가 통과시키라고 해도 eBPF 단계에서 우리 트래픽이 처리되어 사라집니다. iptables 카운터에는 잡히지 않습니다. 맨손 네트워킹 실습을 Cilium이 점유하지 않은 환경에서 해야 하는 이유이자, iptables는 ACCEPT인데 패킷이 가지 않는다는 사실 자체가 eBPF가 이 노드 네트워킹의 실세임을 보여 줍니다.
우리가 손으로 한 것이 곧 CNI가 하는 일
netns 생성, veth pair 연결, /32 IP와 라우팅 부여, 호스트의 forwarding·proxy ARP 설정까지, 파드 두 개를 통신시키기까지 손으로 한 이 작업이 파드가 생성될 때마다 CNI 플러그인이 자동으로 하는 일입니다. 쿠버네티스가 파드를 스케줄하면 kubelet이 CNI를 호출하고, CNI(우리 클러스터에서는 Cilium)가 netns에 veth를 꽂고 IP를 할당하고 라우팅을 추가합니다. 우리가 직접 친 명령들의 자동화판인 셈입니다.
그러면 Cilium은 여기에 무엇을 더할까요. 우리는 호스트의 라우팅 테이블과 proxy ARP로 패킷을 중계했지만, Cilium은 같은 노드 안의 파드 간 통신에서는 이 커널 경로를 거치지 않고 eBPF로 목적지 케이블에 직접 패킷을 보냅니다. Chap2에서 본 "라우팅 표에는 cilium_host로 가라고 적혀 있는데 실제 배달은 lxc로 직행"하던 현상이 이것입니다.
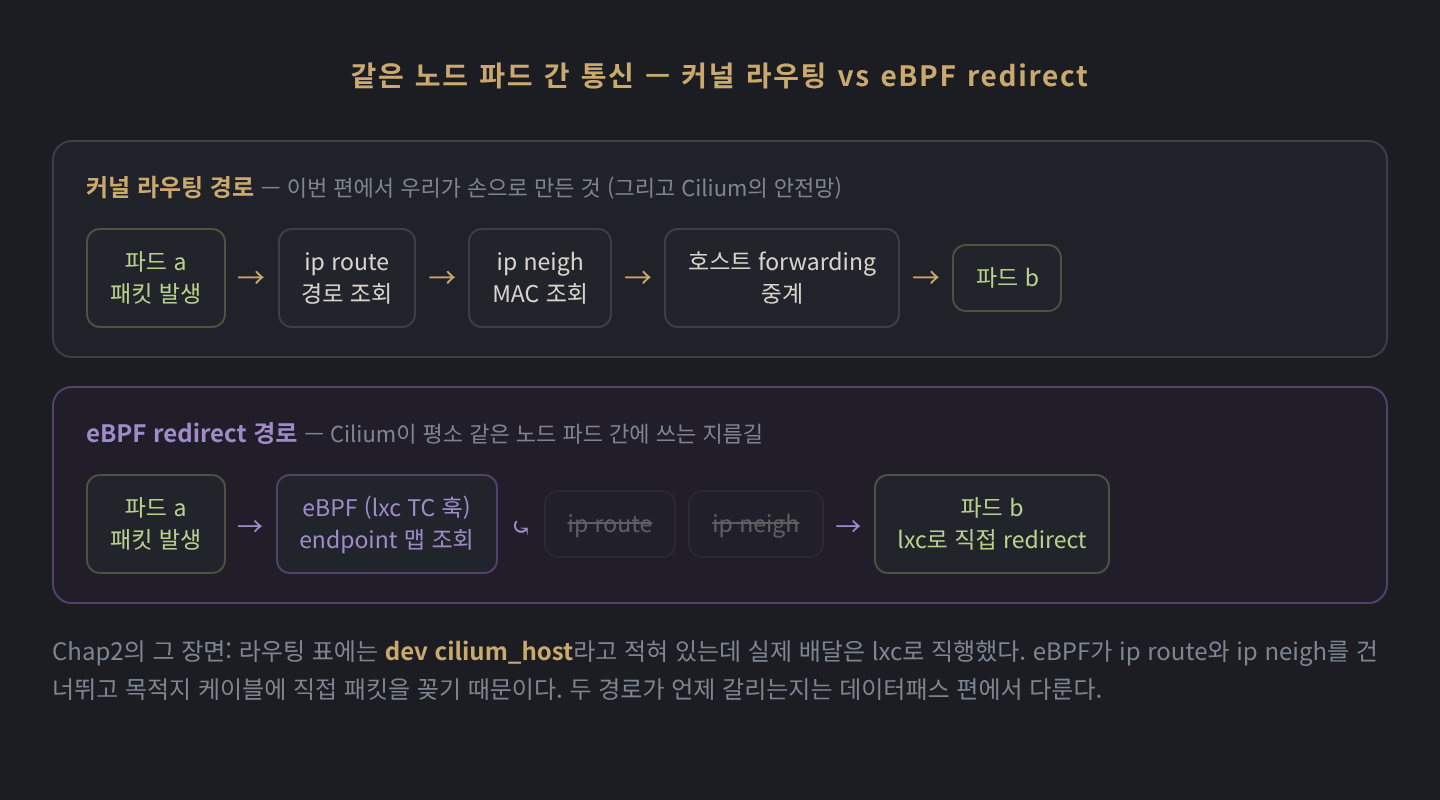
우리가 이번에 만든 것은 이 그림의 위쪽, 커널 라우팅 경로입니다. Cilium은 평소에는 아래쪽 eBPF 지름길로 다니고, 커널 라우팅은 그 지름길이 통하지 않을 때를 위한 안전망으로 남겨 둡니다. 두 경로가 정확히 언제 갈리는지, eBPF가 어떻게 라우팅과 ARP를 건너뛰면서도 노드 간 통신까지 처리하는지는 데이터패스 편에서 다루겠습니다.
TL;DR
- 파드의 격리된 네트워크 공간은 리눅스 network namespace다. 갓 만든 netns는 비활성
lo하나뿐인 빈 공간이다. - veth pair는 양 끝이 정해진 가상 케이블이다. 한쪽을 파드 netns에, 다른 쪽을 호스트에 두면 파드와 노드가 이어진다.
@ifN교차 표기가 케이블의 양 끝을 나타낸다. - 인터페이스 type 선택(veth, bridge, vxlan, dummy)이 CNI 데이터패스 설계를 좌우한다. veth와 라우팅은 native routing, bridge는 docker나 flannel, vxlan은 터널 모드다.
/32는 이웃이 없는 단독 주소라 connected route가 자동으로 생기지 않는다. 그래서 라우팅을 직접 추가해야 한다. 라우팅 테이블은 local(받는 쪽)과 main(보내는 쪽)으로 나뉜다.- veth만으로는 파드끼리 잇지 못한다. 호스트를 라우터로 만들어(forwarding, 경로, proxy ARP) 중계해야 한다.
ttl=63이 라우터를 거쳤다는 증거다. - 이 네 단계가 CNI가 파드마다 자동으로 하는 일이다. Cilium은 여기에 더해 같은 노드 파드 간 통신을 eBPF로 직접 처리해 커널 라우팅을 건너뛴다.
다음 편 예고
- 노드를 두 대로 늘려서, Chap2에서 읽었던 "다른 노드 파드망은 그 노드 IP로" 라우팅을 직접 재현하기
- 파드가 외부로 나갈 때의 변장(SNAT)을
iptables MASQUERADE로 걸어 보고, Chap3에서 본 conntrack 장부를 직접 만들어 보기