
노드 사이는 라우팅으로, 바깥은 변장으로
🔍 Cilium 스터디 시리즈
Chap4에서는 노드 한 대 안에서 파드 두 개를 만들고 서로 통신시켰습니다. 호스트를 라우터로 만들어 같은 노드 안의 두 파드를 잇는 데까지 갔습니다. 이번 편에서는 노드를 두 대로 늘립니다. 다른 노드에 있는 파드끼리 통신시키고(이것이 Chap2에서 읽었던 native routing입니다), 파드가 클러스터 바깥으로 나갈 때 일어나는 변장(SNAT)까지 직접 만들어 봅니다. 다 하고 나면 "노드 간 통신엔 변장이 없는데 바깥으로 나갈 땐 변장이 필요한" 비대칭이 왜 생기는지가 분명해집니다.
Chap4 마지막에 적었듯이, 실제 Cilium이 돌고 있는 노드의 host 네트워크 공간에서 이 실습을 하면 eBPF 데이터패스가 우리 트래픽을 가로채 막힙니다. 그래서 이번엔 깨끗한 우분투 VM 두 대를 준비했습니다. VM 한 대가 노드 한 대이고, 둘은 같은 물리망(
10.0.0.0/24)에 있습니다. node1은10.0.0.151, node2는10.0.0.152입니다.
노드 한 대 안은 Chap4 그대로다
먼저 각 VM 안에 파드를 하나씩 만듭니다. 이 부분은 Chap4에서 한 네 단계(netns 생성 → veth 연결 → /32 IP와 라우팅 → 호스트를 라우터로)와 똑같으므로, node1 쪽만 묶어서 보겠습니다.
# [node1, 10.0.0.151] 파드 a 만들기 (Chap4와 동일)
$ sudo ip netns add lab-pod-a
$ sudo ip link add lab-na type veth peer name eth0 netns lab-pod-a
$ sudo ip link set lab-na up
$ sudo ip -n lab-pod-a link set lo up
$ sudo ip -n lab-pod-a link set eth0 up
$ sudo ip -n lab-pod-a addr add 172.30.0.10/32 dev eth0
$ sudo ip -n lab-pod-a route add default dev eth0

# 노드를 라우터로
$ sudo sysctl -w net.ipv4.ip_forward=1
$ sudo sysctl -w net.ipv4.conf.lab-na.proxy_arp=1
$ sudo ip route add 172.30.0.10/32 dev lab-na
node2도 똑같이 하되, 파드 IP만 다른 대역을 씁니다. 여기가 Chap4와 갈리는 첫 지점입니다. node1의 파드는 172.30.0.10, node2의 파드는 172.31.0.10으로, 서로 다른 /24 대역에 둡니다. 노드마다 자기 파드 대역(파드 CIDR)을 통째로 분양받는 구조를 흉내 낸 것입니다. 우리 실제 클러스터의 IPAM도 노드당 /24(172.20.x.0/24)를 줍니다.
# [node2, 10.0.0.152] 파드 b — IP 대역만 172.31.x
$ sudo ip -n lab-pod-b addr add 172.31.0.10/32 dev eth0
# 나머지(netns, veth, forwarding, proxy_arp, 로컬 /32 route)는 node1과 동일
이 시점에서 각 노드는 자기 파드와는 통신할 수 있지만, 옆 노드의 파드로 가는 길은 모릅니다.
다른 노드의 파드는 어떻게 찾아가는가
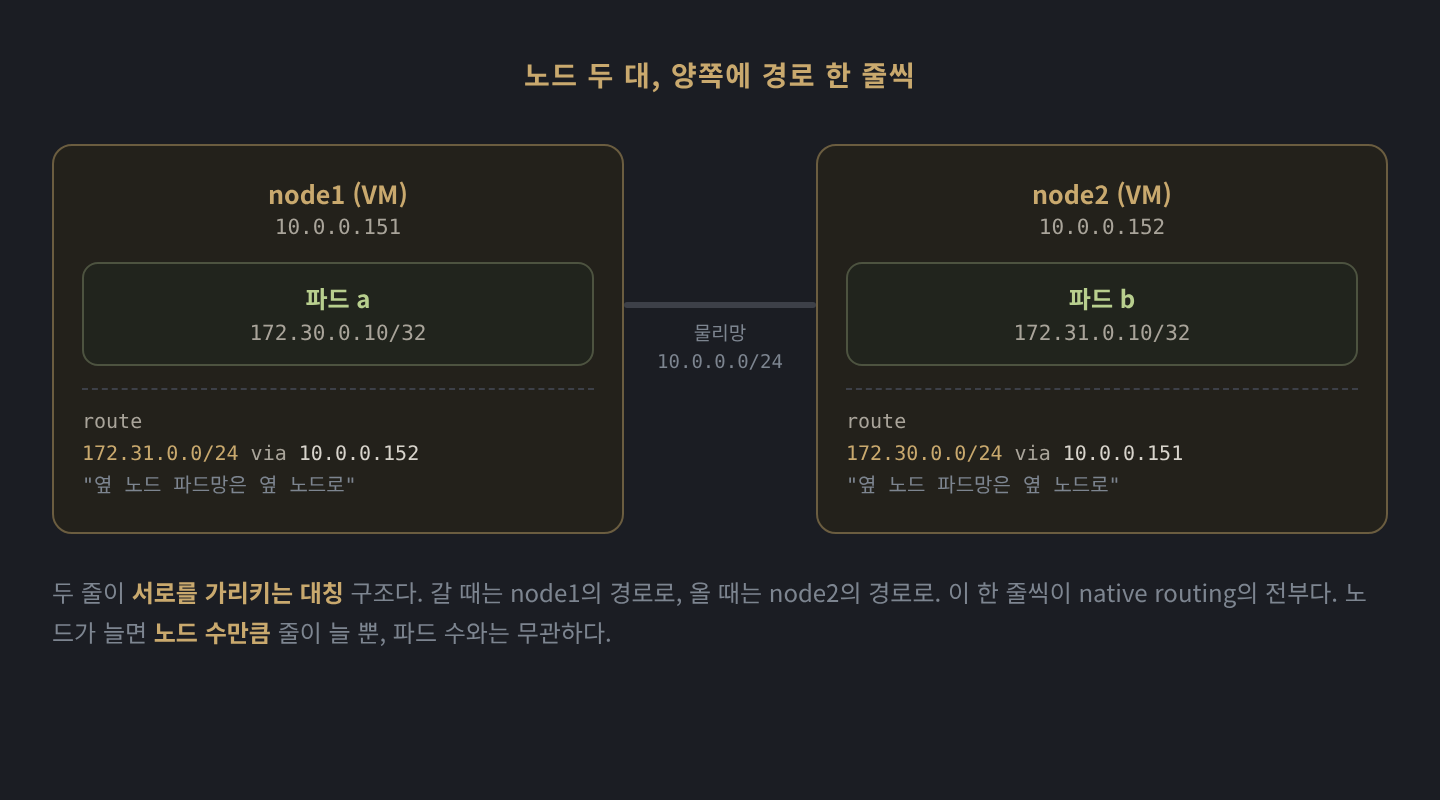
파드 a(172.30.0.10, node1)에서 파드 b(172.31.0.10, node2)로 가려면, node1이 "172.31.x 대역은 어디로 보내야 하는가"를 알아야 합니다. 답은 간단합니다. 그 대역을 가진 노드, 즉 node2(10.0.0.152)로 보내면 됩니다. 양쪽 노드에 경로를 한 줄씩 추가합니다.
# [node1] "172.31.0.0/24 대역은 node2로 보내라"
$ sudo ip route add 172.31.0.0/24 via 10.0.0.152

# [node2] "172.30.0.0/24 대역은 node1으로 보내라"
$ sudo ip route add 172.30.0.0/24 via 10.0.0.151
이 두 줄이 native routing의 전부입니다. Chap2에서 "다른 노드 파드망은 그 노드 IP로"라고 읽었던 그 줄을 직접 깐 것입니다.
이제 크로스 노드 ping이 통합니다.
# [node1]
$ sudo ip netns exec lab-pod-a ping -c 3 172.31.0.10
PING 172.31.0.10 (172.31.0.10) 56(84) bytes of data.
64 bytes from 172.31.0.10: icmp_seq=1 ttl=62 time=849 ms
64 bytes from 172.31.0.10: icmp_seq=2 ttl=62 time=0.598 ms
64 bytes from 172.31.0.10: icmp_seq=3 ttl=62 time=0.773 ms
두 가지를 눈여겨볼 만합니다. 첫째, 첫 패킷만 유독 느리고(849ms) 이후는 1ms 미만입니다. 이것은 Chap3에서 본 "ping 첫 RTT에 ARP가 숨어 있다"와 같은 현상인데, 이번엔 양쪽 노드가 서로의 MAC을 ARP로 알아내는 과정이 한 번 더 끼어 있어 더 큽니다. 한 번 주소록이 채워지면 이후는 빨라집니다.
둘째, ttl=62입니다. 파드가 보낼 때 TTL은 64인데 도착했을 땐 62로 줄었습니다. node1과 node2, 라우터를 두 번 거치면서 한 홉마다 1씩 깎인 것입니다. Chap4의 단일 노드 때는 라우터를 한 번만 거쳐 ttl=63이었으니, TTL이 정확히 두 홉만큼 줄어든 이번 결과는 패킷이 노드 두 대를 실제로 건넜다는 뜻입니다.
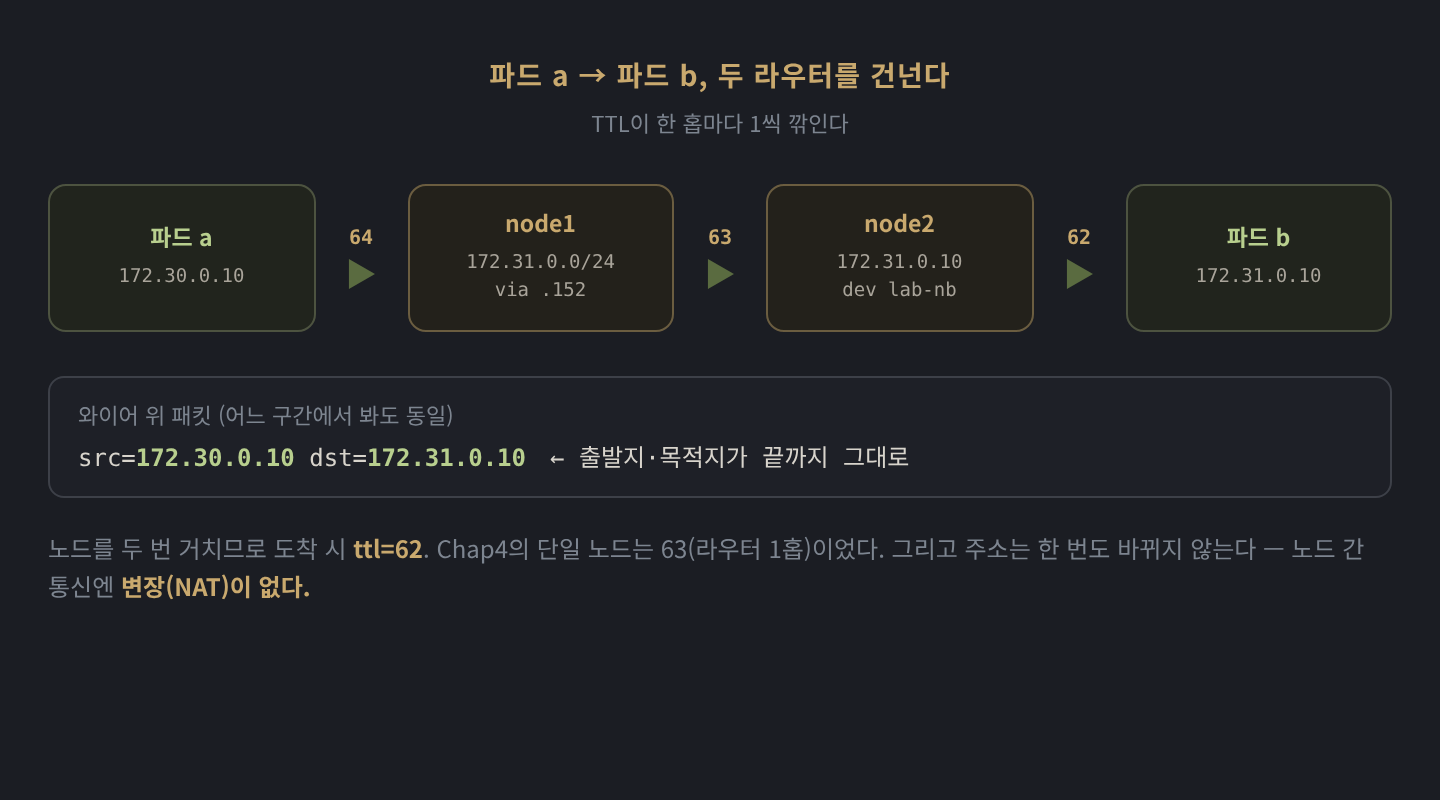
그리고 한 가지 더 중요한 점이 있습니다. node2에서 들어오는 패킷을 들여다보면, 출발지가 파드의 원래 IP 그대로입니다.
# [node2] 들어오는 ICMP의 출발지 확인 (node1에서 ping을 흘리는 동안)
$ sudo tcpdump -ni eth0 icmp
IP 172.30.0.10 > 172.31.0.10: ICMP echo request, ...
출발지가 172.30.0.10, 즉 파드 a의 진짜 IP입니다. 노드를 두 번 건넜는데도 아무도 주소를 바꾸지 않았습니다. 노드 간 파드 통신에는 변장(NAT)이 없다는 뜻이고, 이 점이 잠시 뒤 외부행과 대비됩니다.
라우팅 테이블은 트래픽으로 배우지 않는다
여기서 실습 중에 이런 질문이 나왔습니다.
node2가 node1에서 온 요청을 받으면, "아,
172.30.0.10은 node1 쪽에 있구나" 하고 라우팅 테이블을 자동으로 갱신하지 않나요? 그러면 굳이 경로를 손으로 안 넣어도 되지 않나요?
직관적인 생각이지만, 답은 아니오입니다. 리눅스 커널은 들어온 데이터 패킷을 보고 라우팅 경로를 만들지 않습니다. 경로는 수동 추가, 인터페이스에 IP를 붙일 때 자동 생기는 connected route, 또는 BGP 같은 라우팅 데몬, 이 세 군데서만 옵니다. "어떤 출발지에서 패킷이 왔으니 그쪽으로 가는 길을 깔자"는 동작은 없습니다. 출발지는 위조할 수 있으니, 그걸 믿고 경로를 만들면 라우팅이 오염되기 때문입니다.
동적으로 채워지는 것이 있긴 합니다. ARP 주소록(neighbor 캐시)은 패킷이 오갈 때 자동으로 채워집니다. 하지만 그것은 "같은 망에 있는 이 IP의 MAC이 무엇이냐"를 푸는 L2 작업일 뿐, 원격 대역으로 가는 경로(L3)를 만들어 주지는 않습니다. 둘은 다른 층의 이야기입니다.
증거는 간단합니다. node2의 경로를 지우고 다시 ping을 해 보면 됩니다.
# [node2] 역방향 경로를 지운다
$ sudo ip route del 172.30.0.0/24 via 10.0.0.151

# [node1] 다시 ping
$ sudo ip netns exec lab-pod-a ping -c 3 172.31.0.10
PING 172.31.0.10 (172.31.0.10) 56(84) bytes of data.

--- 172.31.0.10 ping statistics ---
3 packets transmitted, 0 received, 100% packet loss
곧장 깨집니다. 갈 때(node1 → node2 → 파드 b)는 멀쩡한데, 파드 b가 보낸 응답이 돌아올 길이 없어서입니다. node2는 목적지 172.30.0.10에 맞는 경로가 없으니 기본 경로로 흘려보내고, 기본 게이트웨이는 사설 파드 대역을 모르므로 버립니다. 트래픽이 오가도 경로는 저절로 생기지 않는다는 것이 이렇게 드러납니다.
그러면 실제 클러스터에서는 노드마다 이 경로를 누가 깔까요. 데이터 패킷이 아니라 컨트롤 플레인이 미리 깝니다. 우리 클러스터처럼 모든 노드가 같은 L2에 있으면 Cilium agent가 auto-direct-node-routes 기능으로 각 노드의 파드 CIDR을 자동으로 경로에 넣습니다. 노드들이 서로 다른 서브넷에 흩어져 있으면 BGP 같은 라우팅 프로토콜로 분배합니다. 어느 쪽이든 트래픽을 보고 배우는 것이 아니라 토폴로지를 알고 미리 까는 방식입니다. 우리가 손으로 친 그 두 줄이, agent가 자동으로 하는 일의 수동판인 셈입니다.
로컬은 /32, 옆 노드는 /24
경로를 다시 복구하고(sudo ip route add 172.30.0.0/24 via 10.0.0.151), node1의 라우팅 테이블에서 파드 관련 줄을 보면 두 종류가 섞여 있습니다. 실습 중에 이 차이에 대한 질문도 나왔습니다.
파드 IP는
172.30.0.10/32처럼/32로 주면서, 왜 옆 노드 경로는172.31.0.0/24처럼/24로 쓰나요? 파드는 IP 하나뿐인데요.
/32와 /24가 가리키는 것이 다르기 때문입니다. 파드에 붙인 172.30.0.10/32는 주소 할당입니다. "나는 이웃 없는 단독 호스트"라는 뜻이죠(Chap4에서 본 그 /32). 반면 경로의 172.31.0.0/24는 파드 IP가 아니라 node2가 통째로 가진 파드 대역을 가리킵니다. 파드 한 개가 아니라 그 노드가 책임지는 블록 전체입니다.
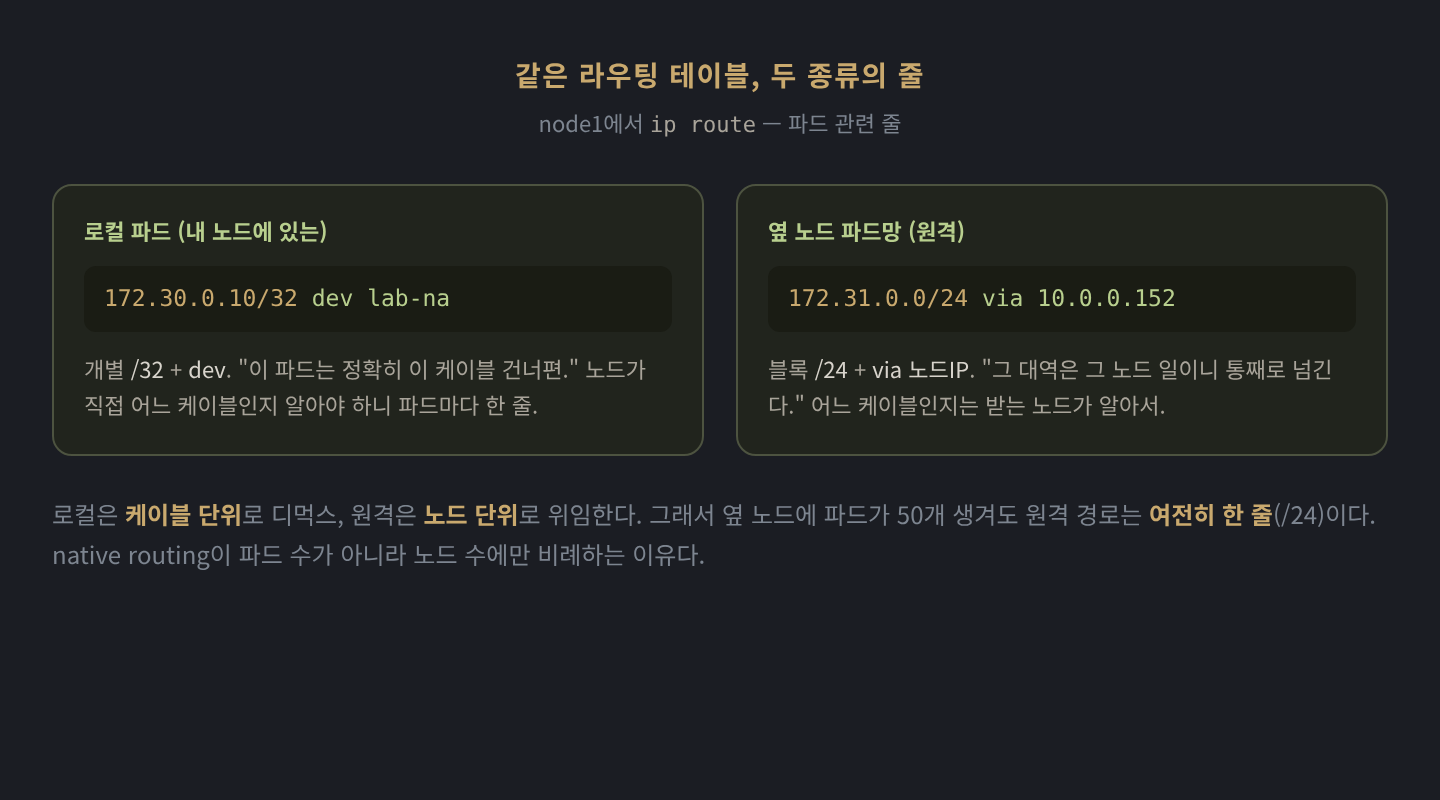
그래서 한 노드의 라우팅 테이블 안에서도 로컬과 원격이 다른 모양을 가집니다. 로컬 파드는 172.30.0.10/32 dev lab-na처럼 개별 /32에 dev로, "이 파드는 정확히 이 케이블 건너편"이라고 콕 집습니다. 노드가 어느 케이블로 보낼지 직접 알아야 하니 파드마다 한 줄입니다. 반면 옆 노드 파드망은 172.31.0.0/24 via 10.0.0.152처럼 블록 /24에 via 노드IP로, "그 대역은 그 노드 일이니 통째로 넘긴다"가 됩니다. 어느 케이블인지는 받는 노드가 알아서 합니다.
이 차이가 native routing의 확장성을 만듭니다. 옆 노드에 파드가 50개 생겨도 node1의 원격 경로는 여전히 /24 한 줄입니다. 경로가 파드 수가 아니라 노드 수에만 비례하는 것입니다. Chap2에서 "native routing은 6줄이 전부"라고 했던 그 6줄이 이것입니다.
파드가 바깥으로 나갈 때: 변장
방금 우리는 node2의 역방향 경로를 지우면 ping이 깨지는 것을 봤습니다. 그런데 이 "역방향 경로가 없는 상황"이 사실 파드가 클러스터 바깥(인터넷)으로 나갈 때 늘 마주치는 상황입니다. 바깥의 라우터들은 우리 사설 파드 대역(172.30.0.0/24)으로 가는 길을 모르니까요. 그래서 역방향 경로를 지운 채로, 이번엔 다른 방법으로 통신을 살려 봅니다. 변장입니다.
node2 경로는 지운 상태 그대로 두고, node1에 MASQUERADE 규칙을 겁니다.
# [node1] pod-a가 172.31 대역으로 나갈 때 출발지를 노드 IP로 변장
$ sudo iptables -t nat -A POSTROUTING -s 172.30.0.0/24 -d 172.31.0.0/24 -j MASQUERADE

# [node1] 다시 ping — 역방향 경로를 안 살렸는데도
$ sudo ip netns exec lab-pod-a ping -c 3 172.31.0.10
64 bytes from 172.31.0.10: icmp_seq=1 ttl=62 time=55.0 ms
64 bytes from 172.31.0.10: icmp_seq=2 ttl=62 time=0.363 ms
깨졌던 ping이 되살아납니다. node2의 파드 대역 경로는 여전히 없는데도요. 무엇이 달라졌는지 node2에서 들어오는 패킷을 다시 보면 알 수 있습니다.
# [node2] (node1에서 ping을 흘리는 동안)
$ sudo tcpdump -ni eth0 icmp
IP 10.0.0.151 > 172.31.0.10: ICMP echo request, ...
IP 172.31.0.10 > 10.0.0.151: ICMP echo reply, ...
출발지가 172.30.0.10(파드)이 아니라 10.0.0.151(node1의 IP) 로 바뀌었습니다. 이것이 변장입니다. 출발지를 노드 IP로 바꾸면, node2는 파드 대역 경로가 없어도 응답을 돌려보낼 수 있습니다. 10.0.0.151은 같은 물리망(10.0.0.0/24)에 직접 붙어 있어, 인터페이스에 IP를 줄 때 자동으로 생긴 connected route만으로 곧장 닿기 때문입니다. 우리가 지운 것은 파드 대역 경로였지 물리망 경로가 아니었습니다.
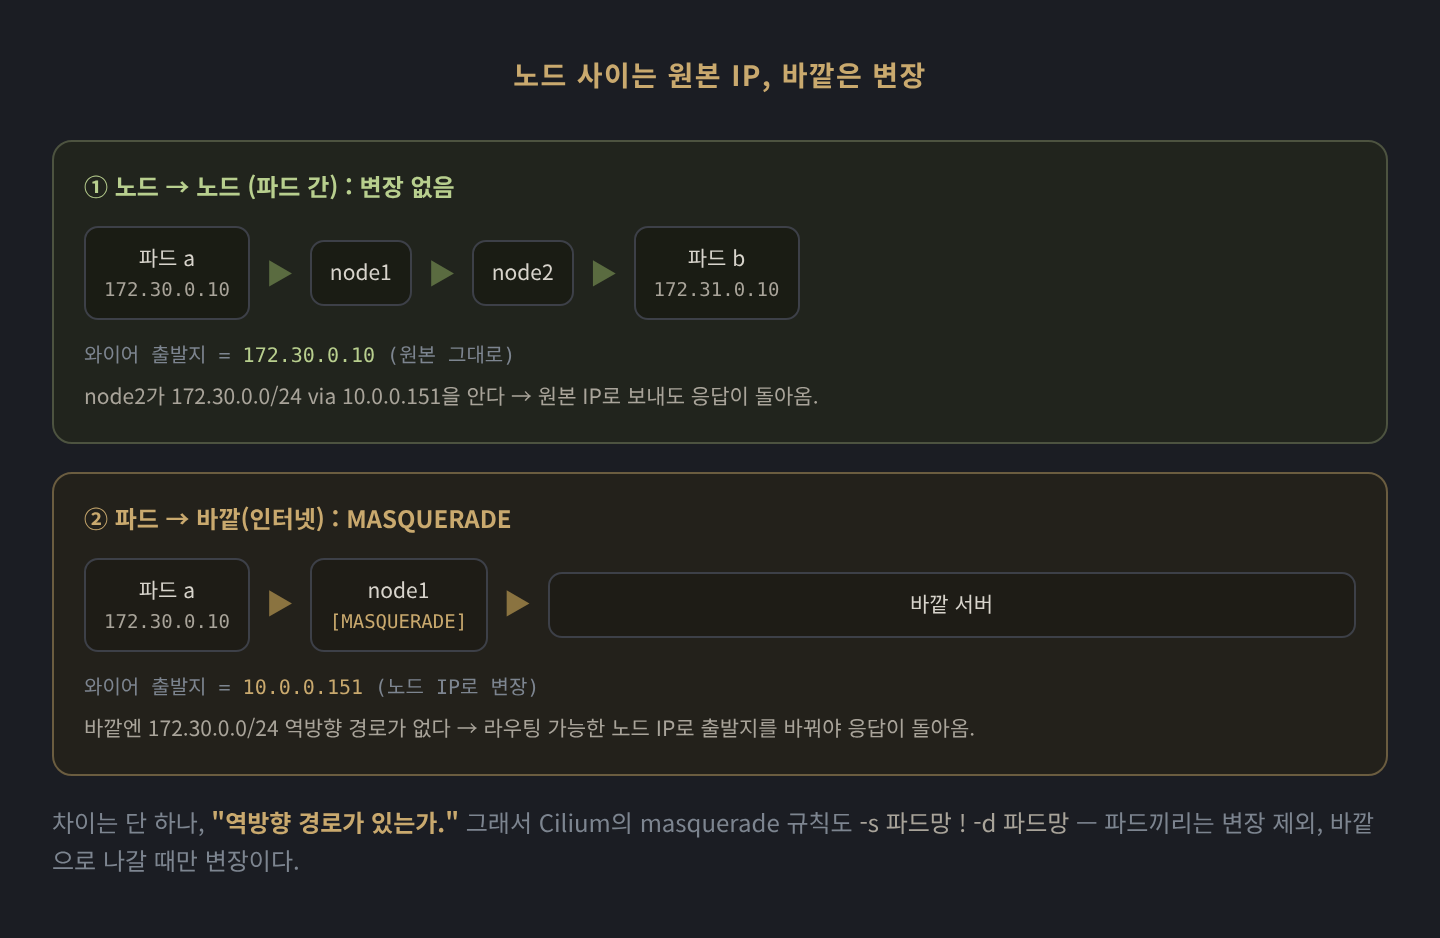
여기서 처음에 말한 비대칭이 완성됩니다. 노드 간 통신에서는 양쪽 노드가 서로의 파드 대역 경로를 알고 있으니, 원본 IP 그대로 보내도 응답이 돌아옵니다. 변장이 필요 없습니다. 하지만 바깥으로 나갈 때는 바깥에 우리 파드 대역으로 오는 경로가 없으니, 출발지를 라우팅 가능한 노드 IP로 바꿔야만 응답이 돌아옵니다. 차이는 단 하나, "응답이 돌아올 역방향 경로가 있는가"입니다. 실제 Cilium의 masquerade 규칙이 -s 파드망 ! -d 파드망(파드끼리는 제외, 바깥으로 나갈 때만)인 이유가 여기 있습니다. 우리가 방금 그 조건의 양쪽을 직접 만들어 본 셈입니다.
변장은 어떻게 돌아오는 길까지 책임지는가
출발지를 바꿔서 내보내는 것만으로는 절반입니다. 응답이 10.0.0.151로 돌아왔을 때, node1은 그것이 원래 파드 a의 것이었음을 알아야 다시 172.30.0.10으로 되돌릴 수 있습니다. 그 기억을 담는 것이 conntrack(연결 추적) 장부입니다.
# [node1] ping이 흐르는 동안 조회 (멈추면 ICMP 항목은 곧 만료된다)
$ sudo conntrack -L | grep icmp
icmp 1 ... src=172.30.0.10 dst=172.31.0.10 ... src=172.31.0.10 dst=10.0.0.151 ...
두 번째 묶음(reply 튜플)이 핵심입니다. dst=10.0.0.151 — "이 연결의 응답은 10.0.0.151로 올 것이고, 그러면 원래 출발지로 되돌려라"라고 적혀 있습니다. 만약 변장이 없었다면 reply의 dst는 원본인 172.30.0.10이었을 것입니다. 이 한 줄의 차이가 "여기서 출발지 변환이 일어났다"는 시각적 표시입니다.
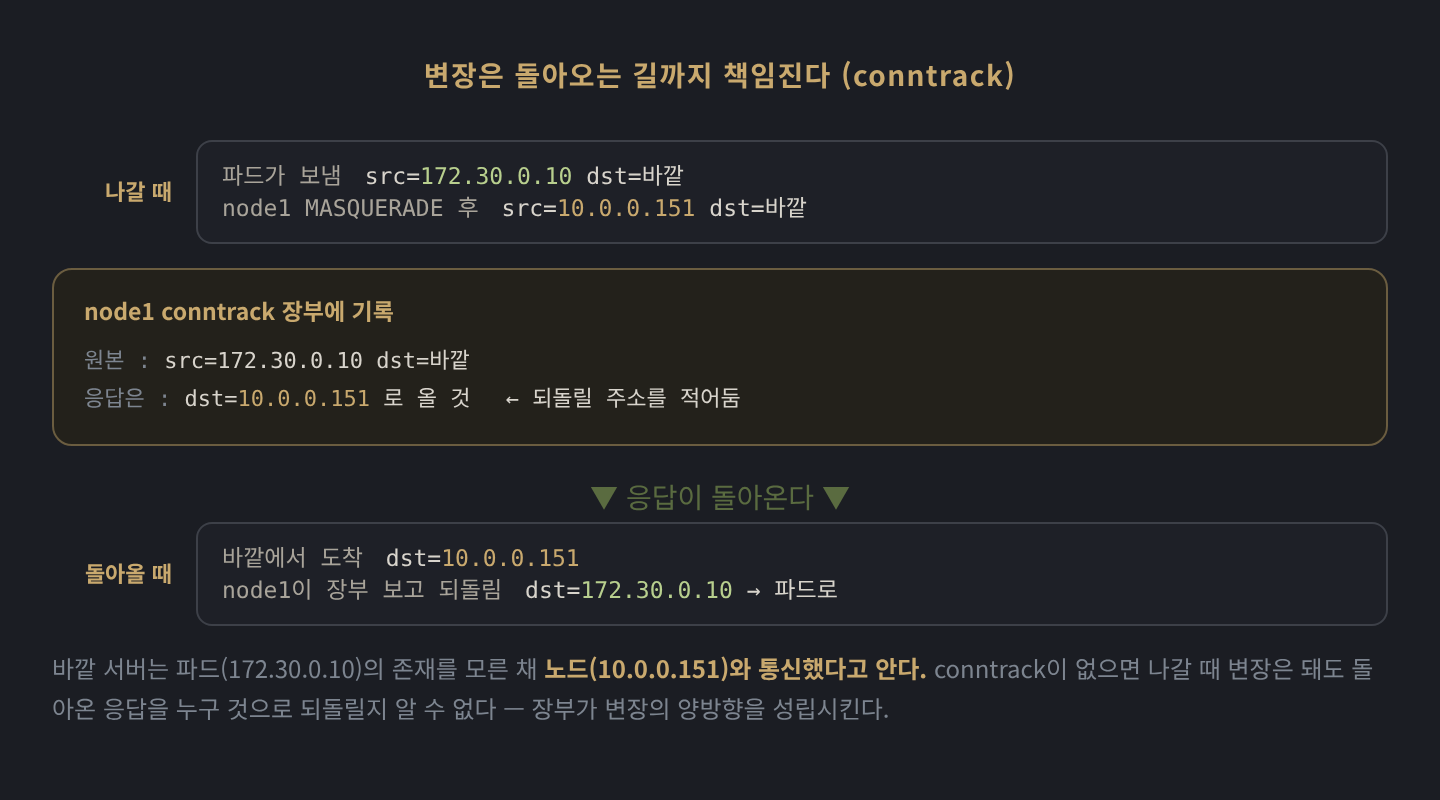
부수적으로 드러나는 사실도 있습니다. node2에서 본 응답은 172.31.0.10 > 10.0.0.151이었습니다. 즉 목적지(파드 b)는 파드 a의 존재를 모른 채 "노드 10.0.0.151과 통신했다"고 인식합니다. 이것이 실무에서 자주 만나는 현실의 축소판입니다. 파드가 외부 서비스에 접속하면 그 서비스 로그에는 파드 IP가 아니라 노드 IP가 찍힙니다. 방금 그 동작을 손으로 재현한 것입니다.
conntrack과 tcpdump는 둘 다 흐르는 트래픽을 봐야 하는 관찰 도구입니다. ping을 멈춘 상태에서 조회하면 ICMP 연결 항목은 수명(약 30초)이 지나 사라지므로 빈 결과가 나옵니다. 위 명령들은 모두 ping이 흐르는 동안 실행한 것입니다.
우리가 손으로 한 것이 곧 Cilium이 하는 일
이번 편에서 한 작업을 정리하면 두 가지입니다.
- 노드마다 옆 노드의 파드 대역으로 가는 경로를 한 줄씩 추가 — native routing
- 파드가 바깥으로 나갈 때 출발지를 노드 IP로 변장 — SNAT(MASQUERADE)
1번은 Cilium agent가 auto-direct-node-routes(같은 L2일 때)나 BGP(L3로 분리됐을 때)로 자동화하는 일입니다. 노드 수만큼의 경로를, 노드가 뜨고 질 때마다 자동으로 넣고 뺍니다. 2번은 Cilium이 iptables MASQUERADE 또는 eBPF 기반 masquerade로 처리하는 일이고, 우리가 만든 ! -d 파드망 조건도 그대로 가집니다.
우리 클러스터는 모든 노드가 같은 10.0.0.0/24에 있어 native routing + auto-direct-node-routes로 충분하고, 그래서 BGP는 켜져 있지 않습니다. 노드들이 서로 다른 서브넷에 흩어진 환경이라면 BGP로 파드 대역을 분배해야 하는데, 그 이야기는 따로 다룰 주제입니다.
그리고 한 가지가 더 남아 있습니다. 지금까지 우리는 모든 것을 커널의 라우팅 테이블과 proxy ARP, iptables로 했습니다. 그런데 Cilium은 같은 노드 안의 파드 간 통신에서는 이 커널 경로를 거치지 않고 eBPF로 목적지 케이블에 곧장 패킷을 보낸다고 Chap4에서 예고했습니다. 그 eBPF가 대체 무엇이고 어디에 어떻게 끼어드는지를, 다음 편부터 들여다봅니다.
TL;DR
- 노드를 두 대로 늘려도 native routing의 핵심은 경로 한 줄이다. 각 노드에 "옆 노드의 파드 대역은 그 노드 IP로"를 추가하면 끝이다.
- 크로스 노드 ping의
ttl=62는 라우터(노드)를 두 번 거쳤다는 증거다. 단일 노드는 63이었다. - 노드 간 통신은 출발지 IP를 바꾸지 않는다. 양쪽이 서로의 파드 대역 경로를 알기 때문에 변장이 필요 없다.
- 커널 라우팅은 트래픽으로 학습하지 않는다. 경로는 컨트롤 플레인(Cilium agent의 auto-direct-node-routes, BGP)이 미리 깐다. ARP 주소록만 동적으로 채워질 뿐 경로는 아니다.
- 라우팅 테이블에서 로컬 파드는
/32 dev(케이블 단위), 옆 노드 파드망은/24 via 노드IP(노드 단위)다. 그래서 경로가 파드 수가 아니라 노드 수에만 비례한다. - 파드가 바깥으로 나갈 땐 출발지를 노드 IP로 변장(MASQUERADE)한다. 바깥엔 사설 파드 대역으로 오는 역방향 경로가 없기 때문이다. conntrack 장부가 돌아온 응답을 다시 파드로 되돌린다.
다음 편 예고
- 지금까지 커널의 라우팅과 iptables로 한 모든 일을, Cilium은 eBPF로 한다. eBPF가 무엇인지, 커널 어디에 어떻게 프로그램을 끼워 넣는지부터 시작하기
- Chap1에서 예고한 XDP early-drop(DDoS 방어)을 포함해, eBPF가 패킷 경로의 어느 지점에서 결정을 내리는지 지도 그리기